Model & perbandinganPerbandingan
Biaya sesi agen: 50 langkah pada GLM, DeepSeek atau MiniMax
Hitung berapa biaya sesi agen 50 langkah ketika riwayat dikirim ulang setiap langkah, lalu pilih antara GLM-5.3-Flash, DeepSeek-V4-Flash dan MiniMax-M2.7.
Di halaman ini
Agen Anda berjalan selama sepuluh menit, dan tagihannya lebih besar daripada tugasnya. Tidak ada yang aneh: setiap langkah mengirim ulang seluruh riwayat, sehingga sisi input tumbuh di setiap langkah dan akhirnya menjadi sebagian besar biaya. Dengan angka di bawah, sesi 50 langkah mengirim 885.000 token input dan menulis 40.000. Pilih model berdasarkan seberapa jauh riwayat akan tumbuh dan seberapa panjang satu jawaban harus dibuat, lalu periksa totalnya di tabel.
Mengapa langkah 50 lebih mahal daripada langkah 1#
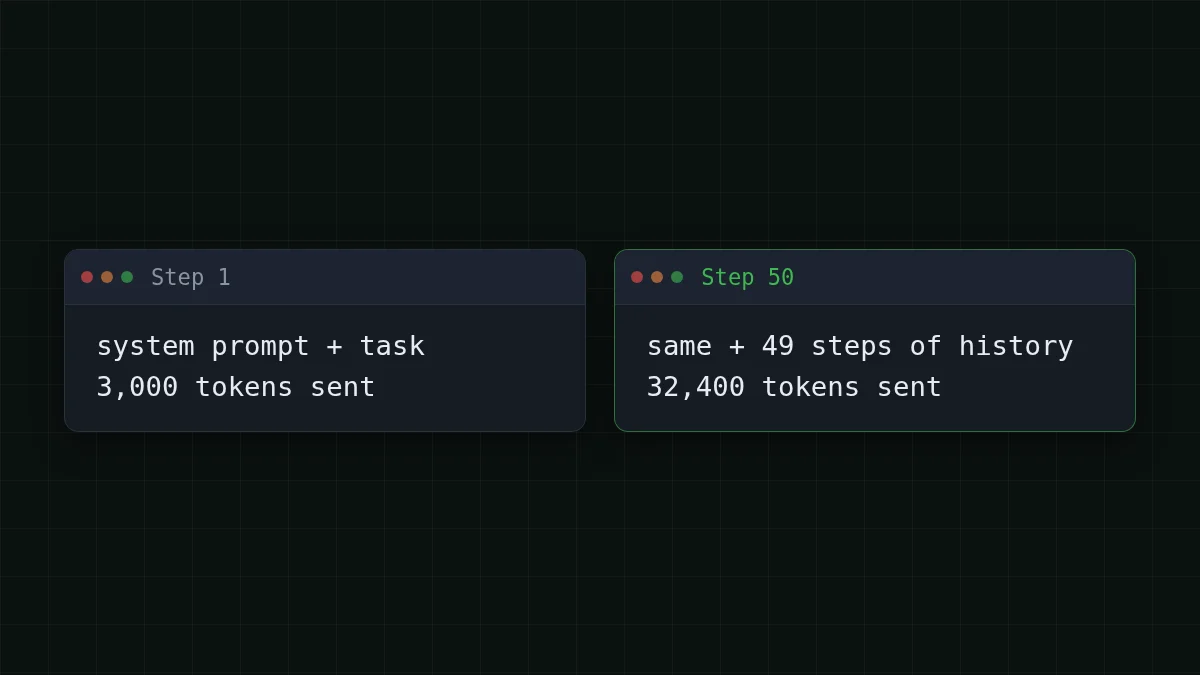
Model tidak mengingat apa pun di antara panggilan. Untuk melanjutkan tugas, agen mengirim semuanya lagi: instruksi, setiap langkah sebelumnya, dan apa yang dihasilkan langkah terakhir. Langkah 1 mengirim konteks awal. Langkah 50 mengirim konteks awal ditambah 49 langkah riwayat. Jika ide ini baru bagi Anda, mengapa agen AI menggunakan begitu banyak token membahas contoh 20 langkah.
Katakanlah agen dimulai dengan 3.000 token (system prompt, tugas, beberapa file) dan setiap langkah menambahkan sekitar 600 token ke riwayat: agen menyimpan catatan ringkas tentang apa yang dilakukannya dan lihat, dan membuang sisanya. Langkah 50 kemudian mengirim 3.000 + 600 × 49 = 32.400 token. Jawabannya tetap sekitar 800 token per langkah. Pertanyaannya terus tumbuh; jawabannya tidak.
Jumlah 50 langkah#
Sebelum menghitung, coba tebak.
Tebak angkanya
Berapa banyak token input yang dikirim seluruh sesi 50 langkah?
Tebakan Anda
02.000.000
Tampilkan jawaban
Jawaban: 885.000
Sekitar 885.000. Langkah k mengirim 3.000 + 600 × (k − 1) token, dan selama 50 langkah jumlahnya menjadi 885.000 — lebih dari dua puluh kali lipat 40.000 token yang ditulis agen.
Jumlahnya, dalam urutan yang akan Anda lakukan di atas kertas:
- Konteks awal dikirim 50 kali: 50 × 3.000 = 150.000.
- Nomor langkah 0 sampai 49 berjumlah 49 × 50 ÷ 2 = 1.225, dan setiap unit adalah 600 token riwayat: 600 × 1.225 = 735.000.
- Total input: 150.000 + 735.000 = 885.000.
- Total output: 50 × 800 = 40.000.
Riwayat adalah 735.000 dari 885.000, dan tumbuh lebih cepat daripada jumlah langkah. Gandakan tugas menjadi 100 langkah: 99 × 100 ÷ 2 = 4.950, jadi riwayatnya adalah 600 × 4.950 = 2.970.000 dan konteks awalnya adalah 100 × 3.000 = 300.000, sehingga totalnya 3.270.000 token input. Dua kali langkah, hampir empat kali input. Output hanya berlipat ganda: 100 × 800 = 80.000.
Berapa biaya sesi pada setiap model#
Permintaan ditagih untuk input dan output bersama-sama, jadi bandingkan totalnya. Dihitung dengan cara itu, ketiga model totalnya lebih murah daripada OpenRouter untuk beban ini; kolom OpenRouter di tabel menunjukkannya. Harga bersifat langsung, jadi tabel tetap terkini.
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
Total 885.000 token input dan 40.000 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Bacalah dari sisi input. Sekitar 96 dari setiap 100 token dalam sesi ini adalah input, jadi harga input menentukan sebagian besar total. Input per 1 juta token hari ini: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
Dan penggandaannya, pada DeepSeek-V4-Flash:
Sekarang beban Anda sendiri. Langkah rata-rata dalam contoh kami mengirim 885.000 ÷ 50 = 17.700 token input dan menulis 800. Lima tugas seperti itu dalam sehari adalah 5 × 50 = 250 langkah. Ubah angkanya menjadi milik Anda; kalkulator menjumlahkan selama langkah-langkah dengan harga langsung.
Kalkulator biaya
Lima tugas 50 langkah dalam satu hari
Token input per permintaan: 17.700 · Token output per permintaan: 800 · Permintaan per hari: 250
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
Apakah riwayat muat di jendela?#
Biaya adalah satu batasan. Yang lain adalah jendela: permintaan yang lebih besar dari konteks model tidak dapat dikirim sama sekali. Katalog model CheapTokens (4 November 2026) mencantumkan batasan ini:
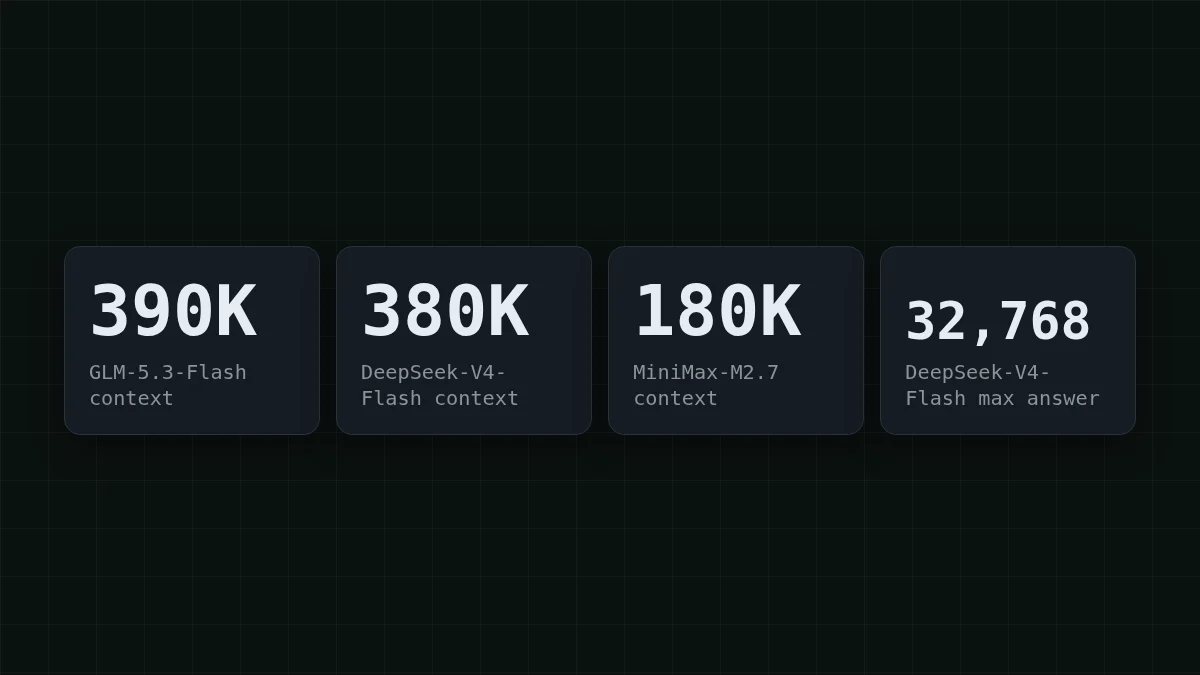
Dengan pertumbuhan 600 token per langkah, riwayat saja mendekati jendela setelah banyak langkah: MiniMax-M2.7 pada sekitar langkah 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash pada sekitar langkah 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash pada sekitar langkah 640 (3.000 + 600 × 639 = 386.400). Sesi 50 langkah menggunakan sebagian kecil dari salah satunya.
Sesi nyata lebih kasar. Jika suatu langkah menempelkan log besar dan menambahkan 6.000 token alih-alih 600, 180K MiniMax-M2.7 berakhir sekitar langkah 30: 3.000 + 6.000 × 29 = 177.000. Tugas yang sama muat di jendela yang lebih besar jauh lebih lama.
Batas jawaban bekerja sebaliknya. GLM-5.3-Flash dan MiniMax-M2.7 menulis hingga 8.192 token per jawaban, DeepSeek-V4-Flash hingga 32.768. Katakanlah satu langkah harus menghasilkan laporan 10.000 token. Pada batas 8.192, balasan berhenti di batas dan finish_reason mengatakan length; pada DeepSeek-V4-Flash itu muat dalam satu jawaban.
Jumlah yang sama untuk bot dukungan#
Bot dukungan adalah loop yang sama dengan manusia di dalamnya. Katakanlah percakapan berjalan 30 giliran, system prompt dan aturan memakan 1.000 token, dan setiap giliran menambahkan 300 token ke riwayat (100 dari pelanggan, 200 dari bot).
- Konteks awal, 30 kali: 30 × 1.000 = 30.000.
- Riwayat: 29 × 30 ÷ 2 = 435 unit dari 300 token, jadi 300 × 435 = 130.500.
- Total input: 30.000 + 130.500 = 160.500.
- Total output: 30 × 200 = 6.000.
Satu percakapan seperti itu biayanya $0.0035 pada GLM-5.3-Flash, $0.003 pada DeepSeek-V4-Flash dan $0.0089 pada MiniMax-M2.7. Bentuknya sama: sekitar 96 dari setiap 100 token adalah input. Bot dengan ribuan percakapan sehari merasakan ini di minggu pertama, dan memangkas riwayat adalah tuasnya. Sliding window atau ringkasan menunjukkan caranya.
Ukur sesi Anda sendiri#
Asumsi di atas adalah angka bulat. Agen Anda punya asumsinya sendiri, dan API memberi tahu Anda dengan tepat: setiap respons membawa objek usage dengan token input dan output dari panggilan itu. Loop ini memiliki bentuk yang sama dengan agen tanpa alat: riwayat tumbuh, seluruh daftar dikirim ulang. Ini adalah contoh; ganti prompt dengan tugas Anda.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Angka tengah pada setiap baris yang dicetak adalah input dari panggilan itu, dan naik setiap langkah. Kenaikan itulah riwayatnya. Masukkan dua total dari baris terakhir ke kalkulator biaya di atas sebagai pengganti 885000 dan 40000 dan Anda mendapatkan harga sesi Anda. URL dasar, kunci dan id model dijelaskan di dokumentasi CheapTokens.
Model mana untuk sesi Anda#
Harga per sesi ada di tabel. Yang tidak dapat ditunjukkan adalah apakah sesi itu muat, jadi pilih berdasarkan kasus Anda:
Pilih kasus Anda
Seperti apa agen Anda?
Pilih opsi untuk melihat jawabannya
Jawaban pendek, riwayat tetap di bawah 180K
Salah satu dari ketiganya cocok. Jendela 180K MiniMax-M2.7 menampung ratusan langkah seperti di atas, jadi pilih berdasarkan tabel biaya. Detail tentang MiniMax-M2.7.
Riwayat panjang, tanpa pemangkasan
GLM-5.3-Flash memiliki jendela terbesar dari ketiganya, 390K, dengan DeepSeek-V4-Flash hampir menyusul di 380K. Keduanya menyisakan ruang untuk sesi dengan tempelan alat atau log besar. Detail tentang GLM.
Langkah yang menulis file atau laporan panjang
DeepSeek-V4-Flash: hingga 32.768 token dalam satu jawaban versus 8.192 pada dua lainnya, plus jendela 380K. Detail tentang DeepSeek.
Batch semalam, tanpa pengawasan
Harga pada ketiganya sama pada jam berapa pun, tanpa harga jam sibuk, jadi proses semalam biayanya seperti yang tertera di tabel. Ukuran jendela dan batas jawaban dari bagian di atas dan pasang batas langkah di loop.
Ketiga model berada pada satu saldo CheapTokens di belakang alamat yang sama yang kompatibel dengan OpenAI, jadi setelah uji coba, beralih hanya mengganti id model. Harga terkini ada di halaman harga; perbandingan kekuatan ada di GLM vs DeepSeek vs MiniMax.


