Modelos y comparativasComparativa
Coste de una sesión de agente: 50 pasos en GLM, DeepSeek o MiniMax
Calcula cuánto cuesta una sesión de agente de 50 pasos cuando el historial se reenvía en cada paso y luego elige entre GLM-5.3-Flash, DeepSeek-V4-Flash y MiniMax-M2.7.
En esta página
Tu agente estuvo ejecutándose diez minutos y la factura es mayor que la tarea. No ocurrió nada raro: cada paso reenvía todo el historial, así que el lado de entrada crece con cada paso y acaba siendo la mayor parte del coste. Con las cifras de abajo, una sesión de 50 pasos envía 885.000 tokens de entrada y escribe 40.000. Elige el modelo según cuánto crecerá el historial y cuánto tiene que medir una respuesta, y luego comprueba el total en la tabla.
Por qué el paso 50 cuesta más que el paso 1#
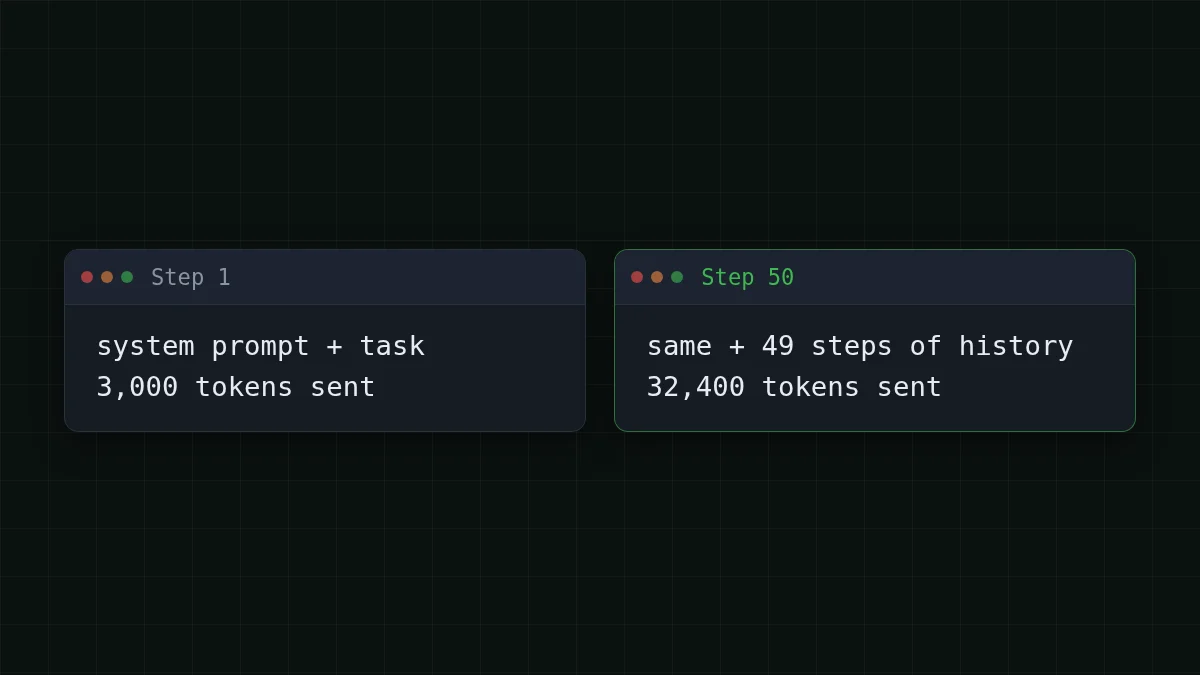
Un modelo no recuerda nada entre llamadas. Para continuar una tarea, el agente envía todo de nuevo: las instrucciones, cada paso anterior y lo que produjo el último paso. El paso 1 envía el contexto inicial. El paso 50 envía el contexto inicial más 49 pasos de historial. Si la idea es nueva para ti, por qué los agentes de IA usan tantos tokens recorre un ejemplo de 20 pasos.
Digamos que el agente empieza con 3.000 tokens (prompt de sistema, tarea, unos cuantos archivos) y cada paso añade unos 600 tokens al historial: el agente guarda una nota recortada de lo que hizo y vio, y descarta el resto. El paso 50 envía entonces 3.000 + 600 × 49 = 32.400 tokens. La respuesta se mantiene en torno a 800 tokens por paso. La pregunta no deja de crecer; la respuesta no.
La suma de 50 pasos#
Antes de la aritmética, haz una estimación.
Adivina el número
¿Cuántos tokens de entrada envía la sesión completa de 50 pasos?
Tu respuesta
02.000.000
Mostrar respuesta
Respuesta: 885.000
Unos 885.000. El paso k envía 3.000 + 600 × (k − 1) tokens, y a lo largo de 50 pasos eso suma 885.000 — más de veinte veces los 40.000 tokens que escribe el agente.
La suma, en el orden en que la harías en papel:
- El contexto inicial sale 50 veces: 50 × 3.000 = 150.000.
- Los números de paso de 0 a 49 suman 49 × 50 ÷ 2 = 1.225, y cada unidad son 600 tokens de historial: 600 × 1.225 = 735.000.
- Entrada en total: 150.000 + 735.000 = 885.000.
- Salida en total: 50 × 800 = 40.000.
El historial son 735.000 de los 885.000, y crece más rápido que el número de pasos. Duplica la tarea a 100 pasos: 99 × 100 ÷ 2 = 4.950, así que el historial es 600 × 4.950 = 2.970.000 y el contexto inicial es 100 × 3.000 = 300.000, lo que da 3.270.000 tokens de entrada en total. El doble de pasos, casi el cuádruple de entrada. La salida solo se duplica: 100 × 800 = 80.000.
Cuánto cuesta la sesión en cada modelo#
Una petición se factura por entrada y salida juntas, así que compara el total. Contado así, los tres modelos salen más baratos que OpenRouter en total para esta carga; la columna de OpenRouter en la tabla lo muestra. Los precios están en vivo, así que la tabla se mantiene actualizada.
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885.000 tokens de entrada y 40.000 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Léelo desde el lado de la entrada. Unos 96 de cada 100 tokens de esta sesión son de entrada, así que el precio de entrada decide la mayor parte del total. Entrada por 1M de tokens hoy: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
Y el duplicado, en DeepSeek-V4-Flash:
Ahora tu propia carga. El paso medio de nuestro ejemplo envía 885.000 ÷ 50 = 17.700 tokens de entrada y escribe 800. Cinco tareas así en un día son 5 × 50 = 250 pasos. Cambia las cifras por las tuyas; la calculadora suma sobre los pasos con precios en vivo.
Calculadora de costos
Cinco tareas de 50 pasos en un día
Tokens de entrada por solicitud: 17.700 · Tokens de salida por solicitud: 800 · Solicitudes por día: 250
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
¿Cabe el historial en la ventana?#
El coste es un límite. El otro es la ventana: una petición mayor que el contexto del modelo no se puede enviar en absoluto. El catálogo de modelos de CheapTokens (4 de noviembre de 2026) lista estos límites:
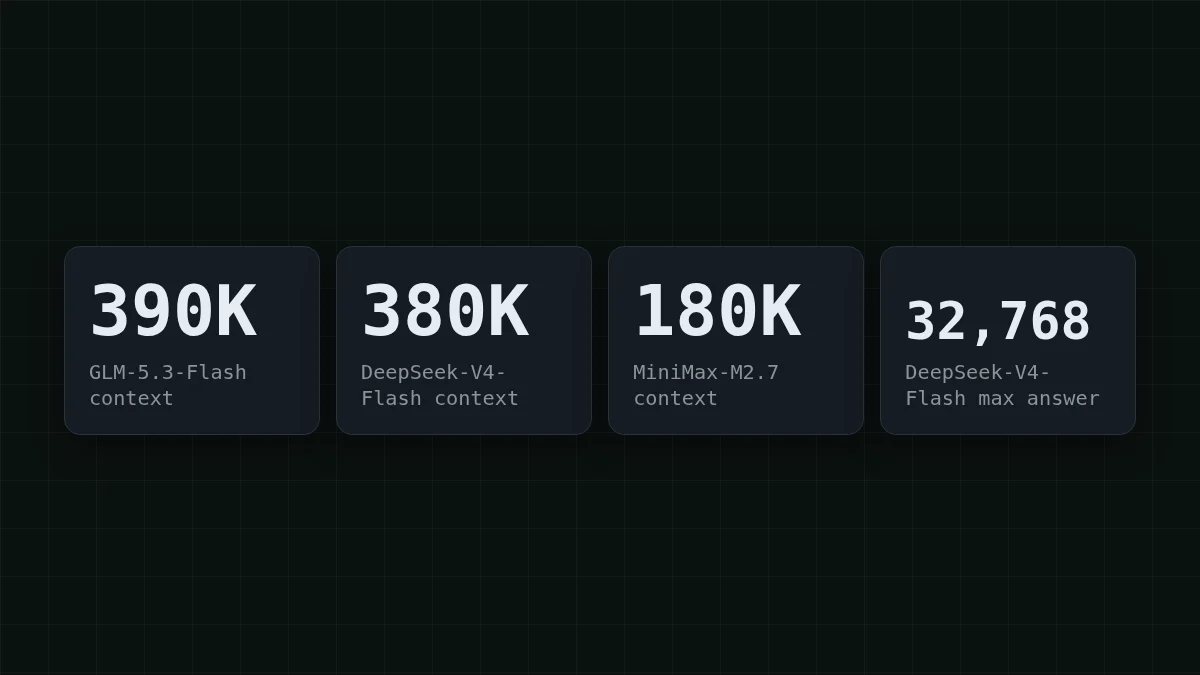
Con nuestro crecimiento de 600 tokens por paso, solo el historial se acerca a la ventana tras muchos pasos: MiniMax-M2.7 en torno al paso 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash en torno al paso 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash en torno al paso 640 (3.000 + 600 × 639 = 386.400). Una sesión de 50 pasos usa una pequeña parte de cualquiera de ellas.
Las sesiones reales son más irregulares. Si un paso pega un log grande y añade 6.000 tokens en lugar de 600, los 180K de MiniMax-M2.7 se acaban en torno al paso 30: 3.000 + 6.000 × 29 = 177.000. La misma tarea cabe en las ventanas mayores durante mucho más tiempo.
El límite de respuesta funciona al revés. GLM-5.3-Flash y MiniMax-M2.7 escriben hasta 8.192 tokens por respuesta, DeepSeek-V4-Flash hasta 32.768. Digamos que un paso tiene que producir un informe de 10.000 tokens. Con el límite de 8.192 la respuesta se detiene en el tope y finish_reason dice length; en DeepSeek-V4-Flash cabe en una sola respuesta.
La misma suma para un bot de soporte#
Un bot de soporte es el mismo bucle con una persona dentro. Digamos que una conversación dura 30 turnos, el prompt de sistema y las reglas ocupan 1.000 tokens, y cada turno añade 300 tokens al historial (100 del cliente, 200 del bot).
- Contexto inicial, 30 veces: 30 × 1.000 = 30.000.
- Historial: 29 × 30 ÷ 2 = 435 unidades de 300 tokens, así que 300 × 435 = 130.500.
- Entrada en total: 30.000 + 130.500 = 160.500.
- Salida en total: 30 × 200 = 6.000.
Una conversación así cuesta $0.0035 en GLM-5.3-Flash, $0.003 en DeepSeek-V4-Flash y $0.0089 en MiniMax-M2.7. La forma es la misma: unos 96 de cada 100 tokens son de entrada. Un bot con miles de conversaciones al día lo nota en la primera semana, y recortar el historial es la palanca. Ventana deslizante o resumen muestra cómo.
Mide tu propia sesión#
Las suposiciones anteriores son números redondos. Tu agente tiene las suyas, y la API te lo dice exactamente: cada respuesta lleva un objeto usage con los tokens de entrada y salida de esa llamada. Este bucle tiene la misma forma que un agente sin las herramientas: el historial crece, la lista completa se reenvía. Es un ejemplo; cambia el prompt por tu tarea.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
El número del medio en cada línea impresa es la entrada de esa llamada, y sube en cada paso. Esa subida es el historial. Pon los dos totales de la última línea en la calculadora de costes de arriba en lugar de 885000 y 40000 y tendrás el precio de tu sesión. La URL base, las claves y los ids de modelo se describen en la documentación de CheapTokens.
Qué modelo para tu sesión#
El precio por sesión está en la tabla. Lo que no puede mostrar es si la sesión cabe, así que elige según tu caso:
Elige tu caso
¿Cómo es tu agente?
Elige una opción para ver la respuesta
Respuestas cortas, el historial se queda por debajo de 180K
Cualquiera de los tres sirve. La ventana de 180K de MiniMax-M2.7 alberga cientos de pasos como los anteriores, así que elige según la tabla de costes. Detalles sobre MiniMax-M2.7.
Historial largo, sin recortes
GLM-5.3-Flash tiene la ventana más grande de los tres, 390K, con DeepSeek-V4-Flash muy cerca con 380K. Ambos dejan espacio para sesiones con grandes pegados de herramientas o logs. Detalles sobre GLM.
Pasos que escriben archivos o informes largos
DeepSeek-V4-Flash: hasta 32.768 tokens en una respuesta frente a 8.192 en los otros dos, además de una ventana de 380K. Detalles sobre DeepSeek.
Lote nocturno, sin nadie mirando
Los precios de los tres son iguales a cualquier hora, sin tarifas de hora punta, así que una ejecución nocturna cuesta lo que dice la tabla. Dimensiona la ventana y el límite de respuesta según las secciones anteriores y pon un límite de pasos en el bucle.
Los tres modelos están en un mismo saldo de CheapTokens detrás de la misma dirección compatible con OpenAI, así que tras una prueba cambiar es cambiar el id de modelo. Los precios actuales están en la página de precios; una comparación lado a lado de fortalezas está en GLM vs DeepSeek vs MiniMax.


