Modelos e comparaçõesComparação
Custo de sessão de agente: 50 passos no GLM, DeepSeek ou MiniMax
Calcule quanto custa uma sessão de agente de 50 passos quando o histórico é reenviado a cada passo, e escolha entre GLM-5.3-Flash, DeepSeek-V4-Flash e MiniMax-M2.7.
Nesta página
Seu agente rodou por dez minutos, e a conta é maior que a tarefa. Nada de estranho aconteceu: cada passo reenvia todo o histórico, então o lado da entrada cresce a cada passo e acaba sendo a maior parte do custo. Com os números abaixo, uma sessão de 50 passos envia 885.000 tokens de entrada e grava 40.000. Escolha o modelo pela forma como o histórico vai crescer e pelo tamanho que uma resposta precisa ter, depois confira o total na tabela.
Por que o passo 50 custa mais que o passo 1#
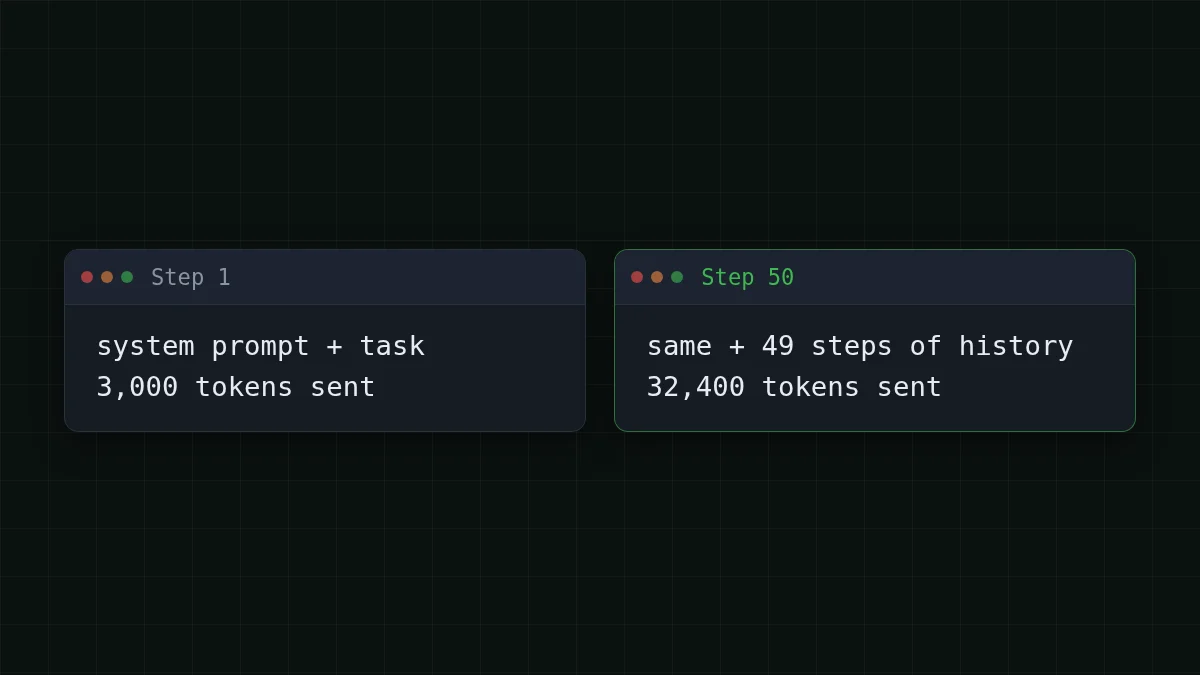
Um modelo não lembra de nada entre chamadas. Para continuar uma tarefa, o agente reenvia tudo: as instruções, cada passo anterior e o que o último passo produziu. O passo 1 envia o contexto inicial. O passo 50 envia o contexto inicial mais 49 passos de histórico. Se a ideia é nova para você, por que agentes de IA usam tantos tokens percorre um exemplo de 20 passos.
Digamos que o agente comece com 3.000 tokens (prompt de sistema, tarefa, alguns arquivos) e cada passo acrescente cerca de 600 tokens ao histórico: o agente mantém uma nota resumida do que fez e viu, e descarta o resto. O passo 50 então envia 3.000 + 600 × 49 = 32.400 tokens. A resposta fica em torno de 800 tokens por passo. A pergunta não para de crescer; a resposta, sim.
A soma dos 50 passos#
Antes da aritmética, faça um palpite.
Adivinhar o número
Quantos tokens de entrada a sessão inteira de 50 passos envia?
O seu palpite
02.000.000
Mostrar resposta
Resposta: 885.000
Cerca de 885.000. O passo k envia 3.000 + 600 × (k − 1) tokens, e ao longo de 50 passos isso soma 885.000 — mais de vinte vezes os 40.000 tokens que o agente grava.
A soma, na ordem em que você faria no papel:
- O contexto inicial sai 50 vezes: 50 × 3.000 = 150.000.
- Os números dos passos de 0 a 49 somam 49 × 50 ÷ 2 = 1.225, e cada unidade são 600 tokens de histórico: 600 × 1.225 = 735.000.
- Entrada no total: 150.000 + 735.000 = 885.000.
- Saída no total: 50 × 800 = 40.000.
O histórico é 735.000 dos 885.000, e cresce mais rápido que o número de passos. Dobre a tarefa para 100 passos: 99 × 100 ÷ 2 = 4.950, então o histórico é 600 × 4.950 = 2.970.000 e o contexto inicial é 100 × 3.000 = 300.000, o que dá 3.270.000 tokens de entrada no total. O dobro de passos, quase o quádruplo de entrada. A saída só dobra: 100 × 800 = 80.000.
Quanto a sessão custa em cada modelo#
Uma requisição é cobrada por entrada e saída juntas, então compare o total. Contado assim, os três modelos saem mais baratos que o OpenRouter no total para essa carga; a coluna do OpenRouter na tabela mostra isso. Os preços são ao vivo, então a tabela fica atualizada.
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885.000 tokens de entrada e 40.000 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Leia pelo lado da entrada. Cerca de 96 de cada 100 tokens nesta sessão são de entrada, então o preço de entrada decide a maior parte do total. Entrada por 1M tokens hoje: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
E a duplicação, no DeepSeek-V4-Flash:
Agora a sua própria carga. O passo médio no nosso exemplo envia 885.000 ÷ 50 = 17.700 tokens de entrada e grava 800. Cinco tarefas assim em um dia são 5 × 50 = 250 passos. Troque os números pelos seus; a calculadora soma ao longo dos passos com preços ao vivo.
Calculadora de custos
Cinco tarefas de 50 passos em um dia
Tokens de entrada por solicitação: 17.700 · Tokens de saída por solicitação: 800 · Solicitações por dia: 250
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
O histórico cabe na janela?#
Custo é um limite. O outro é a janela: uma requisição maior que o contexto do modelo não pode ser enviada de jeito nenhum. O catálogo de modelos da CheapTokens (4 de novembro de 2026) lista estes limites:
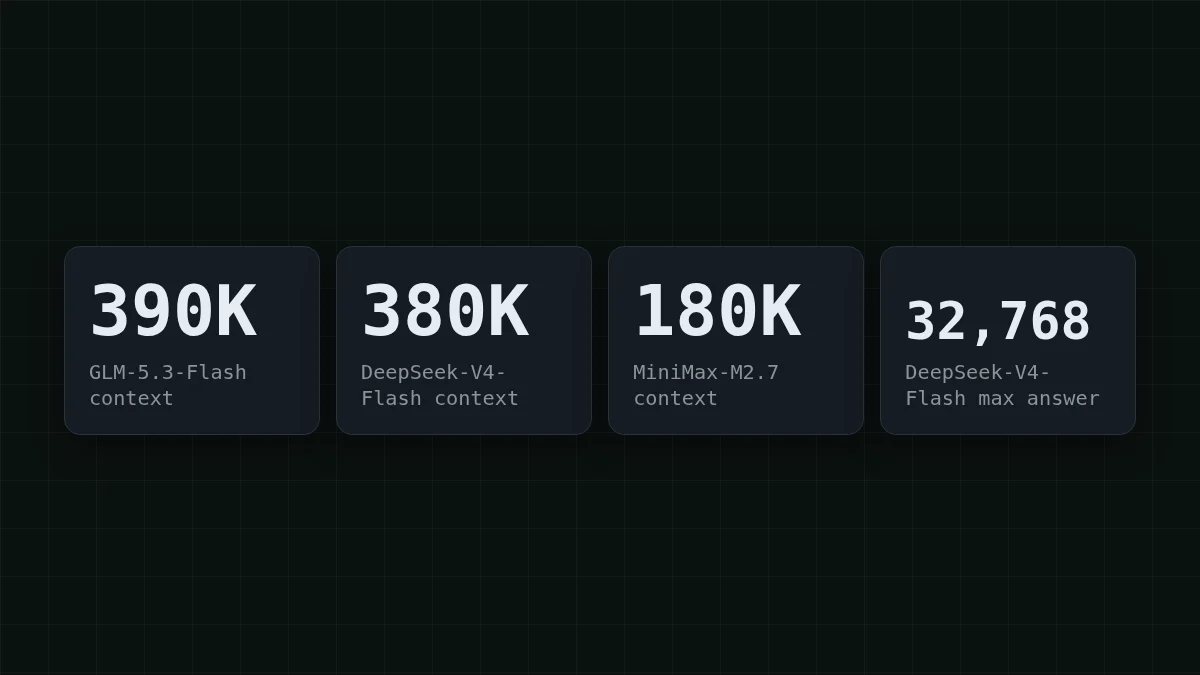
Com nosso crescimento de 600 tokens por passo, só o histórico chega perto da janela depois de muitos passos: MiniMax-M2.7 em cerca do passo 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash em cerca do passo 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash em cerca do passo 640 (3.000 + 600 × 639 = 386.400). Uma sessão de 50 passos usa uma pequena parte de qualquer uma delas.
Sessões reais são mais irregulares. Se um passo cola um log grande e acrescenta 6.000 tokens em vez de 600, os 180K do MiniMax-M2.7 acabam por volta do passo 30: 3.000 + 6.000 × 29 = 177.000. A mesma tarefa cabe nas janelas maiores por muito mais tempo.
O limite de resposta funciona ao contrário. GLM-5.3-Flash e MiniMax-M2.7 escrevem até 8.192 tokens por resposta, DeepSeek-V4-Flash até 32.768. Digamos que um passo precise produzir um relatório de 10.000 tokens. No limite de 8.192 a resposta para no teto e finish_reason diz length; no DeepSeek-V4-Flash cabe em uma resposta.
A mesma soma para um bot de suporte#
Um bot de suporte é o mesmo laço com uma pessoa dentro. Digamos que uma conversa dure 30 turnos, o prompt de sistema e as regras ocupem 1.000 tokens, e cada turno acrescente 300 tokens ao histórico (100 do cliente, 200 do bot).
- Contexto inicial, 30 vezes: 30 × 1.000 = 30.000.
- Histórico: 29 × 30 ÷ 2 = 435 unidades de 300 tokens, então 300 × 435 = 130.500.
- Entrada no total: 30.000 + 130.500 = 160.500.
- Saída no total: 30 × 200 = 6.000.
Uma conversa assim custa $0.0035 no GLM-5.3-Flash, $0.003 no DeepSeek-V4-Flash e $0.0089 no MiniMax-M2.7. A forma é a mesma: cerca de 96 de cada 100 tokens são de entrada. Um bot com milhares de conversas por dia sente isso na primeira semana, e enxugar o histórico é a alavanca. Janela deslizante ou resumo mostra como.
Meça sua própria sessão#
As premissas acima são números redondos. Seu agente tem as suas, e a API informa exatamente: toda resposta carrega um objeto usage com os tokens de entrada e saída daquela chamada. Este laço tem a mesma forma de um agente sem as ferramentas: o histórico cresce, a lista inteira é reenviada. É um exemplo; troque o prompt pela sua tarefa.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
O número do meio em cada linha impressa é a entrada daquela chamada, e ele sobe a cada passo. Essa subida é o histórico. Coloque os dois totais da última linha na calculadora de custo acima no lugar de 885000 e 40000 e você tem o preço da sua sessão. A URL base, as chaves e os ids de modelo estão descritos na documentação da CheapTokens.
Qual modelo para a sua sessão#
O preço por sessão está na tabela. O que ela não mostra é se a sessão cabe, então escolha pelo seu caso:
Escolha o seu caso
Como é o seu agente?
Escolha uma opção para ver a resposta
Respostas curtas, histórico fica abaixo de 180K
Qualquer um dos três serve. A janela de 180K do MiniMax-M2.7 comporta centenas de passos como os acima, então escolha pela tabela de custo. Detalhes em MiniMax-M2.7.
Histórico longo, sem enxugar
GLM-5.3-Flash tem a maior janela dos três, 390K, com DeepSeek-V4-Flash logo atrás, com 380K. Ambos deixam espaço para sessões com grandes colagens de ferramentas ou logs. Detalhes em GLM.
Passos que escrevem arquivos ou relatórios longos
DeepSeek-V4-Flash: até 32.768 tokens em uma resposta contra 8.192 nos outros dois, além de uma janela de 380K. Detalhes em DeepSeek.
Lote noturno, ninguém olhando
Os preços dos três são os mesmos em qualquer horário, sem tarifa de horário de pico, então uma execução noturna custa o que a tabela diz. Dimensione a janela e o limite de resposta pelas seções acima e coloque um limite de passos no laço.
Os três modelos ficam em um único saldo CheapTokens atrás do mesmo endereço compatível com OpenAI, então depois de um teste a troca é só mudar o id do modelo. Os preços atuais estão na página de preços; uma comparação lado a lado dos pontos fortes está em GLM vs DeepSeek vs MiniMax.


