Mga modelo at paghahambingPaghahambing
Gastos ng sesyon ng agent: 50 hakbang sa GLM, DeepSeek o MiniMax
Alamin kung magkano ang gastos ng isang 50-hakbang na sesyon ng agent kapag ang kasaysayan ay muling ipinapadala bawat hakbang, pagkatapos ay pumili sa pagitan ng GLM-5.3-Flash, DeepSeek-V4-Flash at MiniMax-M2.7.
Sa pahinang ito
Ang iyong agent ay tumakbo ng sampung minuto, at ang bill ay mas malaki kaysa sa gawain. Walang kakaiba ang nangyari: bawat hakbang ay muling nagpapadala ng buong kasaysayan, kaya ang input side ay lumalaki sa bawat hakbang at nauuwi sa karamihan ng gastos. Sa mga numero sa ibaba, ang isang 50-hakbang na sesyon ay nagpapadala ng 885,000 input token at nagsusulat ng 40,000. Piliin ang modelo batay sa kung gaano kalayo lalago ang kasaysayan at kung gaano kahaba ang isang sagot, pagkatapos ay tingnan ang kabuuan sa talahanayan.
Bakit ang hakbang 50 ay mas mahal kaysa sa hakbang 1#
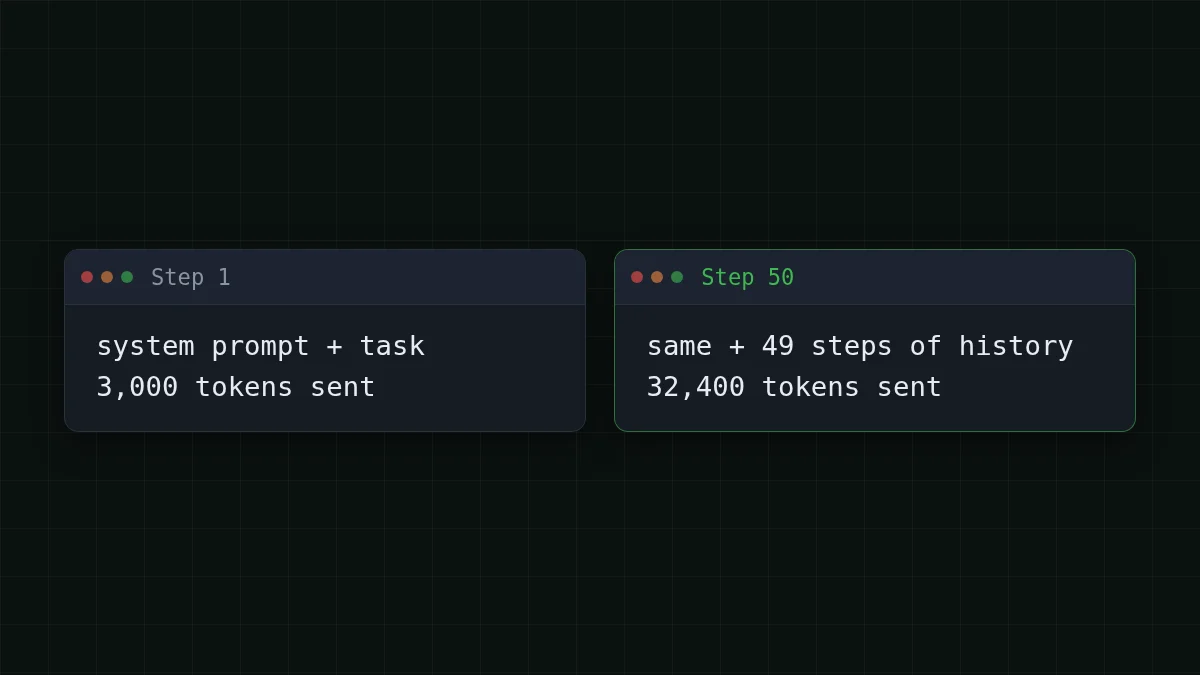
Ang isang modelo ay walang natatandaan sa pagitan ng mga tawag. Upang magpatuloy sa isang gawain, ang agent ay muling nagpapadala ng lahat: ang mga tagubilin, bawat naunang hakbang, at ang ginawa ng huling hakbang. Ang hakbang 1 ay nagpapadala ng panimulang konteksto. Ang hakbang 50 ay nagpapadala ng panimulang konteksto kasama ang 49 na hakbang ng kasaysayan. Kung bago sa iyo ang ideya, bakit gumagamit ng napakaraming token ang mga AI agent ay naglalakad sa isang 20-hakbang na halimbawa.
Sabihin nating ang agent ay nagsisimula sa 3,000 token (system prompt, gawain, ilang file) at bawat hakbang ay nagdadagdag ng mga 600 token sa kasaysayan: ang agent ay nagpapanatili ng pinutol na tala ng kung ano ang ginawa at nakita, at itinatapon ang iba. Ang hakbang 50 ay nagpapadala ng 3,000 + 600 × 49 = 32,400 token. Ang sagot ay nananatiling humigit-kumulang 800 token bawat hakbang. Ang tanong ay patuloy na lumalaki; ang sagot ay hindi.
Ang kabuuan ng 50 hakbang#
Bago ang aritmetika, magbigay ng hula.
Hulaan ang numero
Ilang input token ang ipinapadala ng buong 50-hakbang na sesyon?
Ang iyong hula
02,000,000
Ipakita ang sagot
Sagot: 885,000
Mga 885,000. Ang hakbang k ay nagpapadala ng 3,000 + 600 × (k − 1) token, at sa 50 hakbang ay umaabot ito sa 885,000 — higit sa dalawampung beses ng 40,000 token na isinusulat ng agent.
Ang kabuuan, sa pagkakasunod-sunod na gagawin mo sa papel:
- Ang panimulang konteksto ay lumalabas ng 50 beses: 50 × 3,000 = 150,000.
- Ang mga numero ng hakbang 0 hanggang 49 ay nagdadagdag hanggang 49 × 50 ÷ 2 = 1,225, at bawat yunit ay 600 token ng kasaysayan: 600 × 1,225 = 735,000.
- Input sa kabuuan: 150,000 + 735,000 = 885,000.
- Output sa kabuuan: 50 × 800 = 40,000.
Ang kasaysayan ay 735,000 ng 885,000, at ito ay lumalaki nang mas mabilis kaysa sa bilang ng hakbang. Doblehin ang gawain sa 100 hakbang: 99 × 100 ÷ 2 = 4,950, kaya ang kasaysayan ay 600 × 4,950 = 2,970,000 at ang panimulang konteksto ay 100 × 3,000 = 300,000, na gumagawa ng 3,270,000 input token sa kabuuan. Doble ang mga hakbang, halos apat na beses ang input. Ang output ay dumodoble lamang: 100 × 800 = 80,000.
Magkano ang gastos ng sesyon sa bawat modelo#
Ang isang kahilingan ay sinisingil para sa input at output nang magkasama, kaya ihambing ang kabuuan. Sa ganoong pagbilang, lahat ng tatlong modelo ay lumalabas na mas mura kaysa sa OpenRouter sa kabuuan para sa load na ito; ang column ng OpenRouter sa talahanayan ay nagpapakita nito. Ang mga presyo ay live, kaya ang talahanayan ay nananatiling napapanahon.
| Modelo | Input $/1M | Output $/1M | Gastos | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885,000 input at 40,000 output na token sa kabuuan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Basahin ito mula sa input side. Mga 96 sa bawat 100 token sa sesyong ito ay input, kaya ang presyo ng input ang nagtatakda ng karamihan ng kabuuan. Input bawat 1M token ngayon: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
At ang pagdoble, sa DeepSeek-V4-Flash:
Ngayon ang sarili mong load. Ang average na hakbang sa aming halimbawa ay nagpapadala ng 885,000 ÷ 50 = 17,700 input token at nagsusulat ng 800. Limang ganoong gawain sa isang araw ay 5 × 50 = 250 hakbang. Palitan ang mga numero ng sa iyo; ang calculator ay nagbubuod sa mga hakbang gamit ang live na presyo.
Calculator ng gastos
Limang 50-hakbang na gawain sa isang araw
Mga input token bawat kahilingan: 17,700 · Mga output token bawat kahilingan: 800 · Mga kahilingan bawat araw: 250
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
Kasya ba ang kasaysayan sa window?#
Ang gastos ay isang limitasyon. Ang isa pa ay ang window: ang isang kahilingan na mas malaki kaysa sa konteksto ng modelo ay hindi maipapadala. Ang catalog ng modelo ng CheapTokens (4 Nobyembre 2026) ay naglilista ng mga limitasyong ito:
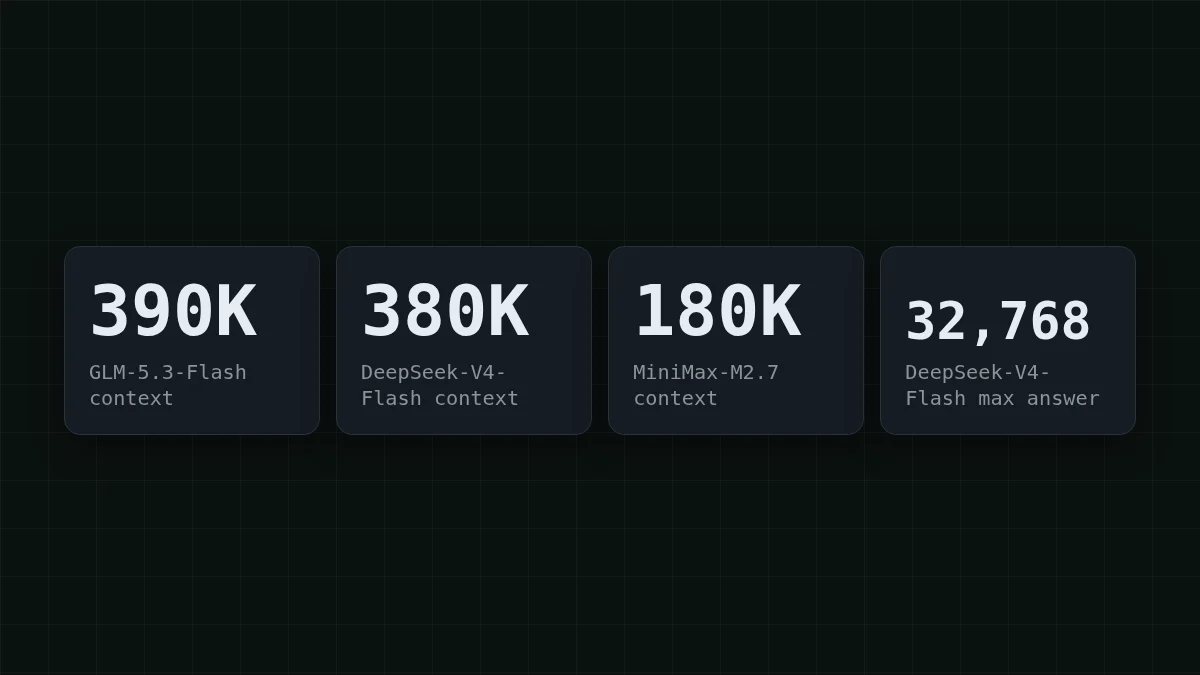
Sa aming paglaki na 600 token bawat hakbang, ang kasaysayan lamang ay lumalapit sa window pagkatapos ng maraming hakbang: MiniMax-M2.7 sa mga hakbang 290 (3,000 + 600 × 289 = 176,400), DeepSeek-V4-Flash sa mga hakbang 620 (3,000 + 600 × 619 = 374,400), GLM-5.3-Flash sa mga hakbang 640 (3,000 + 600 × 639 = 386,400). Ang isang 50-hakbang na sesyon ay gumagamit ng maliit na bahagi ng alinman sa mga ito.
Ang mga totoong sesyon ay mas magaspang. Kung ang isang hakbang ay nag-paste ng malaking log at nagdadagdag ng 6,000 token sa halip na 600, ang 180K ng MiniMax-M2.7 ay nagtatapos sa mga hakbang 30: 3,000 + 6,000 × 29 = 177,000. Ang parehong gawain ay kasya sa mas malalaking window nang mas matagal.
Ang limitasyon ng sagot ay gumagana sa kabaligtaran. Ang GLM-5.3-Flash at MiniMax-M2.7 ay nagsusulat ng hanggang 8,192 token bawat sagot, ang DeepSeek-V4-Flash hanggang 32,768. Sabihin nating ang isang hakbang ay kailangang gumawa ng 10,000-token na ulat. Sa 8,192 na limitasyon, ang tugon ay hihinto sa cap at ang finish_reason ay nagsasabi ng length; sa DeepSeek-V4-Flash ito ay kasya sa isang sagot.
Ang parehong kabuuan para sa isang support bot#
Ang isang support bot ay ang parehong loop na may tao sa loob. Sabihin nating ang isang pag-uusap ay tumatakbo ng 30 turn, ang system prompt at mga patakaran ay tumatagal ng 1,000 token, at bawat turn ay nagdadagdag ng 300 token sa kasaysayan (100 mula sa customer, 200 mula sa bot).
- Panimulang konteksto, 30 beses: 30 × 1,000 = 30,000.
- Kasaysayan: 29 × 30 ÷ 2 = 435 na yunit ng 300 token, kaya 300 × 435 = 130,500.
- Input sa kabuuan: 30,000 + 130,500 = 160,500.
- Output sa kabuuan: 30 × 200 = 6,000.
Ang isang ganoong pag-uusap ay nagkakahalaga ng $0.0035 sa GLM-5.3-Flash, $0.003 sa DeepSeek-V4-Flash at $0.0089 sa MiniMax-M2.7. Ang hugis ay pareho: mga 96 sa bawat 100 token ay input. Ang isang bot na may libu-libong pag-uusap sa isang araw ay nararamdaman ito sa unang linggo, at ang pag-trim ng kasaysayan ang lever. Sliding window o summary ay nagpapakita kung paano.
Sukatin ang sarili mong sesyon#
Ang mga pagpapalagay sa itaas ay mga round number. Ang iyong agent ay may sariling mga ito, at ang API ay nagsasabi sa iyo nang eksakto: bawat tugon ay may dalang usage object na may input at output token ng tawag na iyon. Ang loop na ito ay may parehong hugis ng isang agent na walang mga tool: lumalaki ang kasaysayan, ang buong listahan ay muling ipinapadala. Ito ay isang halimbawa; palitan ang prompt ng iyong gawain.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Ang gitnang numero sa bawat naka-print na linya ay ang input ng tawag na iyon, at ito ay umaakyat sa bawat hakbang. Ang pag-akyat na iyon ay ang kasaysayan. Ilagay ang dalawang kabuuan mula sa huling linya sa cost calculator sa itaas kapalit ng 885000 at 40000 at mayroon ka nang presyo ng iyong sesyon. Ang base URL, mga key at model id ay inilarawan sa CheapTokens docs.
Aling modelo para sa iyong sesyon#
Ang presyo bawat sesyon ay nasa talahanayan. Ang hindi nito maipapakita ay kung kasya ang sesyon, kaya pumili ayon sa iyong kaso:
Piliin ang iyong kaso
Ano ang hitsura ng iyong agent?
Pumili ng opsyon upang makita ang sagot
Maikling sagot, ang kasaysayan ay nananatiling wala pang 180K
Kahit alin sa tatlo ay kasya. Ang 180K na window ng MiniMax-M2.7 ay nagtataglay ng daan-daang hakbang tulad ng mga nasa itaas, kaya pumili ayon sa talahanayan ng gastos. Mga detalye sa MiniMax-M2.7.
Mahabang kasaysayan, walang pag-trim
Ang GLM-5.3-Flash ang may pinakamalaking window sa tatlo, 390K, kasunod ang DeepSeek-V4-Flash sa 380K. Pareho silang nag-iiwan ng espasyo para sa mga sesyon na may malalaking tool o log paste. Mga detalye sa GLM.
Mga hakbang na nagsusulat ng mahahabang file o ulat
DeepSeek-V4-Flash: hanggang 32,768 token sa isang sagot kumpara sa 8,192 sa dalawa, kasama ang 380K na window. Mga detalye sa DeepSeek.
Overnight batch, walang nanonood
Ang mga presyo sa lahat ng tatlo ay pareho sa anumang oras, walang peak-hour pricing, kaya ang isang overnight run ay nagkakahalaga ng sinasabi ng talahanayan. Sukatin ang window at ang limitasyon ng sagot mula sa mga seksyon sa itaas at maglagay ng step limit sa loop.
Lahat ng tatlong modelo ay nakaupo sa isang balanse ng CheapTokens sa likod ng parehong OpenAI-compatible address, kaya pagkatapos ng trial run ang paglipat ay isang pagbabago ng model id. Ang mga kasalukuyang presyo ay nasa pricing page; ang side-by-side ng mga lakas ay nasa GLM vs DeepSeek vs MiniMax.


