মডেল ও তুলনাতুলনা
এজেন্ট সেশনের খরচ: GLM, DeepSeek বা MiniMax-এ 50 ধাপ
প্রতিটি ধাপে ইতিহাস আবার পাঠানো হলে একটি 50-ধাপের এজেন্ট সেশনের খরচ কত হয় তা বের করুন, তারপর GLM-5.3-Flash, DeepSeek-V4-Flash এবং MiniMax-M2.7-এর মধ্যে বেছে নিন।
এই পৃষ্ঠায়
আপনার এজেন্ট দশ মিনিট চলেছে, আর বিলটা কাজের চেয়ে বড়। অদ্ভুত কিছু ঘটেনি: প্রতিটি ধাপে পুরো ইতিহাস আবার পাঠানো হয়, তাই ইনপুট দিকটি প্রতিটি ধাপে বাড়ে এবং শেষে খরচের বড় অংশ হয়ে দাঁড়ায়। নিচের সংখ্যাগুলো দিয়ে, একটি 50-ধাপের সেশন 885,000 ইনপুট টোকেন পাঠায় এবং 40,000 লেখে। ইতিহাস কতটা বাড়বে এবং একটি উত্তর কতটা লম্বা হতে হবে তার ভিত্তিতে মডেল বেছে নিন, তারপর টেবিলে মোট খরচ দেখুন।
কেন ধাপ 50 ধাপ 1-এর চেয়ে বেশি খরচ করে#
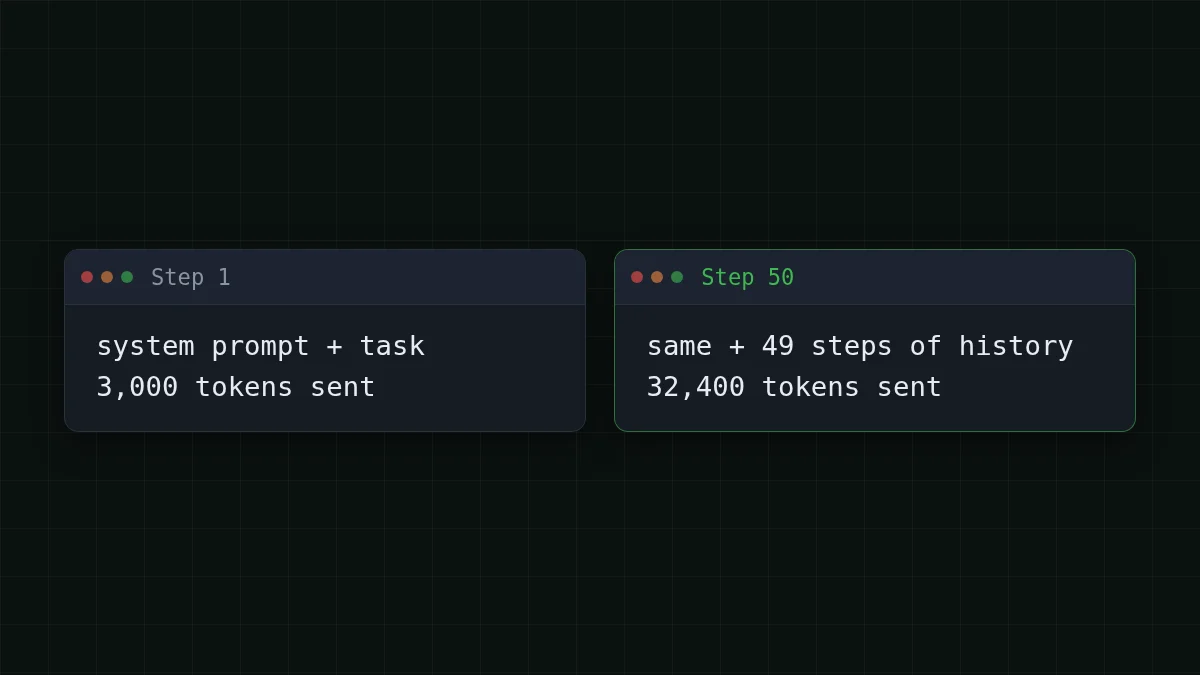
একটি মডেল কলের মধ্যে কিছু মনে রাখে না। একটি কাজ চালিয়ে যেতে, এজেন্ট আবার সবকিছু পাঠায়: নির্দেশাবলি, প্রতিটি আগের ধাপ, এবং শেষ ধাপে যা উৎপন্ন হয়েছে। ধাপ 1 শুরুর প্রসঙ্গ পাঠায়। ধাপ 50 শুরুর প্রসঙ্গ প্লাস 49 ধাপের ইতিহাস পাঠায়। যদি ধারণাটি আপনার কাছে নতুন হয়, কেন AI এজেন্ট এত টোকেন ব্যবহার করে একটি 20-ধাপের উদাহরণের মধ্য দিয়ে যায়।
ধরুন এজেন্ট 3,000 টোকেন দিয়ে শুরু করে (সিস্টেম প্রম্পট, কাজ, কয়েকটি ফাইল) এবং প্রতিটি ধাপ ইতিহাসে প্রায় 600 টোকেন যোগ করে: এজেন্ট সে কী করেছে এবং দেখেছে তার একটি ছাঁটা নোট রাখে, বাকিটা বাদ দেয়। ধাপ 50 তখন পাঠায় 3,000 + 600 × 49 = 32,400 টোকেন। উত্তরটি প্রতি ধাপে প্রায় 800 টোকেন থাকে। প্রশ্নটি বাড়তেই থাকে; উত্তরটি বাড়ে না।
50-ধাপের যোগফল#
গণিতের আগে, একটি অনুমান করুন।
সংখ্যা অনুমান করুন
পুরো 50-ধাপের সেশন কত ইনপুট টোকেন পাঠায়?
আপনার অনুমান
০২০,০০,০০০
উত্তর দেখান
উত্তর: ৮,৮৫,০০০
প্রায় 885,000। ধাপ k পাঠায় 3,000 + 600 × (k − 1) টোকেন, এবং 50 ধাপে যোগ করলে 885,000 হয় — এজেন্ট যে 40,000 টোকেন লেখে তার চেয়ে বিশ গুণেরও বেশি।
যোগফল, কাগজে যেভাবে করবেন সেই ক্রমে:
- শুরুর প্রসঙ্গ 50 বার যায়: 50 × 3,000 = 150,000।
- ধাপ সংখ্যা 0 থেকে 49 যোগ করলে 49 × 50 ÷ 2 = 1,225, এবং প্রতিটি একক 600 টোকেন ইতিহাস: 600 × 1,225 = 735,000।
- মোট ইনপুট: 150,000 + 735,000 = 885,000।
- মোট আউটপুট: 50 × 800 = 40,000।
885,000-এর মধ্যে ইতিহাস 735,000, এবং এটি ধাপ সংখ্যার চেয়ে দ্রুত বাড়ে। কাজটি দ্বিগুণ করে 100 ধাপ করুন: 99 × 100 ÷ 2 = 4,950, তাই ইতিহাস 600 × 4,950 = 2,970,000 এবং শুরুর প্রসঙ্গ 100 × 3,000 = 300,000, যা মোট 3,270,000 ইনপুট টোকেন করে। দ্বিগুণ ধাপ, প্রায় চার গুণ ইনপুট। আউটপুট শুধু দ্বিগুণ হয়: 100 × 800 = 80,000।
প্রতিটি মডেলে সেশনের খরচ#
একটি অনুরোধের জন্য ইনপুট এবং আউটপুট একসাথে বিল হয়, তাই মোট তুলনা করুন। এভাবে গণনা করলে, এই লোডের জন্য তিনটি মডেলই মোটে OpenRouter-এর চেয়ে সস্তা হয়; টেবিলের OpenRouter কলামটি তা দেখায়। দাম লাইভ, তাই টেবিলটি হালনাগাদ থাকে।
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | খরচ | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
মোট ৮,৮৫,০০০ ইনপুট এবং ৪০,০০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
ইনপুট দিক থেকে পড়ুন। এই সেশনে প্রতি 100 টোকেনের মধ্যে প্রায় 96টি ইনপুট, তাই ইনপুট দামই মোটের বেশিরভাগ নির্ধারণ করে। আজ প্রতি 1M টোকেনে ইনপুট: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05।
এবং দ্বিগুণ হওয়া, DeepSeek-V4-Flash-এ:
এখন আপনার নিজের লোড। আমাদের উদাহরণে গড় ধাপ পাঠায় 885,000 ÷ 50 = 17,700 ইনপুট টোকেন এবং লেখে 800। দিনে এমন পাঁচটি কাজ 5 × 50 = 250 ধাপ। সংখ্যাগুলো আপনার নিজের মতো বদলান; ক্যালকুলেটরটি লাইভ দামে ধাপগুলোর উপর যোগ করে।
খরচ ক্যালকুলেটর
একদিনে পাঁচটি 50-ধাপের কাজ
প্রতি অনুরোধে ইনপুট টোকেন: ১৭,৭০০ · প্রতি অনুরোধে আউটপুট টোকেন: ৮০০ · প্রতিদিন অনুরোধ: ২৫০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
ইতিহাস কি উইন্ডোতে ফিট করে?#
খরচ একটি সীমা। অন্যটি হলো উইন্ডো: মডেলের প্রসঙ্গের চেয়ে বড় অনুরোধ আদৌ পাঠানো যায় না। CheapTokens মডেল ক্যাটালগ (4 নভেম্বর 2026) এই সীমাগুলো তালিকাভুক্ত করে:
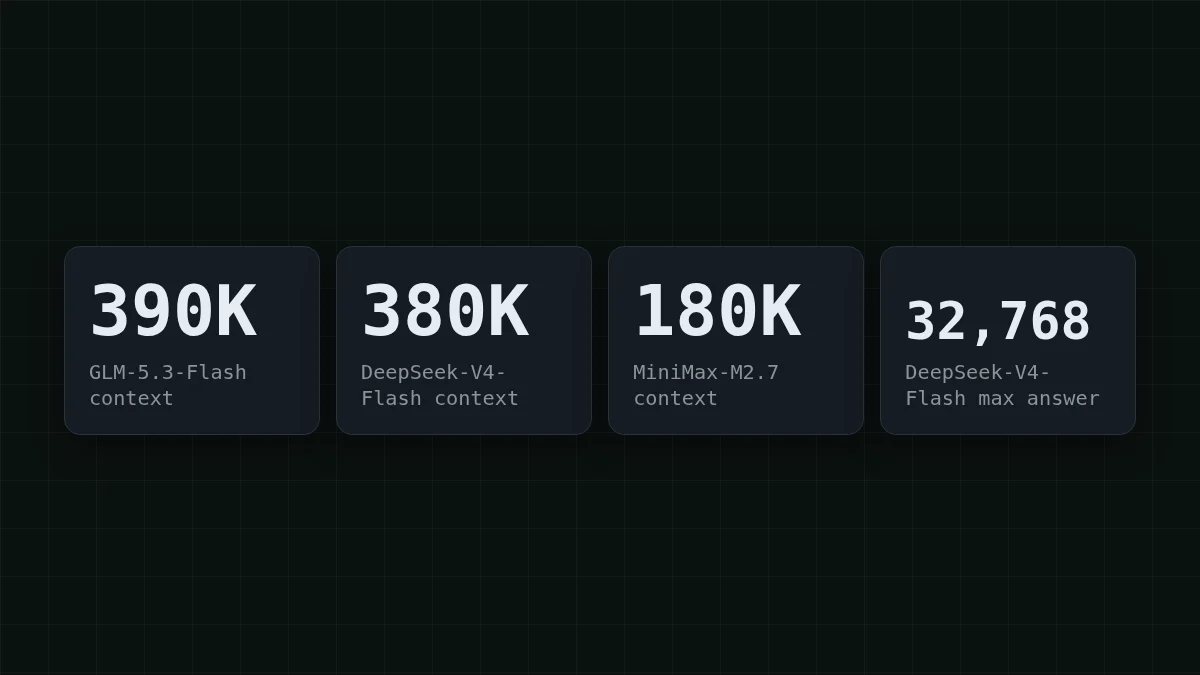
প্রতি ধাপে 600 টোকেন বৃদ্ধির সাথে, শুধু ইতিহাসই অনেক ধাপ পরে উইন্ডোর কাছাকাছি পৌঁছে যায়: MiniMax-M2.7 প্রায় ধাপ 290-এ (3,000 + 600 × 289 = 176,400), DeepSeek-V4-Flash প্রায় ধাপ 620-এ (3,000 + 600 × 619 = 374,400), GLM-5.3-Flash প্রায় ধাপ 640-এ (3,000 + 600 × 639 = 386,400)। একটি 50-ধাপের সেশন এগুলোর যেকোনোটির অল্প অংশ ব্যবহার করে।
বাস্তব সেশন আরও রুক্ষ। যদি একটি ধাপ একটি বড় লগ পেস্ট করে এবং 600-এর বদলে 6,000 টোকেন যোগ করে, MiniMax-M2.7-এর 180K প্রায় ধাপ 30-এ শেষ হয়: 3,000 + 6,000 × 29 = 177,000। একই কাজ বড় উইন্ডোগুলোতে অনেক বেশি সময় ধরে ফিট করে।
উত্তর সীমা উল্টো দিকে কাজ করে। GLM-5.3-Flash এবং MiniMax-M2.7 প্রতি উত্তরে সর্বোচ্চ 8,192 টোকেন লেখে, DeepSeek-V4-Flash সর্বোচ্চ 32,768। ধরুন একটি ধাপে 10,000-টোকেনের একটি প্রতিবেদন তৈরি করতে হবে। 8,192 সীমায় উত্তরটি ক্যাপে থেমে যায় এবং finish_reason বলে length; DeepSeek-V4-Flash-এ এটি এক উত্তরে ফিট করে।
একটি সাপোর্ট বটের জন্য একই যোগফল#
একটি সাপোর্ট বট হলো একই লুপ যাতে একজন মানুষ আছে। ধরুন একটি কথোপকথন 30 টার্ন চলে, সিস্টেম প্রম্পট এবং নিয়ম 1,000 টোকেন নেয়, এবং প্রতিটি টার্ন ইতিহাসে 300 টোকেন যোগ করে (100 গ্রাহকের কাছ থেকে, 200 বটের কাছ থেকে)।
- শুরুর প্রসঙ্গ, 30 বার: 30 × 1,000 = 30,000।
- ইতিহাস: 29 × 30 ÷ 2 = 435 একক 300 টোকেনের, তাই 300 × 435 = 130,500।
- মোট ইনপুট: 30,000 + 130,500 = 160,500।
- মোট আউটপুট: 30 × 200 = 6,000।
এমন একটি কথোপকথনের খরচ GLM-5.3-Flash-এ $0.0035, DeepSeek-V4-Flash-এ $0.003 এবং MiniMax-M2.7-এ $0.0089। আকার একই: প্রতি 100 টোকেনের মধ্যে প্রায় 96টি ইনপুট। দিনে হাজার হাজার কথোপকথনযুক্ত একটি বট প্রথম সপ্তাহেই এটি অনুভব করে, এবং ইতিহাস ছাঁটা হলো লিভার। স্লাইডিং উইন্ডো বা সারাংশ দেখায় কীভাবে।
আপনার নিজের সেশন পরিমাপ করুন#
উপরের অনুমানগুলো গোল সংখ্যা। আপনার এজেন্টের নিজস্ব আছে, এবং API আপনাকে সঠিকভাবে বলে: প্রতিটি প্রতিক্রিয়ায় একটি usage অবজেক্ট থাকে যাতে সেই কলে ইনপুট এবং আউটপুট টোকেন থাকে। এই লুপটির আকার টুল ছাড়া একটি এজেন্টের মতোই: ইতিহাস বাড়ে, পুরো তালিকা আবার পাঠানো হয়। এটি একটি উদাহরণ; প্রম্পটটি আপনার কাজের জন্য বদলে নিন।
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
প্রতিটি মুদ্রিত লাইনের মাঝের সংখ্যাটি সেই কলের ইনপুট, এবং এটি প্রতিটি ধাপে বাড়ে। সেই বৃদ্ধিই ইতিহাস। শেষ লাইনের দুটি মোট সংখ্যা উপরের খরচ ক্যালকুলেটরে 885000 এবং 40000-এর জায়গায় বসান এবং আপনার সেশনের দাম পেয়ে যাবেন। বেস URL, কী এবং মডেল আইডি CheapTokens ডক্স-এ বর্ণিত আছে।
আপনার সেশনের জন্য কোন মডেল#
প্রতি সেশনের দাম টেবিলে আছে। যা এটি দেখাতে পারে না তা হলো সেশনটি ফিট করে কিনা, তাই আপনার ক্ষেত্র অনুযায়ী বেছে নিন:
আপনার কেস বেছে নিন
আপনার এজেন্ট কেমন দেখায়?
উত্তর দেখতে একটি বিকল্প বেছে নিন
ছোট উত্তর, ইতিহাস 180K-এর নিচে থাকে
তিনটির যেকোনোটি ফিট করে। MiniMax-M2.7-এর 180K উইন্ডো উপরের মতো শত শত ধাপ ধরে রাখে, তাই খরচের টেবিল দেখে বেছে নিন। বিস্তারিত MiniMax-M2.7-এ।
দীর্ঘ ইতিহাস, ছাঁটা নেই
GLM-5.3-Flash-এর তিনটির মধ্যে সবচেয়ে বড় উইন্ডো, 390K, সাথে DeepSeek-V4-Flash ঘনিষ্ঠভাবে পিছিয়ে 380K। উভয়ই বড় টুল বা লগ পেস্টযুক্ত সেশনের জন্য জায়গা রাখে। বিস্তারিত GLM-এ।
যে ধাপগুলো লম্বা ফাইল বা প্রতিবেদন লেখে
DeepSeek-V4-Flash: এক উত্তরে সর্বোচ্চ 32,768 টোকেন বনাম অন্য দুটিতে 8,192, সাথে 380K উইন্ডো। বিস্তারিত DeepSeek-এ।
রাতভর ব্যাচ, কেউ দেখছে না
তিনটিরই দাম যেকোনো সময় একই, পিক-আওয়ার মূল্য নেই, তাই রাতভর চালানো খরচ টেবিলে যা বলে তাই। উপরের বিভাগগুলো থেকে উইন্ডো এবং উত্তর সীমা নির্ধারণ করুন এবং লুপে একটি ধাপ সীমা রাখুন।
তিনটি মডেলই একই OpenAI-সামঞ্জস্যপূর্ণ ঠিকানার পিছনে একটি CheapTokens ব্যালেন্সে থাকে, তাই ট্রায়াল চালানোর পরে সুইচ করা হলো মডেল আইডি পরিবর্তন। বর্তমান দাম মূল্য পৃষ্ঠা-এ; শক্তির পাশাপাশি তুলনা GLM vs DeepSeek vs MiniMax-এ।


