Modelle & VergleicheVergleich
Agent-Sitzungskosten: 50 Schritte auf GLM, DeepSeek oder MiniMax
Berechne, was eine 50-Schritte-Agent-Sitzung kostet, wenn die Historie bei jedem Schritt erneut gesendet wird, und wähle zwischen GLM-5.3-Flash, DeepSeek-V4-Flash und MiniMax-M2.7.
Auf dieser Seite
Dein Agent lief zehn Minuten, und die Rechnung ist größer als die Aufgabe. Nichts Ungewöhnliches ist passiert: Jeder Schritt sendet die gesamte Historie erneut, sodass die Eingabeseite mit jedem Schritt wächst und am Ende den Großteil der Kosten ausmacht. Mit den Zahlen unten sendet eine 50-Schritte-Sitzung 885.000 Eingabe-Tokens und schreibt 40.000. Wähle das Modell danach, wie weit die Historie wachsen wird und wie lang eine Antwort sein muss, und prüfe dann die Summe in der Tabelle.
Warum Schritt 50 mehr kostet als Schritt 1#
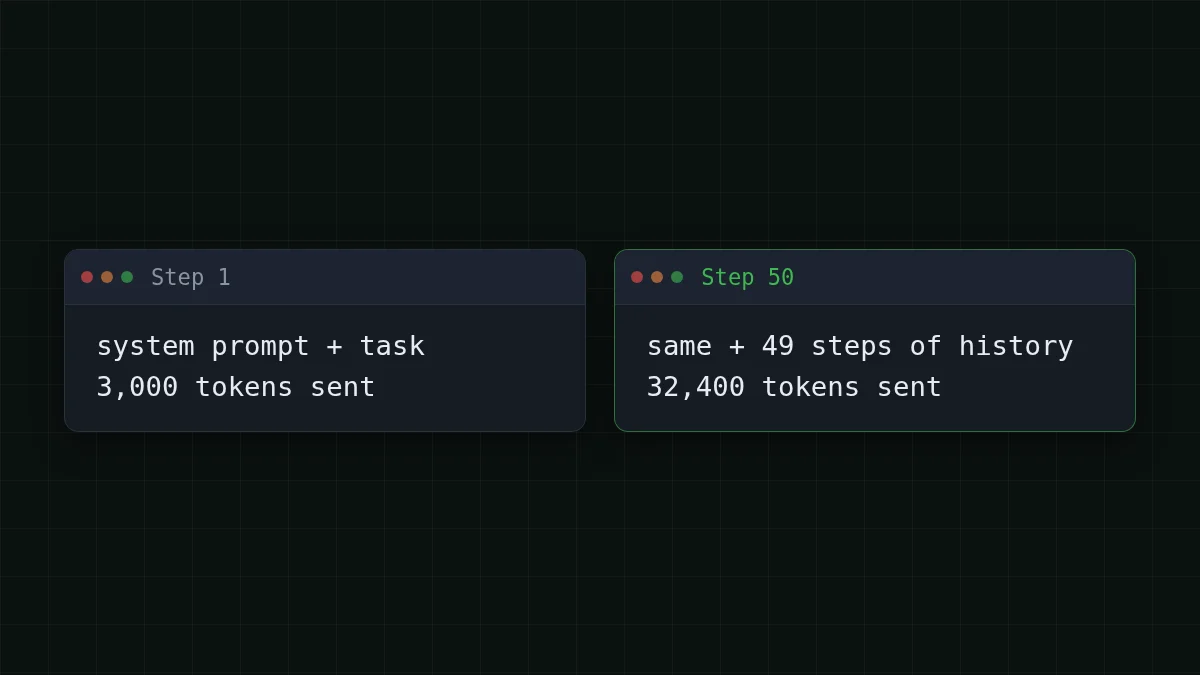
Ein Modell erinnert sich zwischen Aufrufen an nichts. Um eine Aufgabe fortzusetzen, sendet der Agent alles erneut: die Anweisungen, jeden früheren Schritt und was der letzte Schritt produziert hat. Schritt 1 sendet den Startkontext. Schritt 50 sendet den Startkontext plus 49 Schritte Historie. Wenn dir das neu ist, führt warum KI-Agenten so viele Tokens verbrauchen durch ein 20-Schritte-Beispiel.
Nehmen wir an, der Agent startet mit 3.000 Tokens (System-Prompt, Aufgabe, ein paar Dateien) und jeder Schritt fügt etwa 600 Tokens zur Historie hinzu: Der Agent behält eine gekürzte Notiz darüber, was er getan und gesehen hat, und verwirft den Rest. Schritt 50 sendet dann 3.000 + 600 × 49 = 32.400 Tokens. Die Antwort bleibt bei etwa 800 Tokens pro Schritt. Die Frage wächst weiter; die Antwort nicht.
Die Summe über 50 Schritte#
Bevor du rechnest, rate einmal.
Zahl erraten
Wie viele Eingabe-Tokens sendet die gesamte 50-Schritte-Sitzung?
Deine Schätzung
02.000.000
Antwort anzeigen
Antwort: 885.000
Etwa 885.000. Schritt k sendet 3.000 + 600 × (k − 1) Tokens, und über 50 Schritte summiert sich das auf 885.000 — mehr als das Zwanzigfache der 40.000 Tokens, die der Agent schreibt.
Die Summe, in der Reihenfolge, in der du sie auf Papier rechnen würdest:
- Der Startkontext geht 50-mal raus: 50 × 3.000 = 150.000.
- Die Schrittnummern 0 bis 49 summieren sich zu 49 × 50 ÷ 2 = 1.225, und jede Einheit sind 600 Tokens Historie: 600 × 1.225 = 735.000.
- Eingabe insgesamt: 150.000 + 735.000 = 885.000.
- Ausgabe insgesamt: 50 × 800 = 40.000.
Die Historie macht 735.000 der 885.000 aus, und sie wächst schneller als die Schrittanzahl. Verdopple die Aufgabe auf 100 Schritte: 99 × 100 ÷ 2 = 4.950, also ist die Historie 600 × 4.950 = 2.970.000 und der Startkontext 100 × 3.000 = 300.000, was insgesamt 3.270.000 Eingabe-Tokens ergibt. Doppelt so viele Schritte, fast viermal so viel Eingabe. Die Ausgabe verdoppelt sich nur: 100 × 800 = 80.000.
Was die Sitzung auf jedem Modell kostet#
Eine Anfrage wird für Eingabe und Ausgabe zusammen abgerechnet, also vergleiche die Summe. So gezählt sind alle drei Modelle für diese Last insgesamt günstiger als OpenRouter; die OpenRouter-Spalte in der Tabelle zeigt es. Die Preise sind live, daher bleibt die Tabelle aktuell.
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885.000 Input- und 40.000 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Lies es von der Eingabeseite. Etwa 96 von 100 Tokens in dieser Sitzung sind Eingabe, also entscheidet der Eingabepreis über den Großteil der Summe. Eingabe pro 1M Tokens heute: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
Und die Verdopplung, auf DeepSeek-V4-Flash:
Jetzt deine eigene Last. Der durchschnittliche Schritt in unserem Beispiel sendet 885.000 ÷ 50 = 17.700 Eingabe-Tokens und schreibt 800. Fünf solcher Aufgaben an einem Tag sind 5 × 50 = 250 Schritte. Ändere die Zahlen auf deine; der Rechner summiert über die Schritte mit Live-Preisen.
Kostenrechner
Fünf 50-Schritte-Aufgaben an einem Tag
Eingabe-Tokens pro Anfrage: 17.700 · Ausgabe-Tokens pro Anfrage: 800 · Anfragen pro Tag: 250
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
Passt die Historie ins Fenster?#
Kosten sind eine Grenze. Die andere ist das Fenster: Eine Anfrage, die größer als der Kontext des Modells ist, kann gar nicht gesendet werden. Der CheapTokens-Modellkatalog (4. November 2026) listet diese Limits:
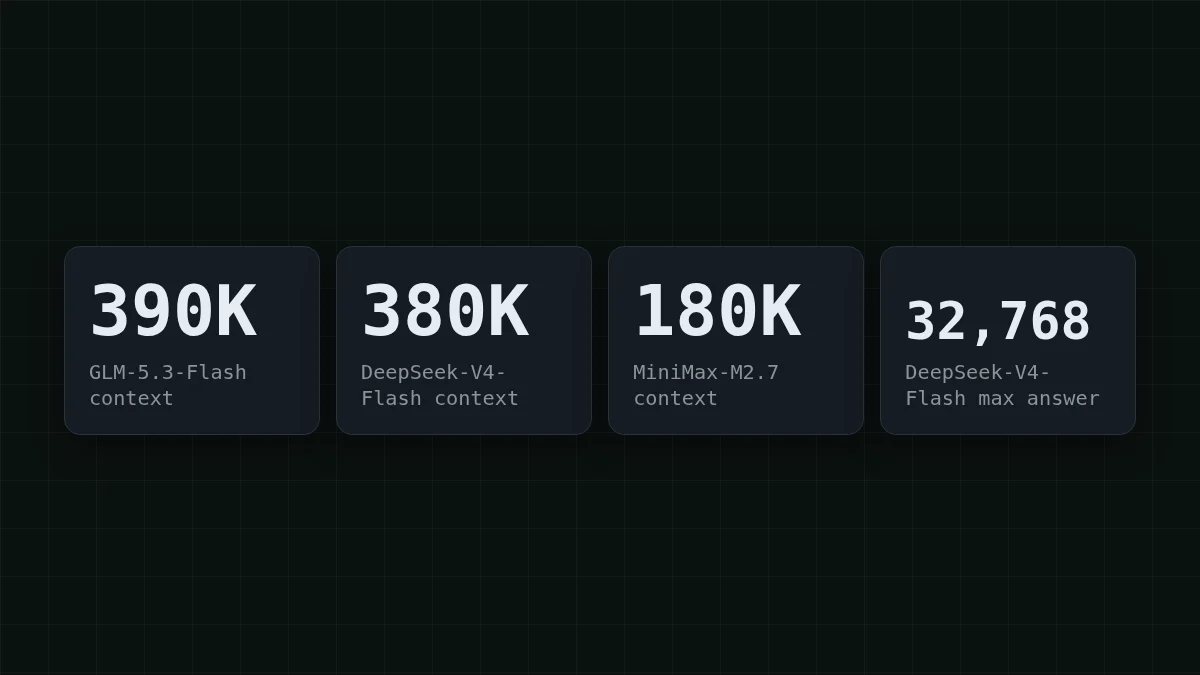
Mit unserem Wachstum von 600 Tokens pro Schritt nähert sich allein die Historie nach vielen Schritten dem Fenster: MiniMax-M2.7 bei etwa Schritt 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash bei etwa Schritt 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash bei etwa Schritt 640 (3.000 + 600 × 639 = 386.400). Eine 50-Schritte-Sitzung nutzt einen kleinen Teil von jedem davon.
Echte Sitzungen sind rauer. Wenn ein Schritt ein großes Log einfügt und 6.000 Tokens statt 600 hinzufügt, endet MiniMax-M2.7s 180K um Schritt 30: 3.000 + 6.000 × 29 = 177.000. Dieselbe Aufgabe passt viel länger in die größeren Fenster.
Das Antwortlimit wirkt andersherum. GLM-5.3-Flash und MiniMax-M2.7 schreiben bis zu 8.192 Tokens pro Antwort, DeepSeek-V4-Flash bis zu 32.768. Angenommen, ein Schritt muss einen 10.000-Token-Bericht produzieren. Beim 8.192-Limit stoppt die Antwort am Limit und finish_reason sagt length; auf DeepSeek-V4-Flash passt es in eine Antwort.
Dieselbe Summe für einen Support-Bot#
Ein Support-Bot ist dieselbe Schleife mit einem Menschen darin. Angenommen, eine Konversation läuft 30 Runden, der System-Prompt und die Regeln belegen 1.000 Tokens, und jede Runde fügt 300 Tokens zur Historie hinzu (100 vom Kunden, 200 vom Bot).
- Startkontext, 30-mal: 30 × 1.000 = 30.000.
- Historie: 29 × 30 ÷ 2 = 435 Einheiten à 300 Tokens, also 300 × 435 = 130.500.
- Eingabe insgesamt: 30.000 + 130.500 = 160.500.
- Ausgabe insgesamt: 30 × 200 = 6.000.
Eine solche Konversation kostet $0.0035 auf GLM-5.3-Flash, $0.003 auf DeepSeek-V4-Flash und $0.0089 auf MiniMax-M2.7. Die Form ist dieselbe: Etwa 96 von 100 Tokens sind Eingabe. Ein Bot mit Tausenden Konversationen pro Tag spürt das in der ersten Woche, und die Historie zu kürzen ist der Hebel. Sliding Window oder Zusammenfassung zeigt wie.
Miss deine eigene Sitzung#
Die obigen Annahmen sind runde Zahlen. Dein Agent hat seine eigenen, und die API sagt sie dir genau: Jede Antwort trägt ein usage-Objekt mit den Eingabe- und Ausgabe-Tokens dieses Aufrufs. Diese Schleife hat dieselbe Form wie ein Agent ohne die Tools: Die Historie wächst, die ganze Liste wird erneut gesendet. Es ist ein Beispiel; tausche den Prompt gegen deine Aufgabe.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Die mittlere Zahl in jeder gedruckten Zeile ist die Eingabe dieses Aufrufs, und sie steigt mit jedem Schritt. Dieser Anstieg ist die Historie. Setze die beiden Summen aus der letzten Zeile in den Kostenrechner oben anstelle von 885000 und 40000 ein, und du hast den Preis deiner Sitzung. Die Basis-URL, Schlüssel und Modell-IDs sind in der CheapTokens-Dokumentation beschrieben.
Welches Modell für deine Sitzung#
Der Preis pro Sitzung steht in der Tabelle. Was sie nicht zeigen kann, ist, ob die Sitzung passt, also wähle nach deinem Fall:
Wähle deinen Fall
Wie sieht dein Agent aus?
Wähle eine Option, um die Antwort zu sehen
Kurze Antworten, Historie bleibt unter 180K
Jedes der drei passt. MiniMax-M2.7s 180K-Fenster fasst Hunderte Schritte wie die obigen, also wähle nach der Kostentabelle. Details zu MiniMax-M2.7.
Lange Historie, kein Kürzen
GLM-5.3-Flash hat das größte Fenster der drei, 390K, mit DeepSeek-V4-Flash dicht dahinter bei 380K. Beide lassen Raum für Sitzungen mit großen Tool- oder Log-Einfügungen. Details zu GLM.
Schritte, die lange Dateien oder Berichte schreiben
DeepSeek-V4-Flash: bis zu 32.768 Tokens in einer Antwort gegenüber 8.192 bei den anderen beiden, plus ein 380K-Fenster. Details zu DeepSeek.
Nächtlicher Batch, niemand schaut zu
Die Preise aller drei sind zu jeder Stunde gleich, ohne Stoßzeiten-Preisgestaltung, also kostet ein nächtlicher Lauf das, was in der Tabelle steht. Dimensioniere das Fenster und das Antwortlimit aus den Abschnitten oben und baue ein Schrittlimit in die Schleife ein.
Alle drei Modelle liegen auf einem CheapTokens-Guthaben hinter derselben OpenAI-kompatiblen Adresse, also ist der Wechsel nach einem Testlauf eine Änderung der Modell-ID. Aktuelle Preise stehen auf der Preisseite; einen direkten Vergleich der Stärken gibt es in GLM vs DeepSeek vs MiniMax.


