Mô hình & so sánhSo sánh
Chi phí phiên agent: 50 bước trên GLM, DeepSeek hay MiniMax
Tính xem một phiên agent 50 bước tốn bao nhiêu khi lịch sử được gửi lại mỗi bước, rồi chọn giữa GLM-5.3-Flash, DeepSeek-V4-Flash và MiniMax-M2.7.
Trên trang này
Agent của bạn chạy mười phút, và hóa đơn còn lớn hơn cả nhiệm vụ. Không có gì lạ xảy ra: mỗi bước gửi lại toàn bộ lịch sử, nên phần đầu vào tăng theo từng bước và cuối cùng chiếm phần lớn chi phí. Với các con số dưới đây, một phiên 50 bước gửi 885.000 token đầu vào và ghi 40.000. Chọn model dựa trên mức độ lịch sử sẽ tăng và độ dài một câu trả lời, sau đó kiểm tra tổng trong bảng.
Tại sao bước 50 tốn hơn bước 1#
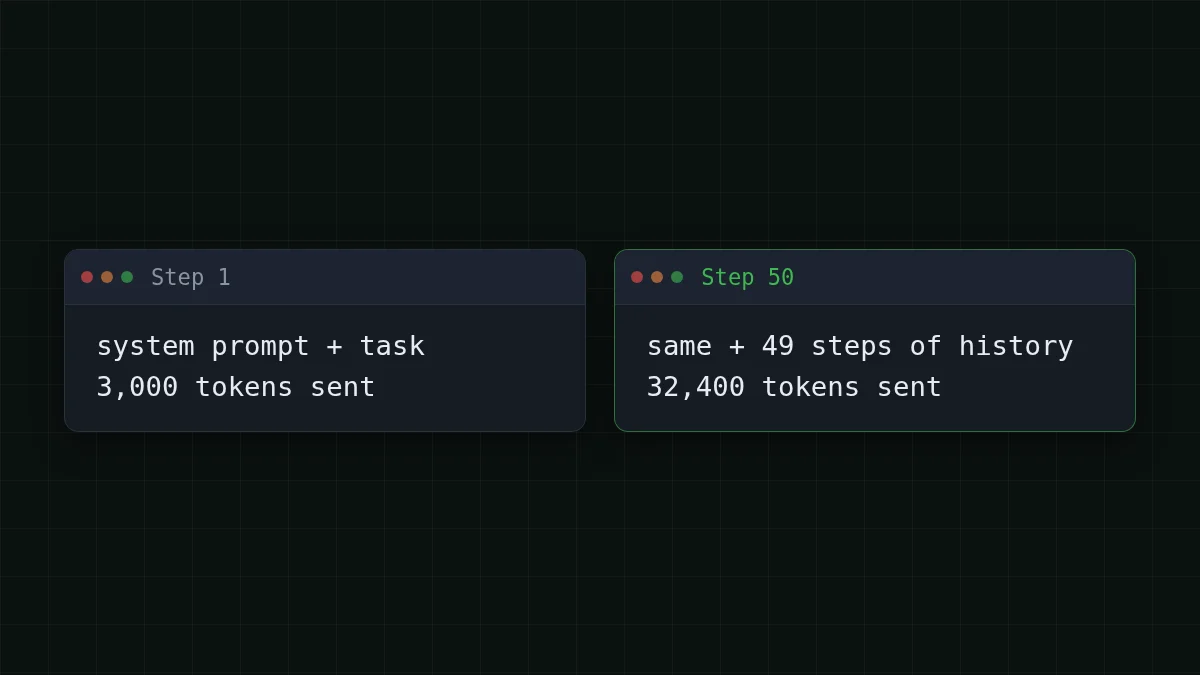
Model không nhớ gì giữa các lần gọi. Để tiếp tục một nhiệm vụ, agent gửi lại mọi thứ: hướng dẫn, mọi bước trước đó, và những gì bước cuối tạo ra. Bước 1 gửi ngữ cảnh khởi đầu. Bước 50 gửi ngữ cảnh khởi đầu cộng với 49 bước lịch sử. Nếu đây là ý tưởng mới với bạn, tại sao AI agent dùng nhiều token đến vậy đi qua một ví dụ 20 bước.
Giả sử agent bắt đầu với 3.000 token (system prompt, nhiệm vụ, vài file) và mỗi bước thêm khoảng 600 token vào lịch sử: agent giữ một ghi chú đã lược bớt về những gì nó đã làm và thấy, và bỏ phần còn lại. Bước 50 sau đó gửi 3.000 + 600 × 49 = 32.400 token. Câu trả lời giữ khoảng 800 token mỗi bước. Câu hỏi cứ tăng; câu trả lời thì không.
Tổng của 50 bước#
Trước khi tính, hãy đoán thử.
Đoán số
Cả phiên 50 bước gửi bao nhiêu token đầu vào?
Dự đoán của bạn
02.000.000
Hiện đáp án
Trả lời: 885.000
Khoảng 885.000. Bước k gửi 3.000 + 600 × (k − 1) token, và qua 50 bước tổng cộng là 885.000 — hơn hai mươi lần 40.000 token agent ghi.
Tổng, theo thứ tự bạn sẽ làm trên giấy:
- Ngữ cảnh khởi đầu được gửi 50 lần: 50 × 3.000 = 150.000.
- Các số bước từ 0 đến 49 cộng lại thành 49 × 50 ÷ 2 = 1.225, và mỗi đơn vị là 600 token lịch sử: 600 × 1.225 = 735.000.
- Tổng đầu vào: 150.000 + 735.000 = 885.000.
- Tổng đầu ra: 50 × 800 = 40.000.
Lịch sử chiếm 735.000 trong 885.000, và nó tăng nhanh hơn số bước. Gấp đôi nhiệm vụ lên 100 bước: 99 × 100 ÷ 2 = 4.950, vậy lịch sử là 600 × 4.950 = 2.970.000 và ngữ cảnh khởi đầu là 100 × 3.000 = 300.000, tổng cộng 3.270.000 token đầu vào. Gấp đôi số bước, gần gấp bốn lần đầu vào. Đầu ra chỉ gấp đôi: 100 × 800 = 80.000.
Phiên tốn bao nhiêu trên mỗi model#
Một yêu cầu được tính tiền cho cả đầu vào và đầu ra, nên hãy so sánh tổng. Tính theo cách đó, cả ba model đều rẻ hơn OpenRouter về tổng cho tải này; cột OpenRouter trong bảng cho thấy điều đó. Giá là trực tiếp, nên bảng luôn cập nhật.
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Chi phí | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
Tổng cộng 885.000 token đầu vào và 40.000 token đầu ra. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Đọc từ phía đầu vào. Khoảng 96 trong mỗi 100 token trong phiên này là đầu vào, nên giá đầu vào quyết định phần lớn tổng. Giá đầu vào trên 1M token hôm nay: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
Và sự gấp đôi, trên DeepSeek-V4-Flash:
Giờ đến tải của bạn. Bước trung bình trong ví dụ của chúng tôi gửi 885.000 ÷ 50 = 17.700 token đầu vào và ghi 800. Năm nhiệm vụ như vậy trong một ngày là 5 × 50 = 250 bước. Thay số bằng của bạn; máy tính cộng qua các bước với giá trực tiếp.
Máy tính chi phí
Năm nhiệm vụ 50 bước trong một ngày
Token đầu vào mỗi yêu cầu: 17.700 · Token đầu ra mỗi yêu cầu: 800 · Số yêu cầu mỗi ngày: 250
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
Lịch sử có vừa cửa sổ không?#
Chi phí là một giới hạn. Giới hạn kia là cửa sổ: một yêu cầu lớn hơn ngữ cảnh của model không thể gửi được. Danh mục model CheapTokens (4 tháng 11, 2026) liệt kê các giới hạn này:
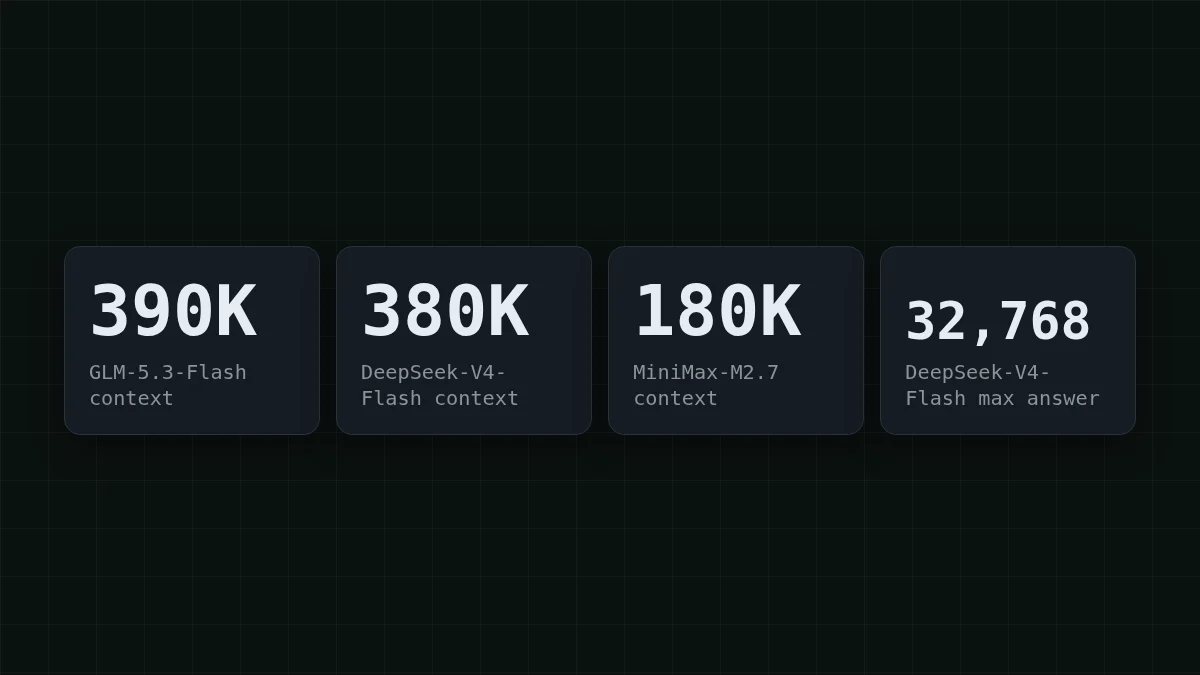
Với mức tăng 600 token mỗi bước của chúng tôi, chỉ riêng lịch sử đã gần cửa sổ sau nhiều bước: MiniMax-M2.7 ở khoảng bước 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash ở khoảng bước 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash ở khoảng bước 640 (3.000 + 600 × 639 = 386.400). Một phiên 50 bước dùng một phần nhỏ của bất kỳ cửa sổ nào.
Các phiên thực tế thì gồ ghề hơn. Nếu một bước dán một log lớn và thêm 6.000 token thay vì 600, cửa sổ 180K của MiniMax-M2.7 kết thúc quanh bước 30: 3.000 + 6.000 × 29 = 177.000. Cùng nhiệm vụ đó vừa với các cửa sổ lớn hơn lâu hơn nhiều.
Giới hạn câu trả lời hoạt động ngược lại. GLM-5.3-Flash và MiniMax-M2.7 viết tối đa 8.192 token mỗi câu trả lời, DeepSeek-V4-Flash tối đa 32.768. Giả sử một bước phải tạo một báo cáo 10.000 token. Với giới hạn 8.192, câu trả lời dừng ở mức trần và finish_reason báo length; trên DeepSeek-V4-Flash nó vừa trong một câu trả lời.
Cùng phép tính cho một bot hỗ trợ#
Bot hỗ trợ là cùng vòng lặp với một người ở trong. Giả sử một cuộc hội thoại kéo dài 30 lượt, system prompt và quy tắc chiếm 1.000 token, và mỗi lượt thêm 300 token vào lịch sử (100 từ khách hàng, 200 từ bot).
- Ngữ cảnh khởi đầu, 30 lần: 30 × 1.000 = 30.000.
- Lịch sử: 29 × 30 ÷ 2 = 435 đơn vị 300 token, vậy 300 × 435 = 130.500.
- Tổng đầu vào: 30.000 + 130.500 = 160.500.
- Tổng đầu ra: 30 × 200 = 6.000.
Một cuộc hội thoại như vậy tốn $0.0035 trên GLM-5.3-Flash, $0.003 trên DeepSeek-V4-Flash và $0.0089 trên MiniMax-M2.7. Hình dạng là như nhau: khoảng 96 trong mỗi 100 token là đầu vào. Một bot với hàng nghìn cuộc hội thoại mỗi ngày cảm nhận điều này trong tuần đầu tiên, và cắt bớt lịch sử là đòn bẩy. Cửa sổ trượt hay tóm tắt cho thấy cách làm.
Đo phiên của chính bạn#
Các giả định trên là số tròn. Agent của bạn có số riêng, và API cho bạn biết chính xác: mỗi phản hồi mang một đối tượng usage với token đầu vào và đầu ra của lần gọi đó. Vòng lặp này có cùng hình dạng như một agent không có công cụ: lịch sử tăng, toàn bộ danh sách được gửi lại. Đây là ví dụ; thay prompt bằng nhiệm vụ của bạn.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Con số ở giữa trên mỗi dòng in là đầu vào của lần gọi đó, và nó tăng mỗi bước. Sự tăng đó là lịch sử. Đặt hai tổng từ dòng cuối vào máy tính chi phí ở trên thay cho 885000 và 40000 và bạn có giá của phiên mình. Base URL, khóa và model id được mô tả trong tài liệu CheapTokens.
Model nào cho phiên của bạn#
Giá mỗi phiên có trong bảng. Điều nó không thể hiện là phiên có vừa không, nên hãy chọn theo trường hợp của bạn:
Chọn trường hợp của bạn
Agent của bạn trông như thế nào?
Chọn một tùy chọn để xem đáp án
Câu trả lời ngắn, lịch sử dưới 180K
Bất kỳ model nào trong ba đều vừa. Cửa sổ 180K của MiniMax-M2.7 chứa hàng trăm bước như trên, nên chọn theo bảng chi phí. Chi tiết về MiniMax-M2.7.
Lịch sử dài, không cắt bớt
GLM-5.3-Flash có cửa sổ lớn nhất trong ba, 390K, với DeepSeek-V4-Flash sát ngay sau ở 380K. Cả hai đều để chỗ cho các phiên có dán công cụ hoặc log lớn. Chi tiết về GLM.
Các bước ghi file hoặc báo cáo dài
DeepSeek-V4-Flash: tối đa 32.768 token trong một câu trả lời so với 8.192 trên hai model kia, cộng với cửa sổ 380K. Chi tiết về DeepSeek.
Batch qua đêm, không ai trông
Giá trên cả ba model là như nhau vào bất kỳ giờ nào, không có giá giờ cao điểm, nên một lần chạy qua đêm tốn đúng như bảng ghi. Định cỡ cửa sổ và giới hạn câu trả lời từ các phần trên và đặt giới hạn số bước trong vòng lặp.
Cả ba model nằm trên một số dư CheapTokens sau cùng một địa chỉ tương thích OpenAI, nên sau một lần chạy thử, chuyển đổi chỉ là đổi model id. Giá hiện tại ở trang giá; so sánh điểm mạnh ở GLM vs DeepSeek vs MiniMax.


