Modelli e confrontiConfronto
Costo di una sessione agente: 50 passi su GLM, DeepSeek o MiniMax
Calcola quanto costa una sessione agente da 50 passi quando la cronologia viene reinviata a ogni passo, poi scegli tra GLM-5.3-Flash, DeepSeek-V4-Flash e MiniMax-M2.7.
In questa pagina
Il tuo agente ha girato per dieci minuti e il conto è più grande del task. Niente di strano: ogni passo reinvia l'intera cronologia, quindi il lato input cresce a ogni passo e finisce per essere la maggior parte del costo. Con i numeri qui sotto, una sessione da 50 passi invia 885.000 token di input e ne scrive 40.000. Scegli il modello in base a quanto crescerà la cronologia e a quanto deve essere lunga una risposta, poi controlla il totale nella tabella.
Perché il passo 50 costa più del passo 1#
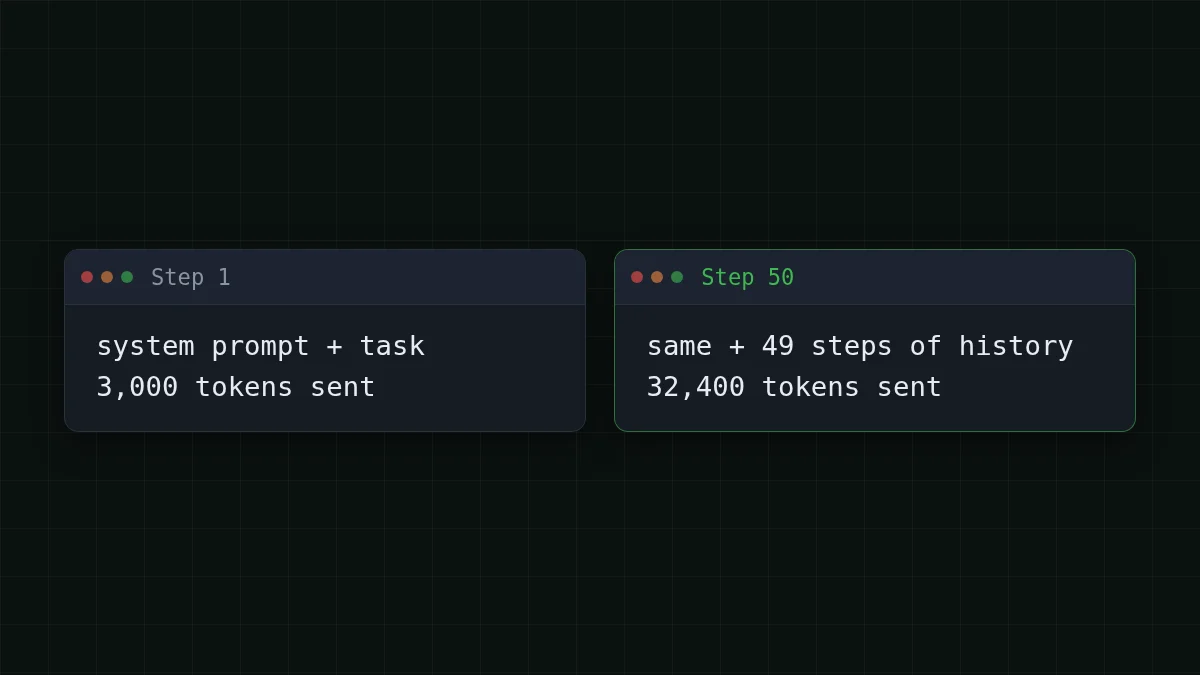
Un modello non ricorda nulla tra una chiamata e l'altra. Per continuare un task, l'agente invia di nuovo tutto: le istruzioni, ogni passo precedente e ciò che ha prodotto l'ultimo passo. Il passo 1 invia il contesto iniziale. Il passo 50 invia il contesto iniziale più 49 passi di cronologia. Se l'idea è nuova per te, perché gli agenti AI usano così tanti token illustra un esempio di 20 passi.
Supponiamo che l'agente parta con 3.000 token (system prompt, task, qualche file) e che ogni passo aggiunga circa 600 token alla cronologia: l'agente tiene una nota ridotta di ciò che ha fatto e visto, e scarta il resto. Il passo 50 invia quindi 3.000 + 600 × 49 = 32.400 token. La risposta resta intorno agli 800 token a passo. La domanda continua a crescere; la risposta no.
La somma dei 50 passi#
Prima dell'aritmetica, prova a indovinare.
Indovina il numero
Quanti token di input invia l'intera sessione da 50 passi?
La tua risposta
02.000.000
Mostra risposta
Risposta: 885.000
Circa 885.000. Il passo k invia 3.000 + 600 × (k − 1) token, e su 50 passi si arriva a 885.000 — più di venti volte i 40.000 token che l'agente scrive.
La somma, nell'ordine in cui la faresti su carta:
- Il contesto iniziale viene inviato 50 volte: 50 × 3.000 = 150.000.
- I numeri di passo da 0 a 49 sommano a 49 × 50 ÷ 2 = 1.225, e ogni unità è 600 token di cronologia: 600 × 1.225 = 735.000.
- Input totale: 150.000 + 735.000 = 885.000.
- Output totale: 50 × 800 = 40.000.
La cronologia è 735.000 degli 885.000, e cresce più velocemente del numero di passi. Raddoppia il task a 100 passi: 99 × 100 ÷ 2 = 4.950, quindi la cronologia è 600 × 4.950 = 2.970.000 e il contesto iniziale è 100 × 3.000 = 300.000, per un totale di 3.270.000 token di input. Il doppio dei passi, quasi quattro volte l'input. L'output raddoppia soltanto: 100 × 800 = 80.000.
Quanto costa la sessione su ciascun modello#
Una richiesta viene fatturata per input e output insieme, quindi confronta il totale. Contato così, tutti e tre i modelli risultano più economici di OpenRouter in totale per questo carico; la colonna OpenRouter nella tabella lo mostra. I prezzi sono live, quindi la tabella resta aggiornata.
| Modello | Input $/1M | Output $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885.000 token di input e 40.000 token di output in totale. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Leggila dal lato input. Circa 96 token su 100 in questa sessione sono input, quindi il prezzo dell'input decide la maggior parte del totale. Input per 1M token oggi: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
E il raddoppio, su DeepSeek-V4-Flash:
Ora il tuo carico. Il passo medio nel nostro esempio invia 885.000 ÷ 50 = 17.700 token di input e ne scrive 800. Cinque task così in un giorno sono 5 × 50 = 250 passi. Sostituisci i numeri con i tuoi; il calcolatore somma sui passi con prezzi live.
Calcolatore di costi
Cinque task da 50 passi in un giorno
Token di input per richiesta: 17.700 · Token di output per richiesta: 800 · Richieste al giorno: 250
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
La cronologia entra nella finestra?#
Il costo è un limite. L'altro è la finestra: una richiesta più grande del contesto del modello non può essere inviata affatto. Il catalogo modelli CheapTokens (4 novembre 2026) elenca questi limiti:
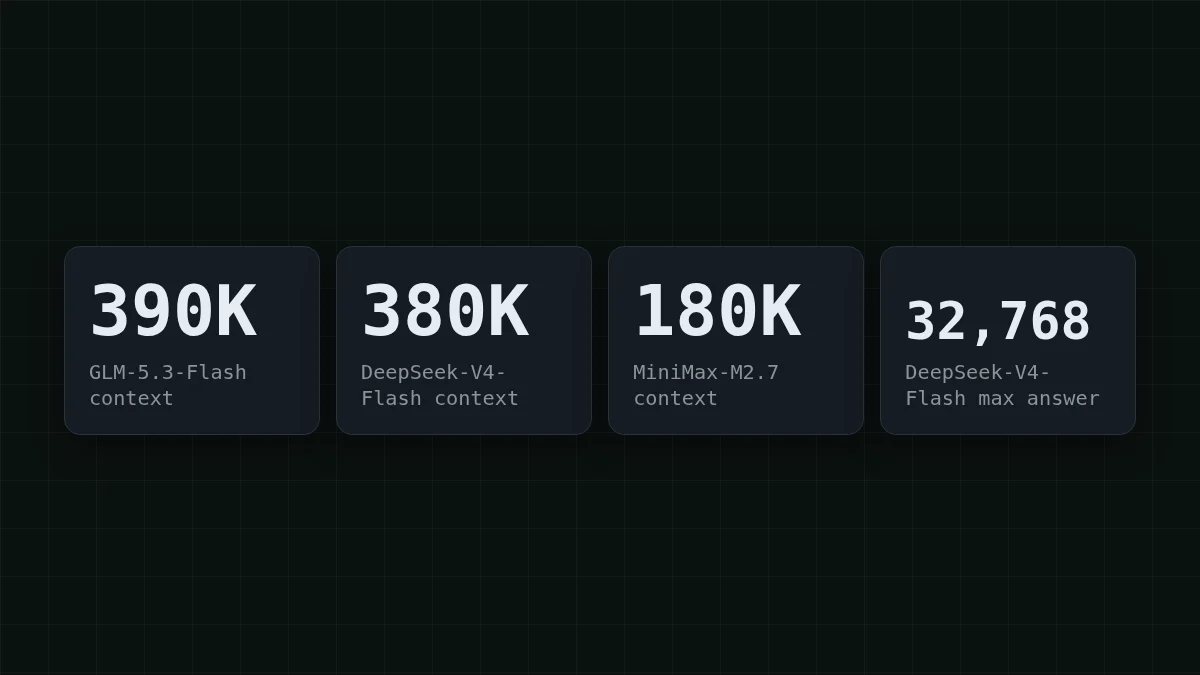
Con la nostra crescita di 600 token a passo, la sola cronologia si avvicina alla finestra dopo molti passi: MiniMax-M2.7 intorno al passo 290 (3.000 + 600 × 289 = 176.400), DeepSeek-V4-Flash intorno al passo 620 (3.000 + 600 × 619 = 374.400), GLM-5.3-Flash intorno al passo 640 (3.000 + 600 × 639 = 386.400). Una sessione da 50 passi usa una piccola parte di ciascuna.
Le sessioni reali sono più irregolari. Se un passo incolla un log grande e aggiunge 6.000 token invece di 600, i 180K di MiniMax-M2.7 finiscono intorno al passo 30: 3.000 + 6.000 × 29 = 177.000. Lo stesso task entra nelle finestre più grandi per molto più tempo.
Il limite di risposta funziona al contrario. GLM-5.3-Flash e MiniMax-M2.7 scrivono fino a 8.192 token per risposta, DeepSeek-V4-Flash fino a 32.768. Supponiamo che un passo debba produrre un report da 10.000 token. Con il limite di 8.192 la risposta si ferma al tetto e finish_reason dice length; su DeepSeek-V4-Flash entra in una sola risposta.
La stessa somma per un bot di supporto#
Un bot di supporto è lo stesso ciclo con una persona dentro. Supponiamo che una conversazione duri 30 turni, che il system prompt e le regole occupino 1.000 token e che ogni turno aggiunga 300 token alla cronologia (100 dal cliente, 200 dal bot).
- Contesto iniziale, 30 volte: 30 × 1.000 = 30.000.
- Cronologia: 29 × 30 ÷ 2 = 435 unità da 300 token, quindi 300 × 435 = 130.500.
- Input totale: 30.000 + 130.500 = 160.500.
- Output totale: 30 × 200 = 6.000.
Una conversazione così costa $0.0035 su GLM-5.3-Flash, $0.003 su DeepSeek-V4-Flash e $0.0089 su MiniMax-M2.7. La forma è la stessa: circa 96 token su 100 sono input. Un bot con migliaia di conversazioni al giorno lo sente nella prima settimana, e ridurre la cronologia è la leva. Finestra scorrevole o riassunto mostra come.
Misura la tua sessione#
Le ipotesi sopra sono numeri tondi. Il tuo agente ha le sue, e l'API te lo dice esattamente: ogni risposta porta un oggetto usage con i token di input e output di quella chiamata. Questo ciclo ha la stessa forma di un agente senza i tool: la cronologia cresce, l'intera lista viene reinviata. È un esempio; sostituisci il prompt con il tuo task.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Il numero centrale su ogni riga stampata è l'input di quella chiamata, e sale a ogni passo. Quella salita è la cronologia. Metti i due totali dell'ultima riga nel calcolatore di costi sopra al posto di 885000 e 40000 e hai il prezzo della tua sessione. L'URL di base, le chiavi e gli id dei modelli sono descritti nella documentazione CheapTokens.
Quale modello per la tua sessione#
Il prezzo per sessione è nella tabella. Quello che non può mostrare è se la sessione entra, quindi scegli in base al tuo caso:
Scegli il tuo caso
Che aspetto ha il tuo agente?
Scegli un'opzione per vedere la risposta
Risposte brevi, cronologia sotto i 180K
Va bene uno qualsiasi dei tre. La finestra da 180K di MiniMax-M2.7 contiene centinaia di passi come quelli sopra, quindi scegli in base alla tabella dei costi. Dettagli su MiniMax-M2.7.
Cronologia lunga, nessun taglio
GLM-5.3-Flash ha la finestra più grande dei tre, 390K, con DeepSeek-V4-Flash subito dietro a 380K. Entrambi lasciano spazio a sessioni con grandi incollaggi di tool o log. Dettagli su GLM.
Passi che scrivono file o report lunghi
DeepSeek-V4-Flash: fino a 32.768 token in una risposta contro 8.192 sugli altri due, più una finestra da 380K. Dettagli su DeepSeek.
Batch notturno, nessuno che guarda
I prezzi su tutti e tre sono gli stessi a qualsiasi ora, senza prezzi di punta, quindi un'esecuzione notturna costa quanto dice la tabella. Dimensiona la finestra e il limite di risposta dalle sezioni sopra e metti un limite di passi nel ciclo.
Tutti e tre i modelli stanno su un unico saldo CheapTokens dietro lo stesso indirizzo compatibile OpenAI, quindi dopo una prova il passaggio è un cambio di id modello. I prezzi attuali sono sulla pagina dei prezzi; un confronto affiancato dei punti di forza è in GLM vs DeepSeek vs MiniMax.


