โมเดลและการเปรียบเทียบการเปรียบเทียบ
ค่าใช้จ่ายเซสชันเอเจนต์: 50 ขั้นบน GLM, DeepSeek หรือ MiniMax
คำนวณค่าใช้จ่ายของเซสชันเอเจนต์ 50 ขั้นเมื่อประวัติถูกส่งซ้ำทุกขั้น แล้วเลือกระหว่าง GLM-5.3-Flash, DeepSeek-V4-Flash และ MiniMax-M2.7
ในหน้านี้
เอเจนต์ของคุณทำงานสิบห้านาที และค่าใช้จ่ายสูงกว่างานที่ทำ ไม่มีอะไรผิดปกติ: ทุกขั้นตอนส่งประวัติทั้งหมดซ้ำ ดังนั้นฝั่งอินพุตจึงโตขึ้นทุกขั้นและกลายเป็นค่าใช้จ่ายส่วนใหญ่ ด้วยตัวเลขด้านล่าง เซสชัน 50 ขั้นส่งโทเค็นอินพุต 885,000 และเขียน 40,000 เลือกโมเดลตามว่าประวัติจะโตแค่ไหนและคำตอบหนึ่งต้องยาวเท่าใด จากนั้นตรวจสอบยอดรวมในตาราง
ทำไมขั้นที่ 50 แพงกว่าขั้นที่ 1#
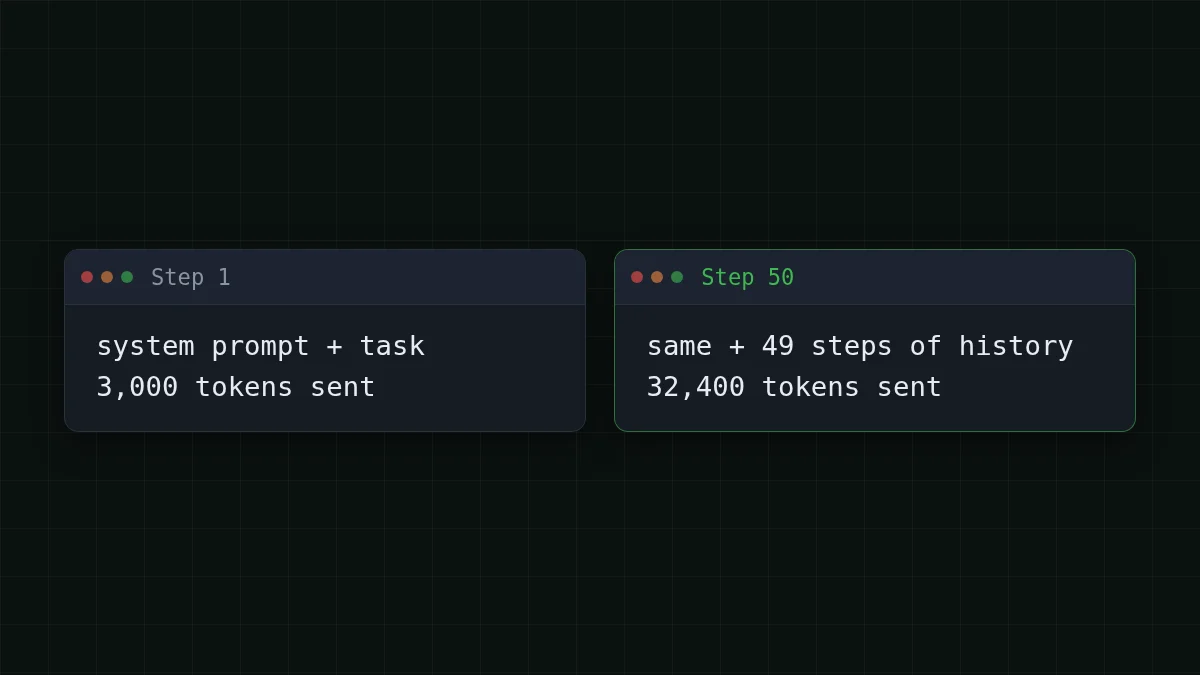
โมเดลไม่จำอะไรระหว่างการเรียก เพื่อทำงานต่อ เอเจนต์ส่งทุกอย่างซ้ำ: คำสั่ง ทุกขั้นก่อนหน้า และสิ่งที่ขั้นล่าสุดสร้างขึ้น ขั้นที่ 1 ส่งบริบทเริ่มต้น ขั้นที่ 50 ส่งบริบทเริ่มต้นบวกประวัติ 49 ขั้น หากแนวคิดนี้ใหม่สำหรับคุณ ทำไมเอเจนต์ AI จึงใช้โทเค็นมากมาย อธิบายตัวอย่าง 20 ขั้น
สมมติว่าเอเจนต์เริ่มด้วย 3,000 โทเค็น (พรอมต์ระบบ งาน ไฟล์ไม่กี่ไฟล์) และแต่ละขั้นเพิ่มประวัติประมาณ 600 โทเค็น: เอเจนต์เก็บบันทึกย่อที่ตัดแต่งแล้วว่าทำอะไรและเห็นอะไร และทิ้งส่วนที่เหลือ ขั้นที่ 50 จึงส่ง 3,000 + 600 × 49 = 32,400 โทเค็น คำตอบยังคงอยู่ที่ประมาณ 800 โทเค็นต่อขั้น คำถามโตขึ้นเรื่อยๆ คำตอบไม่โต
ผลรวม 50 ขั้น#
ก่อนคำนวณ ลองเดาดูก่อน
ทายตัวเลข
เซสชัน 50 ขั้นทั้งหมดส่งโทเค็นอินพุตกี่โทเค็น?
คำตอบของคุณ
02,000,000
แสดงคำตอบ
คำตอบ: 885,000
ประมาณ 885,000 ขั้นที่ k ส่ง 3,000 + 600 × (k − 1) โทเค็น และเมื่อรวม 50 ขั้นได้ 885,000 — มากกว่าสองสิบเท่าของ 40,000 โทเค็นที่เอเจนต์เขียน
ผลรวมตามลำดับที่คุณจะทำบนกระดาษ:
- บริบทเริ่มต้นถูกส่ง 50 ครั้ง: 50 × 3,000 = 150,000
- หมายเลขขั้น 0 ถึง 49 รวมกันได้ 49 × 50 ÷ 2 = 1,225 และแต่ละหน่วยคือประวัติ 600 โทเค็น: 600 × 1,225 = 735,000
- อินพุตรวม: 150,000 + 735,000 = 885,000
- เอาต์พุตรวม: 50 × 800 = 40,000
ประวัติคือ 735,000 จาก 885,000 และมันโตเร็วกว่าจำนวนขั้น เพิ่มงานเป็นสองเท่าเป็น 100 ขั้น: 99 × 100 ÷ 2 = 4,950 ดังนั้นประวัติคือ 600 × 4,950 = 2,970,000 และบริบทเริ่มต้นคือ 100 × 3,000 = 300,000 ซึ่งรวมเป็นโทเค็นอินพุต 3,270,000 ทั้งหมด ขั้นเป็นสองเท่า อินพุตเกือบสี่เท่า เอาต์พุตเพิ่มเป็นสองเท่าเท่านั้น: 100 × 800 = 80,000
เซสชันมีค่าใช้จ่ายเท่าไรในแต่ละโมเดล#
คำขอถูกคิดค่าบริการทั้งอินพุตและเอาต์พุตรวมกัน ดังนั้นเปรียบเทียบยอดรวม เมื่อนับแบบนั้น ทั้งสามโมเดลมีราคาถูกกว่า OpenRouter โดยรวมสำหรับโหลดนี้ คอลัมน์ OpenRouter ในตารางแสดงให้เห็น ราคาเป็นแบบเรียลไทม์ ตารางจึงเป็นปัจจุบันเสมอ
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885,000 โทเค็นอินพุตและ 40,000 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
อ่านจากฝั่งอินพุต ประมาณ 96 จากทุก 100 โทเค็นในเซสชันนี้เป็นอินพุต ดังนั้นราคาอินพุตจึงกำหนดยอดรวมส่วนใหญ่ ราคาอินพุตต่อ 1M โทเค็นวันนี้: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05
และการเพิ่มเป็นสองเท่า บน DeepSeek-V4-Flash:
ตอนนี้โหลดของคุณเอง ขั้นเฉลี่ยในตัวอย่างของเราส่ง 885,000 ÷ 50 = 17,700 โทเค็นอินพุตและเขียน 800 ห้างานดังกล่าวในหนึ่งวันคือ 5 × 50 = 250 ขั้น เปลี่ยนตัวเลขเป็นของคุณ เครื่องคำนวณจะรวมตามขั้นด้วยราคาเรียลไทม์
เครื่องคำนวณค่าใช้จ่าย
ห้างาน 50 ขั้นในหนึ่งวัน
โทเค็นอินพุตต่อคำขอ: 17,700 · โทเค็นเอาต์พุตต่อคำขอ: 800 · คำขอต่อวัน: 250
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
ประวัติพอดีกับหน้าต่างหรือไม่?#
ค่าใช้จ่ายเป็นขีดจำกัดหนึ่ง อีกอย่างคือหน้าต่าง: คำขอที่ใหญ่กว่าบริบทของโมเดลไม่สามารถส่งได้เลย แคตตาล็อกโมเดล CheapTokens (4 พฤศจิกายน 2026) แสดงขีดจำกัดเหล่านี้:
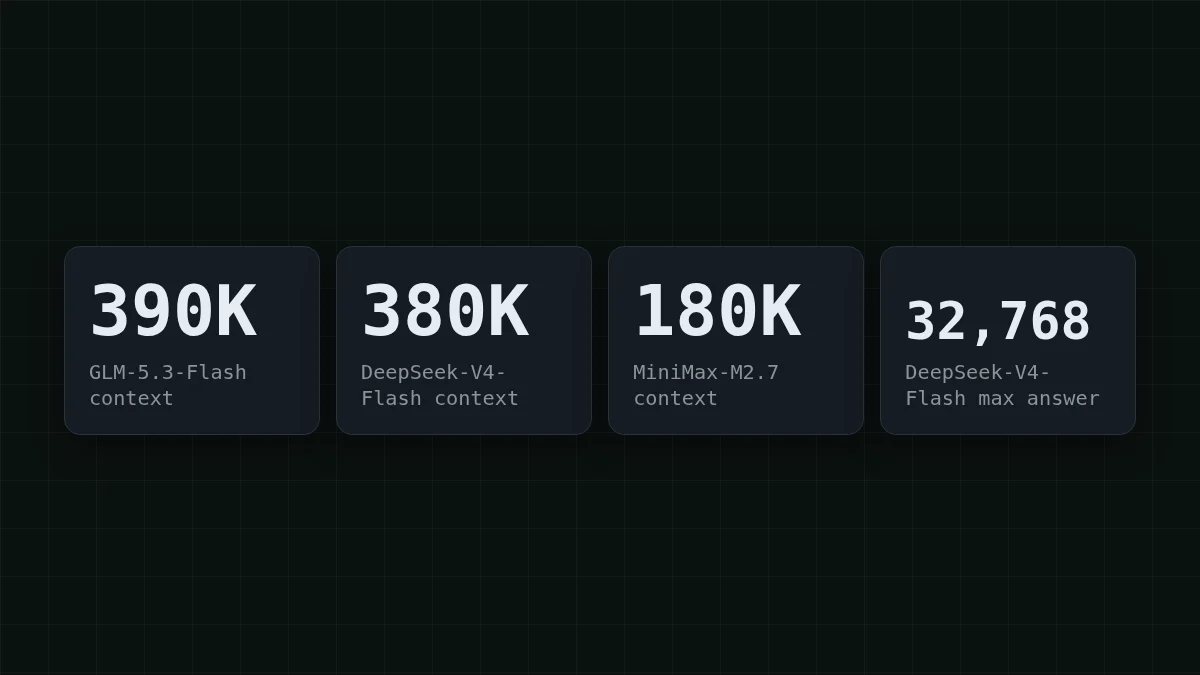
ด้วยการเติบโต 600 โทเค็นต่อขั้นของเรา ประวัติอย่างเดียวเข้าใกล้หน้าต่างหลังจากหลายขั้น: MiniMax-M2.7 ที่ประมาณขั้น 290 (3,000 + 600 × 289 = 176,400), DeepSeek-V4-Flash ที่ประมาณขั้น 620 (3,000 + 600 × 619 = 374,400), GLM-5.3-Flash ที่ประมาณขั้น 640 (3,000 + 600 × 639 = 386,400) เซสชัน 50 ขั้นใช้เพียงส่วนเล็กๆ ของโมเดลใดก็ได้
เซสชันจริงหยาบกว่า หากขั้นหนึ่งวางล็อกขนาดใหญ่และเพิ่ม 6,000 โทเค็นแทน 600 หน้าต่าง 180K ของ MiniMax-M2.7 จะสิ้นสุดราวขั้น 30: 3,000 + 6,000 × 29 = 177,000 งานเดียวกันพอดีกับหน้าต่างที่ใหญ่กว่าอีกนาน
ขีดจำกัดคำตอบทำงานตรงกันข้าม GLM-5.3-Flash และ MiniMax-M2.7 เขียนได้สูงสุด 8,192 โทเค็นต่อคำตอบ DeepSeek-V4-Flash สูงสุด 32,768 สมมติว่าขั้นหนึ่งต้องสร้างรายงาน 10,000 โทเค็น บนขีดจำกัด 8,192 การตอบกลับหยุดที่ขีดจำกัดและ finish_reason กล่าวว่า length; บน DeepSeek-V4-Flash มันพอดีในคำตอบเดียว
ผลรวมเดียวกันสำหรับบอทสนับสนุน#
บอทสนับสนุนคือลูปเดียวกันที่มีคนอยู่ด้วย สมมติว่าบทสนทนาดำเนิน 30 รอบ พรอมต์ระบบและกฎใช้ 1,000 โทเค็น และแต่ละรอบเพิ่มประวัติ 300 โทเค็น (100 จากลูกค้า 200 จากบอท)
- บริบทเริ่มต้น 30 ครั้ง: 30 × 1,000 = 30,000
- ประวัติ: 29 × 30 ÷ 2 = 435 หน่วยของ 300 โทเค็น ดังนั้น 300 × 435 = 130,500
- อินพุตรวม: 30,000 + 130,500 = 160,500
- เอาต์พุตรวม: 30 × 200 = 6,000
บทสนทนาหนึ่งครั้งมีค่าใช้จ่าย $0.0035 บน GLM-5.3-Flash, $0.003 บน DeepSeek-V4-Flash และ $0.0089 บน MiniMax-M2.7 รูปแบบเดียวกัน: ประมาณ 96 จากทุก 100 โทเค็นเป็นอินพุต บอทที่มีบทสนทนาหลายพันครั้งต่อวันจะรู้สึกได้ในสัปดาห์แรก และการตัดแต่งประวัติคือคันโยก หน้าต่างเลื่อนหรือสรุป แสดงวิธี
วัดเซสชันของคุณเอง#
สมมติฐานข้างต้นเป็นตัวเลขกลม เอเจนต์ของคุณมีของตัวเอง และ API บอกคุณอย่างแม่นยำ: ทุกการตอบกลับมีออบเจ็กต์ usage พร้อมโทเค็นอินพุตและเอาต์พุตของการเรียกนั้น ลูปนี้มีรูปแบบเดียวกับเอเจนต์ที่ไม่มีเครื่องมือ: ประวัติโตขึ้น รายการทั้งหมดถูกส่งซ้ำ เป็นเพียงตัวอย่าง; เปลี่ยนพรอมต์เป็นงานของคุณ
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
ตัวเลขกลางในแต่ละบรรทัดที่พิมพ์คืออินพุตของการเรียกนั้น และมันเพิ่มขึ้นทุกขั้น การเพิ่มขึ้นนั้นคือประวัติ ใส่ยอดรวมสองค่าจากบรรทัดสุดท้ายลงในเครื่องคำนวณค่าใช้จ่ายด้านบนแทน 885000 และ 40000 แล้วคุณจะได้ราคาเซสชันของคุณ URL ฐาน คีย์ และรหัสโมเดลอธิบายไว้ใน เอกสาร CheapTokens
โมเดลไหนสำหรับเซสชันของคุณ#
ราคาต่อเซสชันอยู่ในตาราง สิ่งที่ตารางแสดงไม่ได้คือเซสชันพอดีหรือไม่ ดังนั้นเลือกตามกรณีของคุณ:
เลือกกรณีของคุณ
เอเจนต์ของคุณเป็นแบบไหน?
เลือกตัวเลือกเพื่อดูคำตอบ
คำตอบสั้น ประวัติอยู่ต่ำกว่า 180K
ทั้งสามโมเดลพอดี หน้าต่าง 180K ของ MiniMax-M2.7 รองรับหลายร้อยขั้นเช่นข้างต้น ดังนั้นเลือกตามตารางค่าใช้จ่าย รายละเอียดที่ MiniMax-M2.7
ประวัติยาว ไม่ตัดแต่ง
GLM-5.3-Flash มีหน้าต่างใหญ่ที่สุดในสามโมเดล 390K โดย DeepSeek-V4-Flash ตามมาใกล้ๆ ที่ 380K ทั้งคู่เหลือที่ว่างสำหรับเซสชันที่มีการวางเครื่องมือหรือล็อกขนาดใหญ่ รายละเอียดที่ GLM
ขั้นที่เขียนไฟล์หรือรายงานยาว
DeepSeek-V4-Flash: สูงสุด 32,768 โทเค็นในคำตอบเดียว เทียบกับ 8,192 ในอีกสองโมเดล บวกหน้าต่าง 380K รายละเอียดที่ DeepSeek
แบตช์ข้ามคืน ไม่มีคนเฝ้า
ราคาของทั้งสามโมเดลเท่ากันทุกชั่วโมง ไม่มีราคาช่วงพีค ดังนั้นการรันข้ามคืนมีค่าใช้จ่ายตามตาราง กำหนดขนาดหน้าต่างและขีดจำกัดคำตอบจากส่วนข้างต้นและใส่ขีดจำกัดขั้นในลูป
ทั้งสามโมเดลอยู่บนยอดเงิน CheapTokens เดียวกันหลังที่อยู่ที่เข้ากันได้กับ OpenAI เดียวกัน ดังนั้นหลังการทดลองรัน การสลับคือการเปลี่ยนรหัสโมเดล ราคาปัจจุบันอยู่ที่ หน้าราคา; การเปรียบเทียบจุดแข็งแบบเคียงข้างกันอยู่ใน GLM vs DeepSeek vs MiniMax


