मॉडल और तुलनातुलना
एजेंट सत्र लागत: GLM, DeepSeek या MiniMax पर 50 चरण
पता करें कि 50-चरणीय एजेंट सत्र की लागत क्या है जब हर चरण में इतिहास फिर से भेजा जाता है, फिर GLM-5.3-Flash, DeepSeek-V4-Flash और MiniMax-M2.7 के बीच चुनें।
इस पृष्ठ पर
आपका एजेंट दस मिनट तक चला, और बिल काम से बड़ा है। कुछ अजीब नहीं हुआ: हर चरण पूरा इतिहास फिर से भेजता है, इसलिए इनपुट पक्ष हर चरण के साथ बढ़ता है और अंत में लागत का अधिकांश हिस्सा बन जाता है। नीचे दिए गए आंकड़ों के साथ, 50-चरणीय सत्र 885,000 इनपुट टोकन भेजता है और 40,000 लिखता है। मॉडल इस आधार पर चुनें कि इतिहास कितना बढ़ेगा और एक उत्तर कितना लंबा होना चाहिए, फिर तालिका में कुल जांचें।
चरण 50, चरण 1 से अधिक महंगा क्यों है#
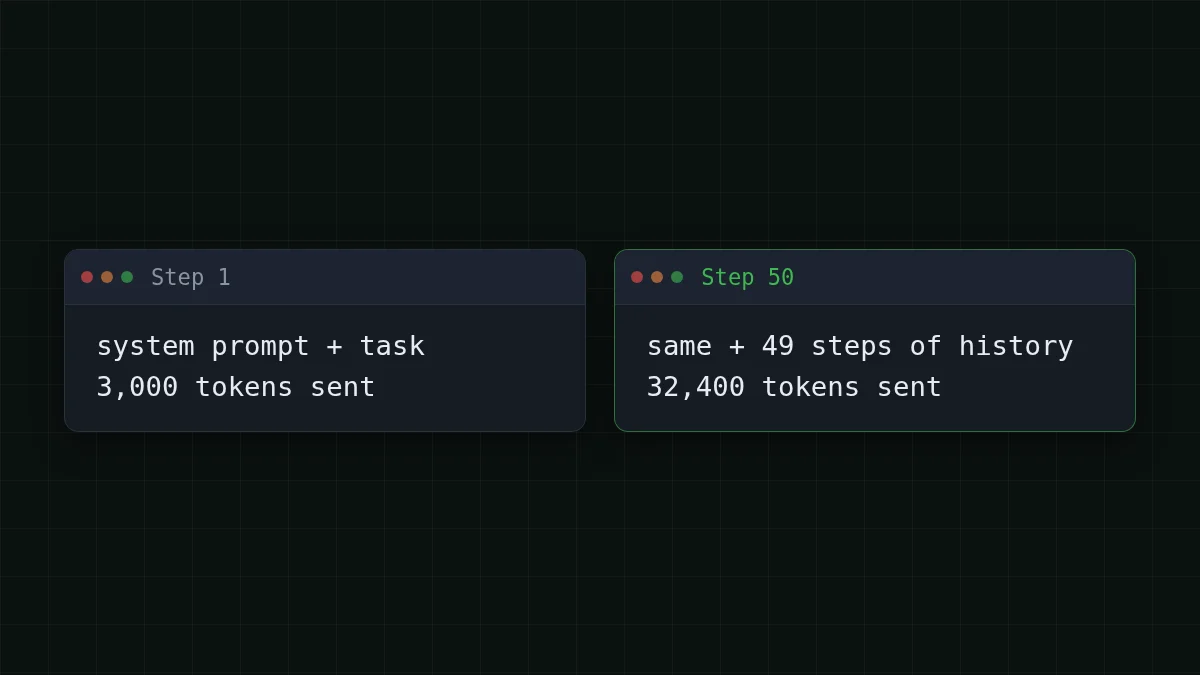
एक मॉडल कॉल के बीच कुछ याद नहीं रखता। कार्य जारी रखने के लिए, एजेंट सब कुछ फिर से भेजता है: निर्देश, हर पिछला चरण, और पिछले चरण ने क्या उत्पन्न किया। चरण 1 प्रारंभिक संदर्भ भेजता है। चरण 50 प्रारंभिक संदर्भ प्लस 49 चरणों का इतिहास भेजता है। यदि विचार आपके लिए नया है, तो AI एजेंट इतने सारे टोकन क्यों उपयोग करते हैं 20-चरणीय उदाहरण के माध्यम से चलता है।
मान लें कि एजेंट 3,000 टोकन (सिस्टम प्रॉम्प्ट, कार्य, कुछ फ़ाइलें) से शुरू होता है और हर चरण इतिहास में लगभग 600 टोकन जोड़ता है: एजेंट अपने किए और देखे गए काम का एक छोटा नोट रखता है और बाकी छोड़ देता है। चरण 50 तब 3,000 + 600 × 49 = 32,400 टोकन भेजता है। उत्तर प्रति चरण लगभग 800 टोकन रहता है। प्रश्न बढ़ता रहता है; उत्तर नहीं।
50-चरणीय योग#
गणित से पहले, एक अनुमान लगाएं।
संख्या का अनुमान लगाएँ
पूरा 50-चरणीय सत्र कितने इनपुट टोकन भेजता है?
आपका अनुमान
020,00,000
उत्तर दिखाएँ
उत्तर: 8,85,000
लगभग 885,000। चरण k 3,000 + 600 × (k − 1) टोकन भेजता है, और 50 चरणों में यह 885,000 तक जुड़ता है — एजेंट द्वारा लिखे गए 40,000 टोकन से बीस गुना से अधिक।
योग, उसी क्रम में जैसे आप कागज पर करेंगे:
- प्रारंभिक संदर्भ 50 बार जाता है: 50 × 3,000 = 150,000।
- चरण संख्याएँ 0 से 49 का योग 49 × 50 ÷ 2 = 1,225 है, और प्रत्येक इकाई 600 टोकन इतिहास है: 600 × 1,225 = 735,000।
- कुल इनपुट: 150,000 + 735,000 = 885,000।
- कुल आउटपुट: 50 × 800 = 40,000।
इतिहास 885,000 में से 735,000 है, और यह चरण संख्या से तेजी से बढ़ता है। कार्य को दोगुना करके 100 चरण करें: 99 × 100 ÷ 2 = 4,950, इसलिए इतिहास 600 × 4,950 = 2,970,000 है और प्रारंभिक संदर्भ 100 × 3,000 = 300,000 है, जो कुल मिलाकर 3,270,000 इनपुट टोकन बनाता है। दोगुने चरण, लगभग चार गुना इनपुट। आउटपुट केवल दोगुना होता है: 100 × 800 = 80,000।
प्रत्येक मॉडल पर सत्र की लागत#
एक अनुरोध का बिल इनपुट और आउटपुट दोनों के लिए एक साथ होता है, इसलिए कुल की तुलना करें। इस तरह गिनने पर, इस लोड के लिए तीनों मॉडल कुल मिलाकर OpenRouter से सस्ते निकलते हैं; तालिका में OpenRouter कॉलम इसे दर्शाता है। कीमतें लाइव हैं, इसलिए तालिका अद्यतित रहती है।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | लागत | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
कुल 8,85,000 इनपुट और 40,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
इसे इनपुट पक्ष से पढ़ें। इस सत्र में हर 100 टोकन में से लगभग 96 इनपुट हैं, इसलिए इनपुट मूल्य कुल का अधिकांश निर्धारित करता है। आज प्रति 1M टोकन इनपुट: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05।
और दोगुना करना, DeepSeek-V4-Flash पर:
अब अपना लोड। हमारे उदाहरण में औसत चरण 885,000 ÷ 50 = 17,700 इनपुट टोकन भेजता है और 800 लिखता है। एक दिन में ऐसे पाँच कार्य 5 × 50 = 250 चरण हैं। संख्याओं को अपनी संख्याओं में बदलें; कैलकुलेटर लाइव कीमतों के साथ चरणों पर योग करता है।
लागत कैलकुलेटर
एक दिन में पाँच 50-चरणीय कार्य
प्रति अनुरोध इनपुट टोकन: 17,700 · प्रति अनुरोध आउटपुट टोकन: 800 · प्रति दिन अनुरोध: 250
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
क्या इतिहास विंडो में फिट बैठता है?#
लागत एक सीमा है। दूसरी विंडो है: मॉडल के संदर्भ से बड़ा अनुरोध बिल्कुल नहीं भेजा जा सकता। CheapTokens मॉडल कैटलॉग (4 नवंबर 2026) इन सीमाओं को सूचीबद्ध करता है:
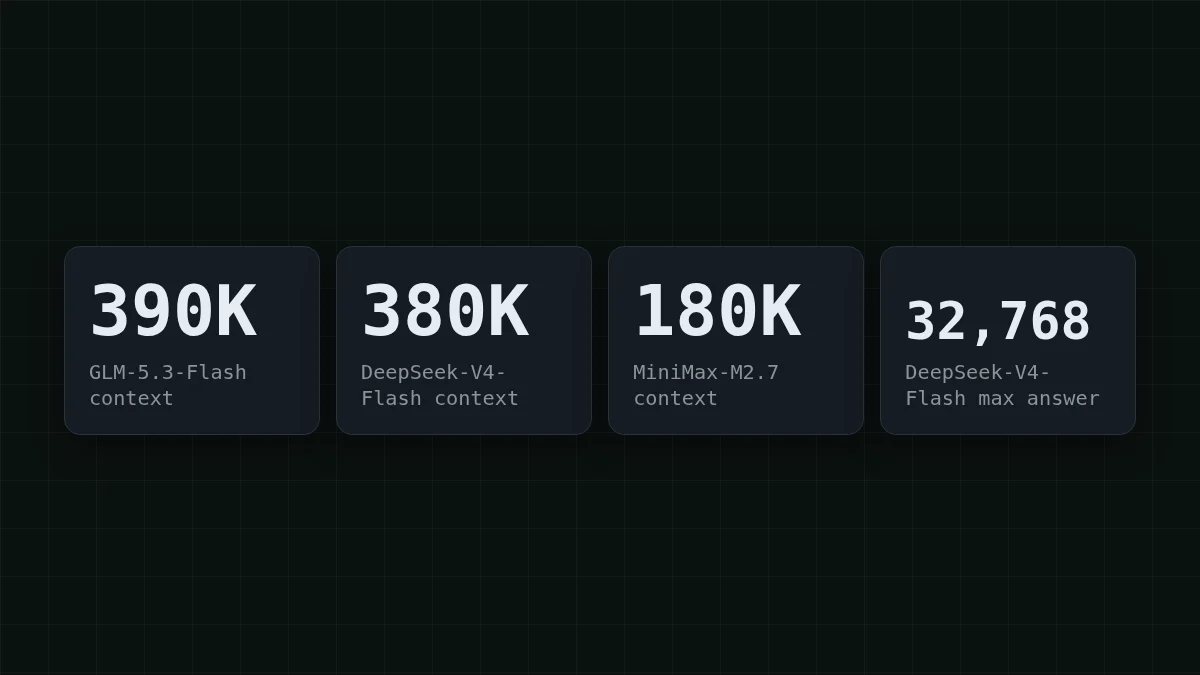
प्रति चरण 600 टोकन की हमारी वृद्धि के साथ, अकेला इतिहास कई चरणों के बाद विंडो के करीब पहुँच जाता है: MiniMax-M2.7 लगभग चरण 290 पर (3,000 + 600 × 289 = 176,400), DeepSeek-V4-Flash लगभग चरण 620 पर (3,000 + 600 × 619 = 374,400), GLM-5.3-Flash लगभग चरण 640 पर (3,000 + 600 × 639 = 386,400)। 50-चरणीय सत्र इनमें से किसी का भी छोटा हिस्सा उपयोग करता है।
वास्तविक सत्र अधिक उबड़-खाबड़ होते हैं। यदि कोई चरण एक बड़ा लॉग चिपकाता है और 600 के बजाय 6,000 टोकन जोड़ता है, तो MiniMax-M2.7 का 180K लगभग चरण 30 पर समाप्त हो जाता है: 3,000 + 6,000 × 29 = 177,000। वही कार्य बड़ी विंडो में बहुत अधिक समय तक फिट बैठता है।
उत्तर सीमा उलटी दिशा में काम करती है। GLM-5.3-Flash और MiniMax-M2.7 प्रति उत्तर अधिकतम 8,192 टोकन लिखते हैं, DeepSeek-V4-Flash अधिकतम 32,768। मान लें कि एक चरण को 10,000-टोकन रिपोर्ट तैयार करनी है। 8,192 सीमा पर उत्तर कैप पर रुक जाता है और finish_reason कहता है length; DeepSeek-V4-Flash पर यह एक उत्तर में फिट हो जाता है।
सपोर्ट बॉट के लिए वही योग#
सपोर्ट बॉट वही लूप है जिसमें एक व्यक्ति है। मान लें कि बातचीत 30 मोड़ चलती है, सिस्टम प्रॉम्प्ट और नियम 1,000 टोकन लेते हैं, और प्रत्येक मोड़ इतिहास में 300 टोकन जोड़ता है (ग्राहक से 100, बॉट से 200)।
- प्रारंभिक संदर्भ, 30 बार: 30 × 1,000 = 30,000।
- इतिहास: 29 × 30 ÷ 2 = 300 टोकन की 435 इकाइयाँ, इसलिए 300 × 435 = 130,500।
- कुल इनपुट: 30,000 + 130,500 = 160,500।
- कुल आउटपुट: 30 × 200 = 6,000।
ऐसी एक बातचीत की लागत GLM-5.3-Flash पर $0.0035, DeepSeek-V4-Flash पर $0.003 और MiniMax-M2.7 पर $0.0089 है। आकार वही है: हर 100 टोकन में से लगभग 96 इनपुट हैं। एक दिन में हज़ारों बातचीत वाला बॉट इसे पहले सप्ताह में महसूस करता है, और इतिहास को छोटा करना ही उपाय है। स्लाइडिंग विंडो या सारांश दिखाता है कि कैसे।
अपना सत्र मापें#
ऊपर की धारणाएँ गोल संख्याएँ हैं। आपके एजेंट की अपनी हैं, और API आपको बिल्कुल बताता है: प्रत्येक प्रतिक्रिया में उस कॉल के इनपुट और आउटपुट टोकन के साथ एक usage ऑब्जेक्ट होता है। इस लूप का आकार टूल्स के बिना एजेंट जैसा ही है: इतिहास बढ़ता है, पूरी सूची फिर से भेजी जाती है। यह एक उदाहरण है; प्रॉम्प्ट को अपने कार्य से बदलें।
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
प्रत्येक मुद्रित पंक्ति पर मध्य संख्या उस कॉल का इनपुट है, और यह हर चरण बढ़ती है। वह वृद्धि इतिहास है। अंतिम पंक्ति से दोनों कुलों को ऊपर दिए गए लागत कैलकुलेटर में 885000 और 40000 के स्थान पर डालें और आपके पास अपने सत्र की कीमत होगी। बेस URL, कुंजियाँ और मॉडल आईडी CheapTokens दस्तावेज़ में वर्णित हैं।
आपके सत्र के लिए कौन सा मॉडल#
प्रति सत्र कीमत तालिका में है। जो यह नहीं दिखा सकती वह यह है कि सत्र फिट बैठता है या नहीं, इसलिए अपने मामले के अनुसार चुनें:
अपना मामला चुनें
आपका एजेंट कैसा दिखता है?
उत्तर देखने के लिए एक विकल्प चुनें
छोटे उत्तर, इतिहास 180K से नीचे रहता है
तीनों में से कोई भी फिट बैठता है। MiniMax-M2.7 की 180K विंडो ऊपर जैसे सैकड़ों चरणों को रखती है, इसलिए लागत तालिका से चुनें। MiniMax-M2.7 पर विवरण।
लंबा इतिहास, कोई ट्रिमिंग नहीं
GLM-5.3-Flash की तीनों में सबसे बड़ी विंडो है, 390K, और DeepSeek-V4-Flash 380K के साथ करीब है। दोनों बड़े टूल या लॉग पेस्ट वाले सत्रों के लिए जगह छोड़ते हैं। GLM पर विवरण।
ऐसे चरण जो लंबी फ़ाइलें या रिपोर्ट लिखते हैं
DeepSeek-V4-Flash: अन्य दो पर 8,192 के मुकाबले एक उत्तर में अधिकतम 32,768 टोकन, साथ ही 380K विंडो। DeepSeek पर विवरण।
रात भर का बैच, कोई देखने वाला नहीं
तीनों पर कीमतें किसी भी घंटे समान हैं, कोई पीक-आवर मूल्य नहीं, इसलिए रात भर का रन तालिका के अनुसार खर्च होता है। ऊपर के अनुभागों से विंडो और उत्तर सीमा का आकार निर्धारित करें और लूप में एक चरण सीमा डालें।
तीनों मॉडल एक ही OpenAI-संगत पते के पीछे एक CheapTokens बैलेंस पर बैठे हैं, इसलिए परीक्षण रन के बाद स्विच करना मॉडल आईडी का बदलाव है। वर्तमान कीमतें मूल्य पृष्ठ पर हैं; ताकतों का साथ-साथ तुलना GLM बनाम DeepSeek बनाम MiniMax में है।


