Modele i porównaniaPorównanie
Koszt sesji agenta: 50 kroków na GLM, DeepSeek lub MiniMax
Oblicz, ile kosztuje 50-krokowa sesja agenta, gdy historia jest wysyłana ponownie przy każdym kroku, a następnie wybierz między GLM-5.3-Flash, DeepSeek-V4-Flash i MiniMax-M2.7.
Na tej stronie
Twój agent działał przez dziesięć minut, a rachunek jest większy niż samo zadanie. Nic dziwnego się nie stało: każdy krok ponownie wysyła całą historię, więc strona wejściowa rośnie z każdym krokiem i ostatecznie stanowi większość kosztu. Przy liczbach poniżej sesja 50-krokowa wysyła 885 000 tokenów wejściowych i zapisuje 40 000. Wybierz model według tego, jak bardzo wzrośnie historia i jak długa musi być jedna odpowiedź, a następnie sprawdź sumę w tabeli.
Dlaczego krok 50 kosztuje więcej niż krok 1#
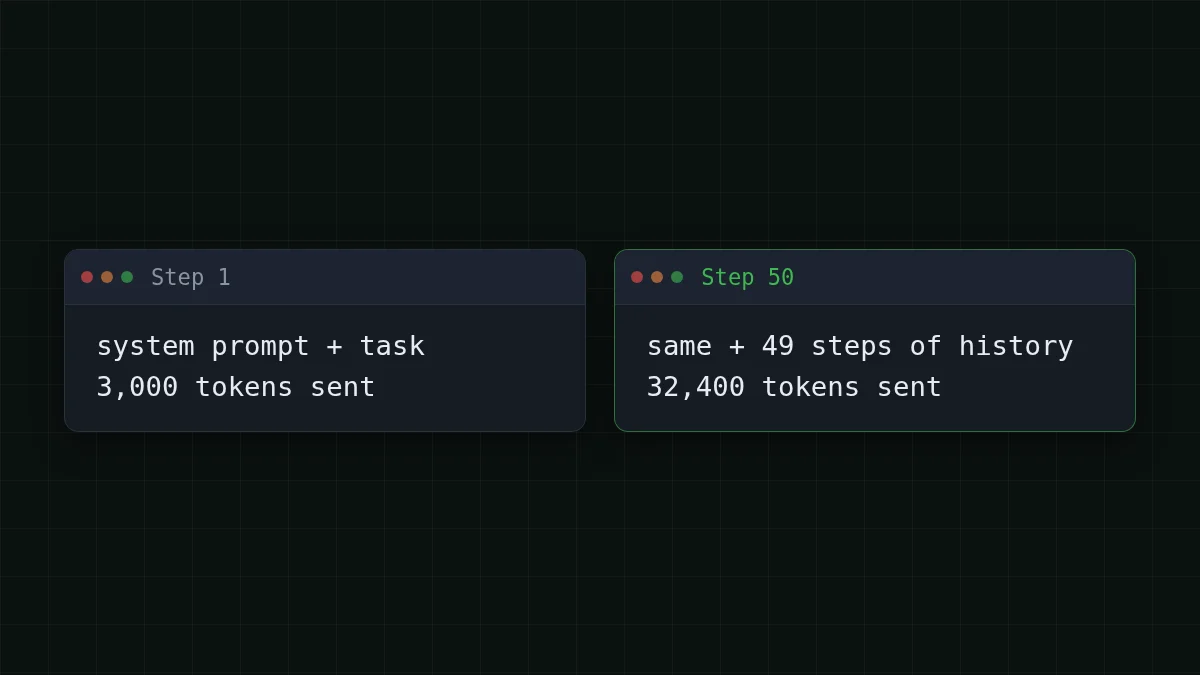
Model nie pamięta niczego między wywołaniami. Aby kontynuować zadanie, agent wysyła wszystko ponownie: instrukcje, każdy wcześniejszy krok i to, co wyprodukował ostatni krok. Krok 1 wysyła kontekst początkowy. Krok 50 wysyła kontekst początkowy plus 49 kroków historii. Jeśli ten pomysł jest dla Ciebie nowy, dlaczego agenci AI używają tak wielu tokenów przechodzi przez 20-krokowy przykład.
Powiedzmy, że agent zaczyna z 3000 tokenami (prompt systemowy, zadanie, kilka plików), a każdy krok dodaje około 600 tokenów do historii: agent prowadzi skróconą notatkę o tym, co zrobił i zobaczył, a resztę odrzuca. Krok 50 wysyła wtedy 3000 + 600 × 49 = 32 400 tokenów. Odpowiedź pozostaje na poziomie około 800 tokenów na krok. Pytanie stale rośnie; odpowiedź nie.
Suma 50 kroków#
Zanim przejdziemy do arytmetyki, zgadnij.
Zgadnij liczbę
Ile tokenów wejściowych wysyła cała sesja 50-krokowa?
Twoje przypuszczenie
02 000 000
Pokaż odpowiedź
Odpowiedź: 885 000
Około 885 000. Krok k wysyła 3000 + 600 × (k − 1) tokenów, a przez 50 kroków sumuje się to do 885 000 — ponad dwadzieścia razy więcej niż 40 000 tokenów, które agent zapisuje.
Suma, w kolejności, w jakiej zrobiłbyś to na papierze:
- Kontekst początkowy jest wysyłany 50 razy: 50 × 3000 = 150 000.
- Numery kroków od 0 do 49 sumują się do 49 × 50 ÷ 2 = 1225, a każda jednostka to 600 tokenów historii: 600 × 1225 = 735 000.
- Wejście w sumie: 150 000 + 735 000 = 885 000.
- Wyjście w sumie: 50 × 800 = 40 000.
Historia to 735 000 z 885 000 i rośnie szybciej niż liczba kroków. Podwój zadanie do 100 kroków: 99 × 100 ÷ 2 = 4950, więc historia to 600 × 4950 = 2 970 000, a kontekst początkowy to 100 × 3000 = 300 000, co daje w sumie 3 270 000 tokenów wejściowych. Dwa razy więcej kroków, prawie cztery razy więcej wejścia. Wyjście tylko się podwaja: 100 × 800 = 80 000.
Ile kosztuje sesja na każdym modelu#
Żądanie jest rozliczane za wejście i wyjście razem, więc porównaj sumę. Liczone w ten sposób, wszystkie trzy modele wypadają taniej niż OpenRouter w sumie dla tego obciążenia; kolumna OpenRouter w tabeli to pokazuje. Ceny są aktualne, więc tabela pozostaje aktualna.
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885 000 tokenów wejściowych i 40 000 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Czytaj to od strony wejścia. Około 96 na każde 100 tokenów w tej sesji to wejście, więc cena wejścia decyduje o większości sumy. Wejście za 1 mln tokenów dziś: DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
A podwojenie, na DeepSeek-V4-Flash:
Teraz Twoje własne obciążenie. Przeciętny krok w naszym przykładzie wysyła 885 000 ÷ 50 = 17 700 tokenów wejściowych i zapisuje 800. Pięć takich zadań dziennie to 5 × 50 = 250 kroków. Zmień liczby na swoje; kalkulator sumuje po krokach z aktualnymi cenami.
Kalkulator kosztów
Pięć zadań 50-krokowych w jeden dzień
Tokeny wejściowe na żądanie: 17 700 · Tokeny wyjściowe na żądanie: 800 · Żądania dziennie: 250
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
Czy historia mieści się w oknie?#
Koszt to jeden limit. Drugi to okno: żądanie większe niż kontekst modelu nie może zostać wysłane. Katalog modeli CheapTokens (4 listopada 2026) wymienia te limity:
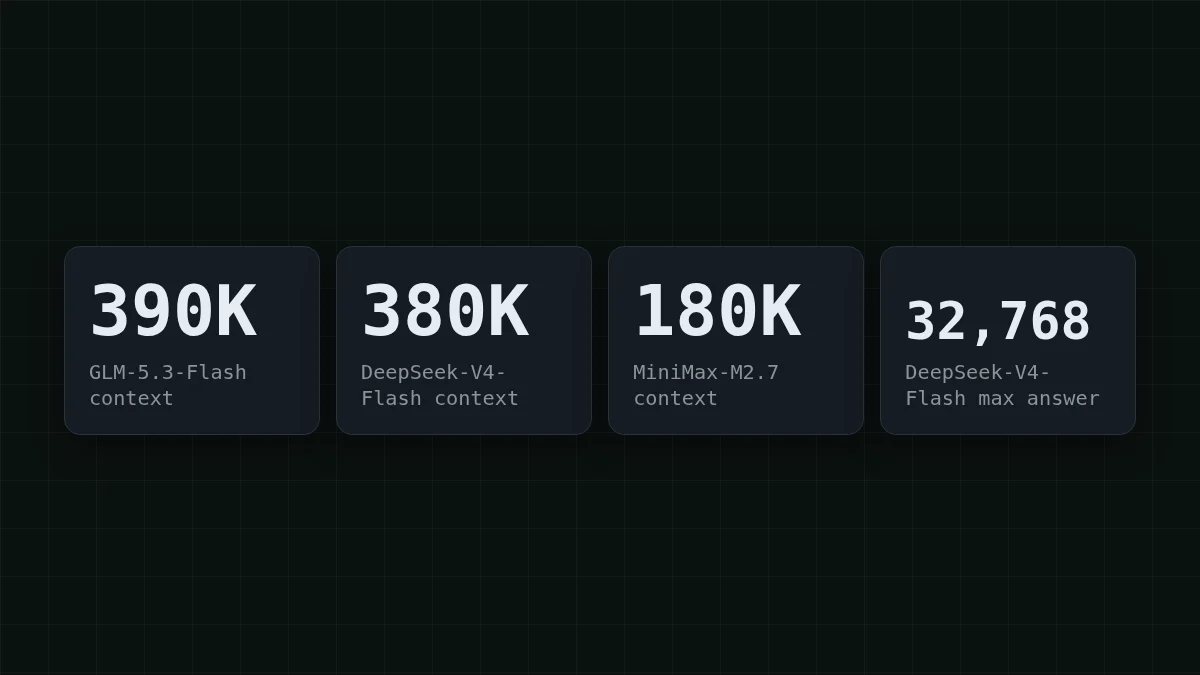
Przy naszym wzroście 600 tokenów na krok sama historia zbliża się do okna po wielu krokach: MiniMax-M2.7 przy około kroku 290 (3000 + 600 × 289 = 176 400), DeepSeek-V4-Flash przy około kroku 620 (3000 + 600 × 619 = 374 400), GLM-5.3-Flash przy około kroku 640 (3000 + 600 × 639 = 386 400). Sesja 50-krokowa wykorzystuje niewielką część każdego z nich.
Prawdziwe sesje są bardziej nierówne. Jeśli jeden krok wklei duży log i doda 6000 tokenów zamiast 600, 180K MiniMax-M2.7 kończy się około kroku 30: 3000 + 6000 × 29 = 177 000. To samo zadanie mieści się w większych oknach znacznie dłużej.
Limit odpowiedzi działa w drugą stronę. GLM-5.3-Flash i MiniMax-M2.7 piszą do 8192 tokenów na odpowiedź, DeepSeek-V4-Flash do 32 768. Powiedzmy, że jeden krok musi wygenerować raport o długości 10 000 tokenów. Przy limicie 8192 odpowiedź zatrzymuje się na limicie i finish_reason mówi length; na DeepSeek-V4-Flash mieści się w jednej odpowiedzi.
Ta sama suma dla bota wsparcia#
Bot wsparcia to ta sama pętla z człowiekiem w środku. Powiedzmy, że rozmowa trwa 30 tur, prompt systemowy i reguły zajmują 1000 tokenów, a każda tura dodaje 300 tokenów do historii (100 od klienta, 200 od bota).
- Kontekst początkowy, 30 razy: 30 × 1000 = 30 000.
- Historia: 29 × 30 ÷ 2 = 435 jednostek po 300 tokenów, więc 300 × 435 = 130 500.
- Wejście w sumie: 30 000 + 130 500 = 160 500.
- Wyjście w sumie: 30 × 200 = 6000.
Jedna taka rozmowa kosztuje $0.0035 na GLM-5.3-Flash, $0.003 na DeepSeek-V4-Flash i $0.0089 na MiniMax-M2.7. Kształt jest ten sam: około 96 na każde 100 tokenów to wejście. Bot z tysiącami rozmów dziennie odczuwa to w pierwszym tygodniu, a przycinanie historii jest dźwignią. Okno przesuwne lub podsumowanie pokazuje jak.
Zmierz własną sesję#
Powyższe założenia to okrągłe liczby. Twój agent ma własne, a API mówi dokładnie: każda odpowiedź zawiera obiekt usage z tokenami wejściowymi i wyjściowymi tego wywołania. Ta pętla ma ten sam kształt co agent bez narzędzi: historia rośnie, cała lista jest wysyłana ponownie. To przykład; zamień prompt na swoje zadanie.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Środkowa liczba w każdym drukowanym wierszu to wejście tego wywołania i rośnie z każdym krokiem. Ten wzrost to historia. Wstaw dwie sumy z ostatniego wiersza do kalkulatora kosztów powyżej w miejsce 885000 i 40000, a otrzymasz cenę swojej sesji. Bazowy URL, klucze i identyfikatory modeli są opisane w dokumentacji CheapTokens.
Który model dla Twojej sesji#
Cena za sesję jest w tabeli. Czego nie może pokazać, to czy sesja się mieści, więc wybierz według swojego przypadku:
Wybierz swój przypadek
Jak wygląda Twój agent?
Wybierz opcję, aby zobaczyć odpowiedź
Krótkie odpowiedzi, historia poniżej 180K
Każdy z trzech pasuje. Okno 180K MiniMax-M2.7 mieści setki kroków takich jak powyższe, więc wybierz według tabeli kosztów. Szczegóły na MiniMax-M2.7.
Długa historia, bez przycinania
GLM-5.3-Flash ma największe okno z trzech, 390K, a DeepSeek-V4-Flash tuż za nim z 380K. Oba zostawiają miejsce na sesje z dużymi wklejeniami narzędzi lub logów. Szczegóły na GLM.
Kroki, które piszą długie pliki lub raporty
DeepSeek-V4-Flash: do 32 768 tokenów w jednej odpowiedzi w porównaniu do 8192 w pozostałych dwóch, plus okno 380K. Szczegóły na DeepSeek.
Nocny batch, nikt nie patrzy
Ceny wszystkich trzech są takie same o każdej porze, bez cen w godzinach szczytu, więc nocne uruchomienie kosztuje tyle, ile mówi tabela. Dobierz okno i limit odpowiedzi z powyższych sekcji i ustaw limit kroków w pętli.
Wszystkie trzy modele korzystają z jednego salda CheapTokens pod tym samym adresem zgodnym z OpenAI, więc po próbnym uruchomieniu przełączenie to zmiana identyfikatora modelu. Aktualne ceny są na stronie cen; porównanie mocnych stron jest w GLM vs DeepSeek vs MiniMax.


