モデルと比較比較
エージェントセッションのコスト:GLM、DeepSeek、MiniMaxでの50ステップ
履歴が毎ステップ再送される場合の50ステップのエージェントセッションのコストを計算し、GLM-5.3-Flash、DeepSeek-V4-Flash、MiniMax-M2.7の中から選びます。
このページの内容
エージェントが10分間動いただけで、タスクそのものより請求額が大きくなることがあります。不思議なことは起きていません。各ステップで履歴全体が再送されるため、入力側がステップごとに増え、最終的にコストの大部分を占めます。以下の数値では、50ステップのセッションで885,000入力トークンを送信し、40,000を書き込みます。履歴がどこまで増えるか、1回の回答がどれだけ長くなる必要があるかでモデルを選び、表で合計を確認してください。
ステップ50がステップ1より高くつく理由#
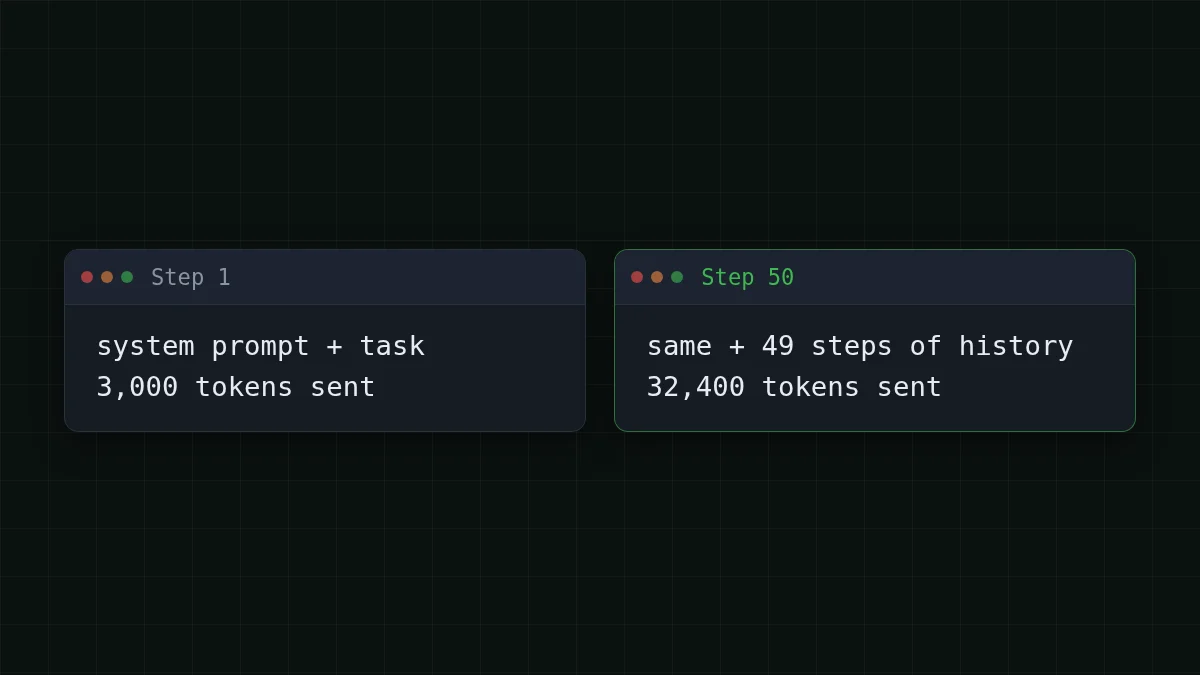
モデルは呼び出し間で何も記憶しません。タスクを続けるには、エージェントがすべてを再送します。指示、以前のすべてのステップ、そして最後のステップが生成した内容です。ステップ1は開始コンテキストを送ります。ステップ50は開始コンテキストに加えて49ステップ分の履歴を送ります。この考え方が初めてなら、なぜAIエージェントはそんなに多くのトークンを使うのかで20ステップの例を解説しています。
エージェントが3,000トークン(システムプロンプト、タスク、いくつかのファイル)で始まり、各ステップで履歴に約600トークンが追加されるとします。エージェントは行ったことと見たことの簡潔なメモを保持し、残りは捨てます。するとステップ50は3,000 + 600 × 49 = 32,400トークンを送ります。回答は1ステップあたり約800トークンのままです。質問は増え続けますが、回答は増えません。
50ステップの合計#
計算の前に、当ててみてください。
数字を当てる
50ステップのセッション全体で何入力トークンを送信するでしょうか?
あなたの予想
02,000,000
答えを表示
答え: 885,000
約885,000です。ステップkは3,000 + 600 × (k − 1)トークンを送り、50ステップで合計885,000になります。これはエージェントが書き込む40,000トークンの20倍以上です。
紙で計算する順序での合計は次のとおりです。
- 開始コンテキストは50回送信されます:50 × 3,000 = 150,000。
- ステップ番号0から49の合計は49 × 50 ÷ 2 = 1,225で、各単位は600トークンの履歴です:600 × 1,225 = 735,000。
- 入力合計:150,000 + 735,000 = 885,000。
- 出力合計:50 × 800 = 40,000。
履歴は885,000のうち735,000を占め、ステップ数より速く増えます。タスクを2倍の100ステップにすると、99 × 100 ÷ 2 = 4,950なので、履歴は600 × 4,950 = 2,970,000、開始コンテキストは100 × 3,000 = 300,000となり、入力トークンは合計3,270,000になります。ステップ数は2倍ですが、入力はほぼ4倍です。出力は2倍になるだけです:100 × 800 = 80,000。
各モデルでのセッションコスト#
リクエストは入力と出力を合わせて課金されるので、合計で比較します。そのように数えると、この負荷では3モデルすべてが合計でOpenRouterより安くなります。表のOpenRouter列にそれが示されています。価格はリアルタイムなので、表は最新の状態に保たれます。
| モデル | 入力 $/1M | 出力 $/1M | コスト | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
合計 885,000 入力トークンと 40,000 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力側から読み取ってください。このセッションでは100トークンあたり約96が入力なので、入力価格が合計の大部分を決めます。現在の1Mトークンあたりの入力:DeepSeek-V4-Flash $0.015、GLM-5.3-Flash $0.02、MiniMax-M2.7 $0.05。
そしてDeepSeek-V4-Flashでの倍増は次のとおりです。
次に自分の負荷を考えてください。例の平均ステップは885,000 ÷ 50 = 17,700入力トークンを送信し、800を書き込みます。そのようなタスクを1日に5つ行うと、5 × 50 = 250ステップです。数値を自分のものに変えてください。計算機はライブ価格でステップごとに合計します。
コスト計算機
1日に5つの50ステップタスク
リクエストあたりの入力トークン数: 17,700 · リクエストあたりの出力トークン数: 800 · 1日あたりのリクエスト数: 250
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
履歴はウィンドウに収まるか?#
コストは1つの制限です。もう1つはウィンドウです。モデルのコンテキストより大きいリクエストはそもそも送信できません。CheapTokensのモデルカタログ(2026年11月4日)には次の制限が記載されています。
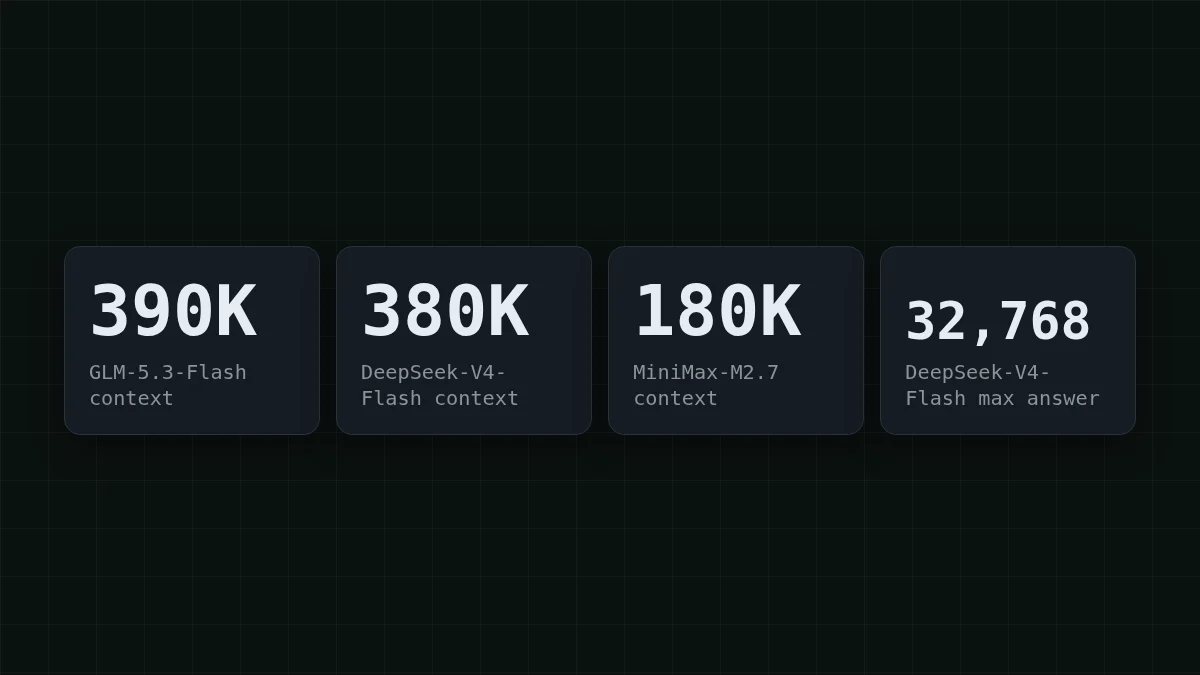
1ステップあたり600トークンの増加では、履歴だけでも多くのステップの後にウィンドウに近づきます。MiniMax-M2.7は約ステップ290(3,000 + 600 × 289 = 176,400)、DeepSeek-V4-Flashは約ステップ620(3,000 + 600 × 619 = 374,400)、GLM-5.3-Flashは約ステップ640(3,000 + 600 × 639 = 386,400)です。50ステップのセッションはどれでもごく一部しか使いません。
実際のセッションはもっと荒いものです。あるステップが大きなログを貼り付けて600ではなく6,000トークンを追加すると、MiniMax-M2.7の180Kは約ステップ30で終わります:3,000 + 6,000 × 29 = 177,000。同じタスクはより大きなウィンドウならはるかに長く収まります。
回答制限は逆に働きます。GLM-5.3-FlashとMiniMax-M2.7は1回答あたり最大8,192トークン、DeepSeek-V4-Flashは最大32,768トークンを書き込みます。あるステップが10,000トークンのレポートを生成する必要があるとします。8,192の制限では応答が上限で止まり、finish_reasonはlengthと言います。DeepSeek-V4-Flashでは1回答に収まります。
サポートボットでも同じ合計#
サポートボットは人を介在させた同じループです。会話が30ターン続き、システムプロンプトとルールが1,000トークン、各ターンが履歴に300トークン(顧客から100、ボットから200)を追加するとします。
- 開始コンテキスト、30回:30 × 1,000 = 30,000。
- 履歴:29 × 30 ÷ 2 = 435単位の300トークンなので、300 × 435 = 130,500。
- 入力合計:30,000 + 130,500 = 160,500。
- 出力合計:30 × 200 = 6,000。
そのような会話1回のコストは、GLM-5.3-Flashで$0.0035、DeepSeek-V4-Flashで$0.003、MiniMax-M2.7で$0.0089です。形は同じで、100トークンあたり約96が入力です。1日に数千の会話を扱うボットは最初の週でこれを実感し、履歴の削減がてこになります。スライディングウィンドウか要約でその方法を示します。
自分のセッションを測定する#
上記の仮定は丸めた数値です。あなたのエージェントには独自の数値があり、APIはそれを正確に教えてくれます。すべての応答には、その呼び出しの入力トークンと出力トークンを含むusageオブジェクトが付きます。このループはツールなしのエージェントと同じ形です。履歴が増え、リスト全体が再送されます。これは例です。プロンプトを自分のタスクに置き換えてください。
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')印刷される各行の中央の数値はその呼び出しの入力で、ステップごとに増えていきます。その増加が履歴です。最後の行の2つの合計を、885000と40000の代わりに上のコスト計算機に入れれば、セッションの価格がわかります。ベースURL、キー、モデルIDはCheapTokensのドキュメントで説明されています。
セッションにどのモデルを選ぶか#
セッションあたりの価格は表にあります。表で示せないのはセッションが収まるかどうかなので、自分のケースで選んでください。
ケースを選ぶ
あなたのエージェントはどんな形ですか?
オプションを選択して答えを表示
短い回答、履歴が180K未満に収まる
3つのどれでも合います。MiniMax-M2.7の180Kウィンドウは上記のような数百ステップを保持できるので、コスト表で選んでください。詳細はMiniMax-M2.7。
長い履歴、削減なし
GLM-5.3-Flashが3つの中で最大の390Kウィンドウを持ち、DeepSeek-V4-Flashが380Kで僅差です。どちらも大きなツールやログの貼り付けがあるセッションの余地を残します。詳細はGLM。
長いファイルやレポートを書くステップ
DeepSeek-V4-Flash:1回答あたり最大32,768トークン(他の2つは8,192)に加えて380Kウィンドウ。詳細はDeepSeek。
夜間バッチ、誰も見ていない
3つすべての価格はどの時間帯でも同じで、ピーク時間料金はないので、夜間の実行は表のとおりのコストです。ウィンドウと回答制限を上記のセクションから見積もり、ループにステップ制限を入れてください。
3モデルすべてが同じOpenAI互換アドレスの背後にある1つのCheapTokens残高に乗っているので、試運転の後はモデルIDを変えるだけです。現在の価格は料金ページにあり、強みの比較はGLM vs DeepSeek vs MiniMaxにあります。


