Modèles & comparaisonsComparaison
Coût d'une session d'agent : 50 étapes sur GLM, DeepSeek ou MiniMax
Calculez ce que coûte une session d'agent de 50 étapes quand l'historique est renvoyé à chaque étape, puis choisissez entre GLM-5.3-Flash, DeepSeek-V4-Flash et MiniMax-M2.7.
Sur cette page
Votre agent a tourné pendant dix minutes, et la facture dépasse la tâche. Rien d'anormal : chaque étape renvoie tout l'historique, donc le côté entrée croît à chaque étape et finit par représenter l'essentiel du coût. Avec les chiffres ci-dessous, une session de 50 étapes envoie 885 000 tokens d'entrée et en écrit 40 000. Choisissez le modèle selon la croissance de l'historique et la longueur nécessaire d'une réponse, puis vérifiez le total dans le tableau.
Pourquoi l'étape 50 coûte plus que l'étape 1#
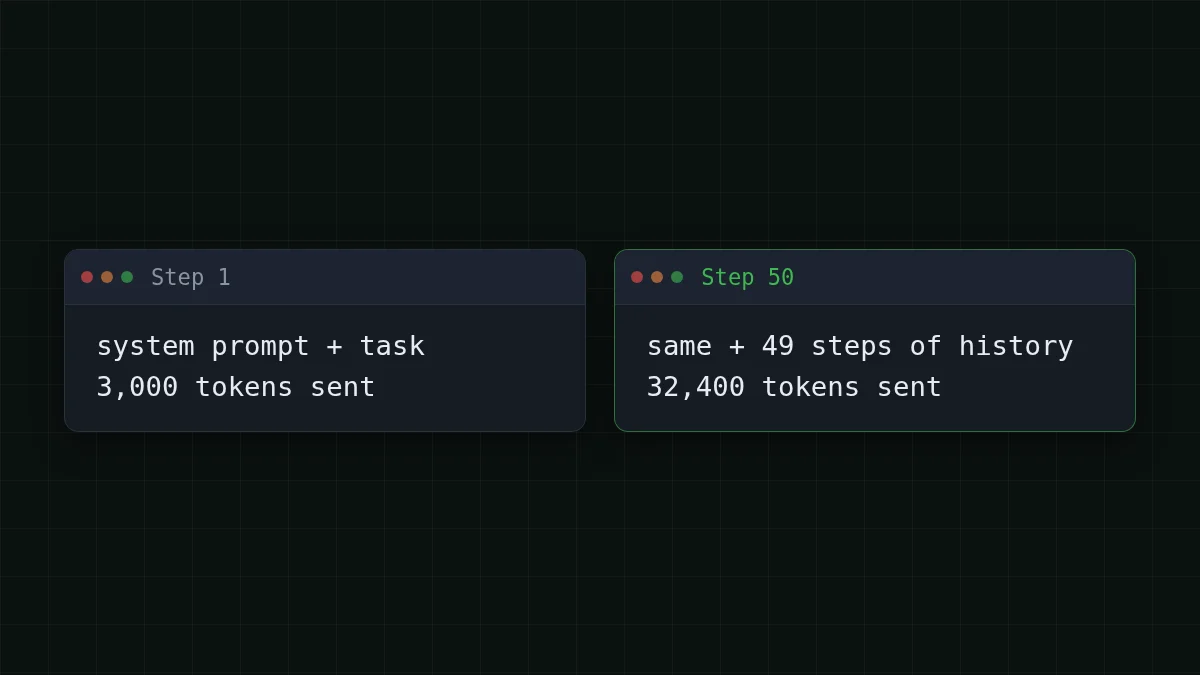
Un modèle ne se souvient de rien entre deux appels. Pour poursuivre une tâche, l'agent renvoie tout : les instructions, chaque étape précédente et ce que la dernière étape a produit. L'étape 1 envoie le contexte de départ. L'étape 50 envoie le contexte de départ plus 49 étapes d'historique. Si le concept est nouveau pour vous, pourquoi les agents IA utilisent autant de tokens déroule un exemple en 20 étapes.
Disons que l'agent démarre avec 3 000 tokens (prompt système, tâche, quelques fichiers) et que chaque étape ajoute environ 600 tokens à l'historique : l'agent conserve une note condensée de ce qu'il a fait et vu, et abandonne le reste. L'étape 50 envoie alors 3 000 + 600 × 49 = 32 400 tokens. La réponse reste autour de 800 tokens par étape. La question ne cesse de croître ; la réponse, non.
La somme sur 50 étapes#
Avant l'arithmétique, faites une estimation.
Devinez le nombre
Combien de tokens d'entrée la session complète de 50 étapes envoie-t-elle ?
Votre estimation
02 000 000
Afficher la réponse
Réponse: 885 000
Environ 885 000. L'étape k envoie 3 000 + 600 × (k − 1) tokens, et sur 50 étapes cela totalise 885 000 — plus de vingt fois les 40 000 tokens que l'agent écrit.
La somme, dans l'ordre où vous la feriez sur papier :
- Le contexte de départ part 50 fois : 50 × 3 000 = 150 000.
- Les numéros d'étape de 0 à 49 totalisent 49 × 50 ÷ 2 = 1 225, et chaque unité vaut 600 tokens d'historique : 600 × 1 225 = 735 000.
- Entrée au total : 150 000 + 735 000 = 885 000.
- Sortie au total : 50 × 800 = 40 000.
L'historique représente 735 000 des 885 000, et il croît plus vite que le nombre d'étapes. Doublez la tâche à 100 étapes : 99 × 100 ÷ 2 = 4 950, donc l'historique est de 600 × 4 950 = 2 970 000 et le contexte de départ de 100 × 3 000 = 300 000, soit 3 270 000 tokens d'entrée au total. Deux fois plus d'étapes, presque quatre fois plus d'entrée. La sortie ne fait que doubler : 100 × 800 = 80 000.
Ce que coûte la session sur chaque modèle#
Une requête est facturée entrée et sortie ensemble, donc comparez le total. Calculé ainsi, les trois modèles reviennent moins cher qu'OpenRouter au total pour cette charge ; la colonne OpenRouter du tableau le montre. Les prix sont en direct, donc le tableau reste à jour.
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
885 000 tokens d'entrée et 40 000 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Lisez-le du côté entrée. Environ 96 tokens sur 100 de cette session sont de l'entrée, donc le prix d'entrée décide de l'essentiel du total. Entrée par 1M tokens aujourd'hui : DeepSeek-V4-Flash $0.015, GLM-5.3-Flash $0.02, MiniMax-M2.7 $0.05.
Et le doublement, sur DeepSeek-V4-Flash :
Maintenant votre propre charge. L'étape moyenne de notre exemple envoie 885 000 ÷ 50 = 17 700 tokens d'entrée et en écrit 800. Cinq telles tâches par jour font 5 × 50 = 250 étapes. Remplacez les chiffres par les vôtres ; le calculateur additionne sur les étapes avec les prix en direct.
Calculateur de coût
Cinq tâches de 50 étapes en une journée
Tokens d'entrée par requête: 17 700 · Tokens de sortie par requête: 800 · Requêtes par jour: 250
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
L'historique tient-il dans la fenêtre ?#
Le coût est une limite. L'autre est la fenêtre : une requête plus grande que le contexte du modèle ne peut pas être envoyée du tout. Le catalogue de modèles CheapTokens (4 novembre 2026) liste ces limites :
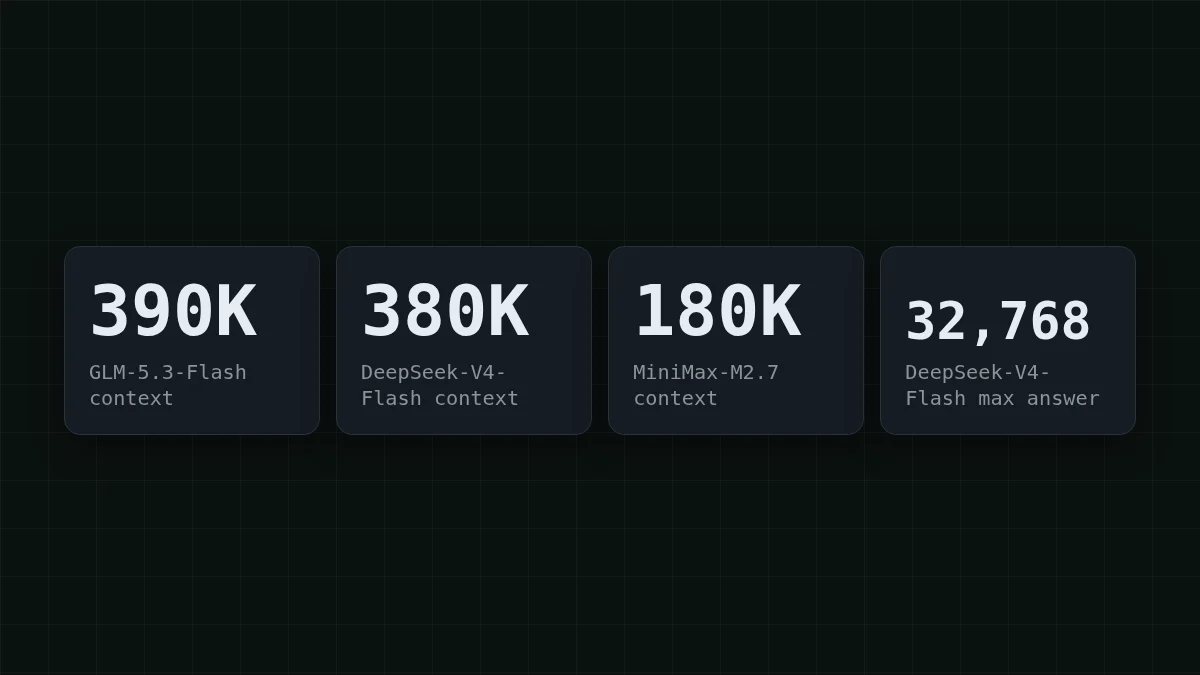
Avec notre croissance de 600 tokens par étape, l'historique seul approche la fenêtre après de nombreuses étapes : MiniMax-M2.7 vers l'étape 290 (3 000 + 600 × 289 = 176 400), DeepSeek-V4-Flash vers l'étape 620 (3 000 + 600 × 619 = 374 400), GLM-5.3-Flash vers l'étape 640 (3 000 + 600 × 639 = 386 400). Une session de 50 étapes n'utilise qu'une petite partie de l'une ou l'autre.
Les vraies sessions sont plus irrégulières. Si une étape colle un gros journal et ajoute 6 000 tokens au lieu de 600, les 180K de MiniMax-M2.7 s'épuisent vers l'étape 30 : 3 000 + 6 000 × 29 = 177 000. La même tâche tient dans les fenêtres plus grandes bien plus longtemps.
La limite de réponse joue dans l'autre sens. GLM-5.3-Flash et MiniMax-M2.7 écrivent jusqu'à 8 192 tokens par réponse, DeepSeek-V4-Flash jusqu'à 32 768. Disons qu'une étape doit produire un rapport de 10 000 tokens. Avec la limite de 8 192, la réponse s'arrête au plafond et finish_reason indique length ; sur DeepSeek-V4-Flash, elle tient en une seule réponse.
La même somme pour un bot de support#
Un bot de support est la même boucle avec une personne dedans. Disons qu'une conversation dure 30 tours, que le prompt système et les règles prennent 1 000 tokens, et que chaque tour ajoute 300 tokens à l'historique (100 du client, 200 du bot).
- Contexte de départ, 30 fois : 30 × 1 000 = 30 000.
- Historique : 29 × 30 ÷ 2 = 435 unités de 300 tokens, donc 300 × 435 = 130 500.
- Entrée au total : 30 000 + 130 500 = 160 500.
- Sortie au total : 30 × 200 = 6 000.
Une telle conversation coûte $0.0035 sur GLM-5.3-Flash, $0.003 sur DeepSeek-V4-Flash et $0.0089 sur MiniMax-M2.7. La forme est la même : environ 96 tokens sur 100 sont de l'entrée. Un bot avec des milliers de conversations par jour le ressent dès la première semaine, et réduire l'historique est le levier. Fenêtre glissante ou résumé montre comment faire.
Mesurez votre propre session#
Les hypothèses ci-dessus sont des chiffres ronds. Votre agent a les siennes, et l'API vous le dit exactement : chaque réponse porte un objet usage avec les tokens d'entrée et de sortie de cet appel. Cette boucle a la même forme qu'un agent sans les outils : l'historique croît, toute la liste est renvoyée. C'est un exemple ; remplacez le prompt par votre tâche.
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
Le chiffre du milieu sur chaque ligne affichée est l'entrée de cet appel, et il grimpe à chaque étape. Cette montée, c'est l'historique. Mettez les deux totaux de la dernière ligne dans le calculateur de coût ci-dessus à la place de 885000 et 40000, et vous avez le prix de votre session. L'URL de base, les clés et les identifiants de modèle sont décrits dans la documentation CheapTokens.
Quel modèle pour votre session#
Le prix par session est dans le tableau. Ce qu'il ne peut pas montrer, c'est si la session tient, alors choisissez selon votre cas :
Choisissez votre cas
À quoi ressemble votre agent ?
Choisissez une option pour voir la réponse
Réponses courtes, historique sous 180K
N'importe lequel des trois convient. La fenêtre de 180K de MiniMax-M2.7 contient des centaines d'étapes comme celles ci-dessus, alors choisissez selon le tableau des coûts. Détails sur MiniMax-M2.7.
Historique long, sans réduction
GLM-5.3-Flash a la plus grande fenêtre des trois, 390K, avec DeepSeek-V4-Flash juste derrière à 380K. Les deux laissent de la place pour des sessions avec de gros collages d'outils ou de journaux. Détails sur GLM.
Étapes qui écrivent de longs fichiers ou rapports
DeepSeek-V4-Flash : jusqu'à 32 768 tokens en une réponse contre 8 192 sur les deux autres, plus une fenêtre de 380K. Détails sur DeepSeek.
Batch nocturne, personne aux commandes
Les prix des trois sont les mêmes à toute heure, sans tarification aux heures de pointe, donc une exécution nocturne coûte ce qu'indique le tableau. Dimensionnez la fenêtre et la limite de réponse d'après les sections ci-dessus et mettez une limite d'étapes dans la boucle.
Les trois modèles reposent sur un seul solde CheapTokens derrière la même adresse compatible OpenAI, donc après un essai, changer revient à changer d'identifiant de modèle. Les prix actuels sont sur la page de tarification ; une comparaison des points forts figure dans GLM vs DeepSeek vs MiniMax.


