AI 入门指南
agent 需要在每一步都调用模型吗?把固定步骤放进代码
为什么每次工具结果都会触发又一次模型调用,哪些 agent 步骤可以是普通代码,以及一个 3 步循环在有和没有额外调用时的成本。
你的 agent 跑了十分钟,账单却比任务本身还大。原因往往很无聊:每次工具返回结果后,harness 都会再调用一次模型,哪怕下一步已经显而易见。
所以,agent 并不需要在每一步都调用模型。它只需要在必须做决定的地方调用模型。像构建通过后运行测试这种永远相同的步骤,可以直接写成代码里的普通规则。
关心这件事有省钱的理由。每次额外调用都会把整个上下文作为输入 token 重新读取(长对话文章解释了原因),所以跳过一次调用省下的不只是它自己那句简短回答。如果你还不熟悉这个循环,先看AI agent 如何工作再回来。
为什么一次工具结果意味着又一次模型调用#
模型本身从不执行任何东西。它写出“请运行 make build”,你的 harness(模型外围的程序)执行它,把输出粘贴进对话,然后带着目前为止的全部内容再次调用模型。这就是整个循环。只有你调用模型时,它才知道工具返回了什么。
想象一位新同事,每做完一步就给经理打电话问“现在呢?”,尽管清单上写着“编译后运行测试”。经理每次都回答同样的内容,而每次通话都要花一分钟从头读整个故事。
下面是 agent 日志里的样子。假设任务是“修复失败的测试”:
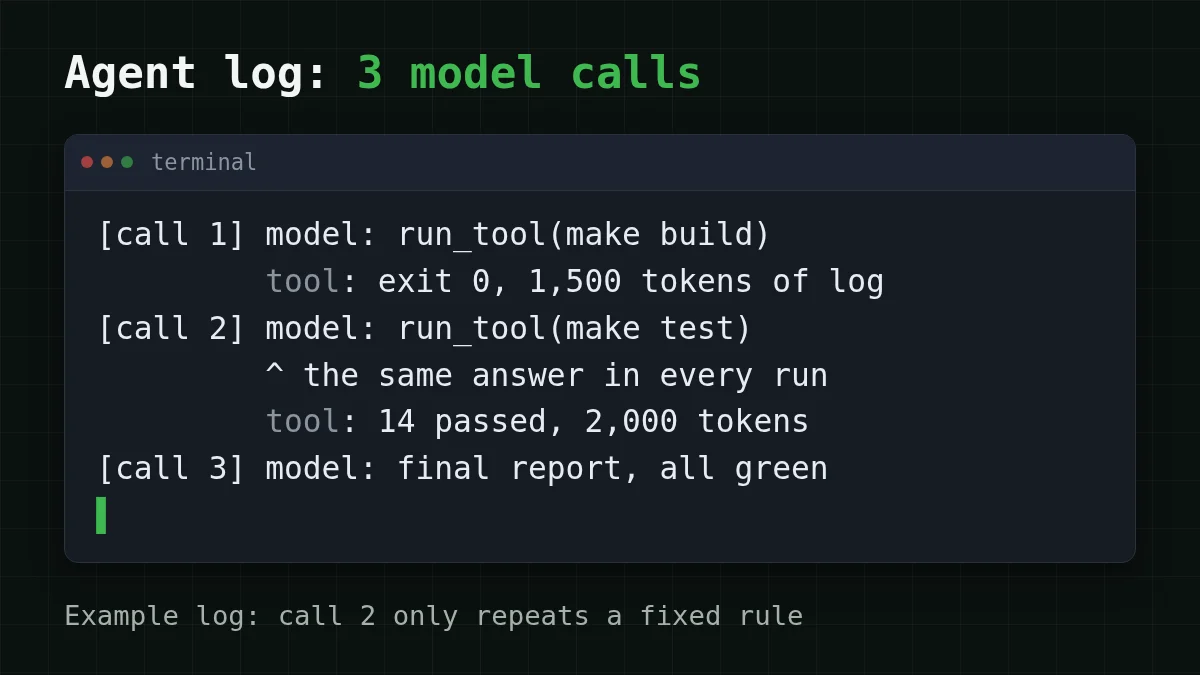
第 2 次调用才是有意思的。构建通过了,下一步永远是测试,而模型却花了一整次上下文读取来说“运行测试”。第 1 次和第 3 次调用不同:第 1 次决定如何开始,第 3 次读取测试结果并写报告。那些才是真正的工作。
哪些步骤需要决策,哪些是固定的#
三个问题能区分大多数步骤:
- 下一步动作是否由明确信号决定,比如退出码、HTTP 状态或“找到 / 未找到”?
- 该信号出现时,是否每次都执行同一个动作?
- 猜错了是否容易撤销?
三个都是“是”:把它写成规则。否则这一步留给模型。
第二个例子,不在编程领域。假设你运行一个客服脚本:客户来信,脚本查询订单,然后回复。按订单号查询订单是代码。用模板填充“您的订单 {id} 状态为 {status}”也是代码。读懂“到货时坏了,现在怎么办?”并在退款、换货和道歉之间做选择是判断,所以那是一次模型调用,不是三次。
配对
每一步应该由谁处理?
点击左侧项目,然后点击其配对项
- 构建以退出码 0 结束,下一步永远是测试代码:下一步是固定的
- 测试失败并带有堆栈跟踪;哪个文件需要修改?模型:新的判断
- 按编号找到订单,现在把它的状态填入回复模板代码:填充模板
- 客户写道“到货时坏了,现在怎么办?”模型:阅读自由文本
一个保护措施让这变得安全:规则只覆盖顺利路径。构建失败退出码为 1?测试红了?工具返回了规则没预料到的东西?把控制权交还给模型,和以前完全一样。你移除的是只有唯一可能答案的调用,而不是把模型从循环中拿掉。
一个 3 步循环,有和没有额外调用#
让我们给“修复失败的测试”日志算上数字。假设条件都是我们自己的,很容易换成你的:
- 系统提示加任务:3,000 tokens
- 构建日志:1,500 tokens;测试日志:2,000 tokens
- 只请求工具的回复:60 tokens;最终报告:300 tokens
猜数字
如果测试运行移入代码,这个循环会进行多少次模型调用?
你的猜测
06
显示答案
答案: 2
两次:一次启动构建,一次读取两个结果并写报告。测试运行不再需要决策。
每一步都调用模型。 第 1 次调用读取 3,000 tokens。第 2 次调用读取 3,000 + 60 + 1,500 = 4,560。第 3 次调用读取 4,560 + 60 + 2,000 = 6,620。输入总计:3,000 + 4,560 + 6,620 = 14,180 tokens;输出:60 + 60 + 300 = 420。
测试运行在代码中。 第 1 次调用读取 3,000 tokens。harness 运行构建,然后按规则运行测试,第 2 次调用读取 3,000 + 60 + 1,500 + 2,000 = 6,560。输入总计:3,000 + 6,560 = 9,560 tokens;输出:60 + 300 = 360。
差值是 14,180 − 9,560 = 4,620 个输入 tokens,约占输入的三分之一,外加一个很小的回答。在 DeepSeek-V4-Flash 上,一个这样的任务第一种方式花费 $0.00025,第二种花费 $0.00018。一个任务是舍入误差。假设你的 agent 每天做 500 个这样的任务(14,180 × 500 = 7,090,000 输入 tokens,420 × 500 = 210,000 输出 tokens,对比 4,780,000 和 180,000):
差距随上下文增长:模型拖着的日志越长,跳过一次重读就越值钱。下面是同一个循环的并排对比:
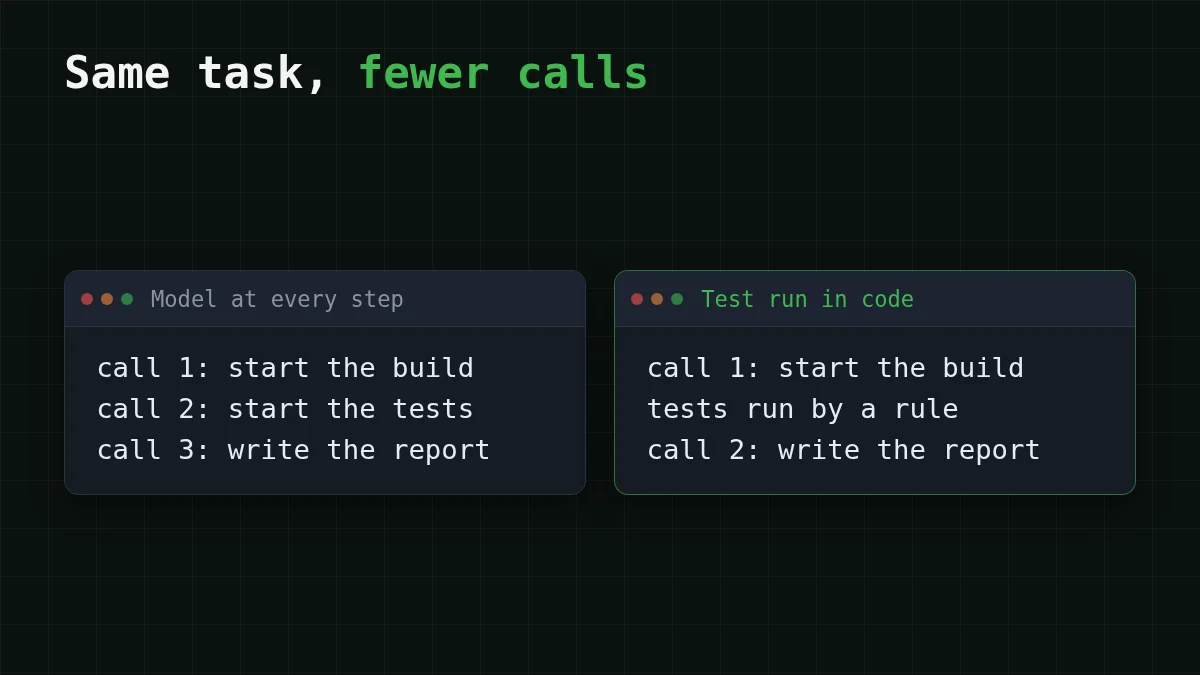
在代码中,规则只有几行。这是伪代码,辅助函数名由你决定:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
HarnessMM 作者报告了什么#
这个想法不只有我们在提。HarnessMM 是 arXiv 上的一篇预印本(arXiv:2610.32813,2026 年 10 月 23 日提交,2026 年 11 月 2 日核对),作者是 Yuhua Jiang、Chang Xu、Feifei Gao 和 Li Zhao。他们的观察是:agent harness 经常在工具反馈后再次调用模型,即使之前的调用已经确定了下一步动作。他们的修复方法叫带保护的决策复用,会重放该决策,并在出现新的语义决策、证据不受支持或选择器弃权时回退到原始模型。上面的 if 是同一想法的的手写版本;他们的保护机制如何决策在论文里。
作者报告了这些 HumanEval 上的结果:
- Codex harness:每个任务 66.72k → 47.02k tokens(−29.54%),成功率保持 90.82% 不变。
- DeepSeek Harness:每个任务 96.28k → 11.62k tokens(−87.93%),成功率 71.43% → 85.71%。
请谨慎解读。这只是一个基准、作者自己的 harness、一篇未经同行评审的预印本,而且 arXiv 页面没有列出代码。你可能会在转述中看到“88%”:那只是 DeepSeek Harness 的数字,Codex 的约为 30%。把两者都当作方向,而不是对你 agent 的承诺。你自己的日志能告诉你更多。
十分钟检查你自己的 agent#
打开每次模型调用的日志,记录每个响应中的 usage 数字(在 Python 中追踪 agent token 成本展示了一种方法)。然后阅读最近二十次运行,标记每次调用:决策还是固定。如果下一步动作在那些运行中从未改变,这次调用就是候选。你的日志显示了什么?
选择你的情况
你的日志显示了什么?
选择一个选项以查看答案
每次运行中都是同一对调用
那里藏着一条固定规则。把它写成基于明确信号(如退出码)的 if,并在信号出现任何意外时保留模型作为回退。
只重新格式化或复制工具输出的调用
把它们移入代码中的模板。如果文本确实需要模型,那是便宜模型的小任务,而不是你最大模型的任务。
下一步随内容变化的调用
把模型留在这里。这正是它的用途,而且更便宜的模型通常能处理简单的分类并选择步骤;参见模型路由:便宜模型优先。
每次调用都重读巨大日志
精简回到对话中的内容:把工具输出挡在上下文之外。同一个任务在不移除任何调用的情况下变得更便宜。
如果你想在长上下文模型上试试,CheapTokens 为 agent 循环提供 DeepSeek-V4-Flash(deepseek-):任何时段同一价格,380K 上下文,每次回答最多 32,768 输出 tokens。对于仍然需要决策的步骤,有 GLM-5.3-Flash(zai-),上下文 390K。两者都通过 https:/ 的 OpenAI 和 Anthropic 兼容 API 工作,所有模型共用一个余额。设置见文档,价格在定价页,模型页是便宜的 DeepSeek。


