AI untuk pemulaPanduan
Apakah agent membutuhkan model di setiap langkah? Taruh langkah tetap di kode
Mengapa setiap hasil tool memicu panggilan model lagi, langkah agent mana yang bisa berupa kode biasa, dan berapa biaya loop 3 langkah dengan dan tanpa panggilan tambahan.
Di halaman ini
Agent Anda berjalan selama sepuluh menit, dan tagihannya lebih besar daripada tugasnya. Sering kali penyebabnya membosankan: setelah setiap hasil tool, harness memanggil model lagi, bahkan ketika langkah berikutnya sudah jelas.
Jadi tidak, agent tidak membutuhkan model di setiap langkah. Ia membutuhkan model di tempat sesuatu harus diputuskan. Langkah yang selalu sama, seperti menjalankan tes setelah build yang lolos, bisa menjadi aturan biasa di kode Anda.
Ada alasan finansial untuk peduli. Setiap panggilan tambahan membaca ulang seluruh konteks sebagai token input (artikel obrolan panjang menjelaskan mengapa), jadi panggilan yang dilewati menghemat lebih dari sekadar jawaban singkatnya sendiri. Jika loop itu sendiri masih baru bagi Anda, mulailah dengan cara kerja AI agent lalu kembali.
Mengapa satu hasil tool berarti satu panggilan model lagi#
Model tidak pernah menjalankan apa pun. Ia menulis "tolong jalankan make build", harness Anda (program di sekitar model) menjalankannya, menempelkan output ke percakapan dan memanggil model lagi dengan semua yang ada sejauh ini. Itulah keseluruhan loop-nya. Model hanya mengetahui apa yang dikembalikan tool ketika Anda memanggilnya.
Bayangkan seorang kolega baru yang menelepon manajer setelah setiap langkah untuk bertanya "lalu sekarang?", padahal daftar periksa mengatakan "setelah kompilasi, jalankan tes". Manajer menjawab hal yang sama setiap kali, dan setiap panggilan memakan waktu satu menit untuk membaca seluruh cerita dari awal.
Berikut tampilannya di log agent. Katakanlah tugasnya adalah "perbaiki tes yang gagal":
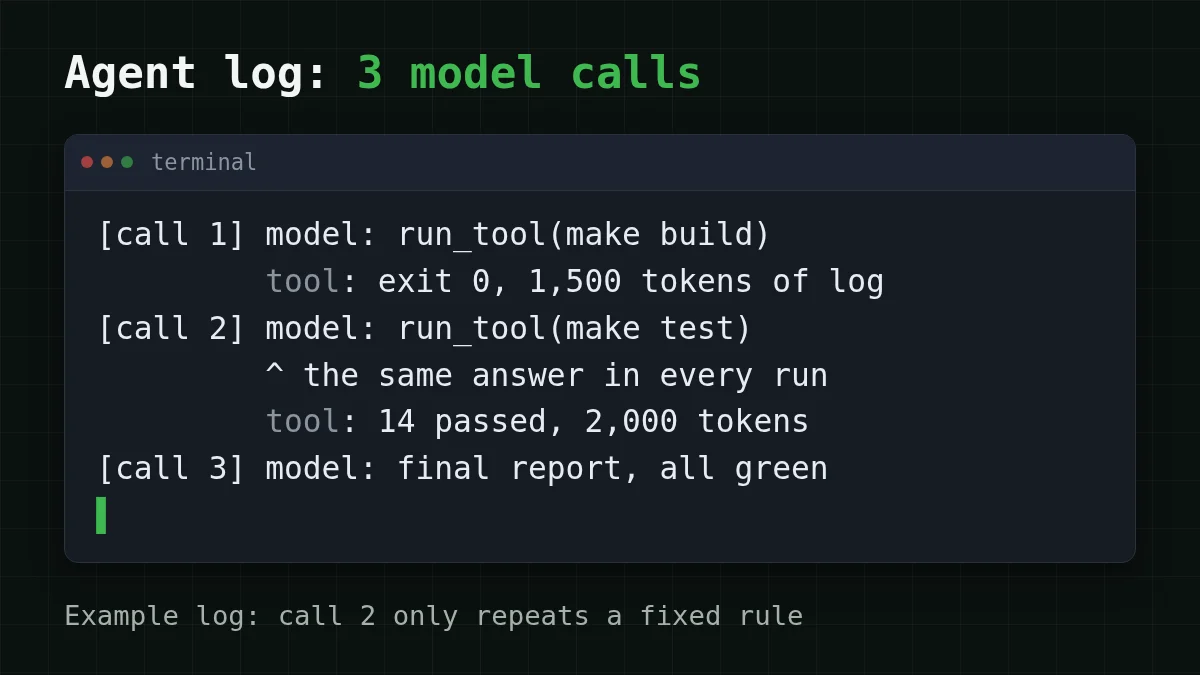
Panggilan 2 adalah yang menarik. Build lolos, langkah berikutnya selalu tes, dan model menghabiskan satu bacaan penuh konteks untuk mengatakan "jalankan tes". Panggilan 1 dan panggilan 3 berbeda: panggilan 1 memilih cara memulai, panggilan 3 membaca hasil tes dan menulis laporan. Itu pekerjaan nyata.
Langkah mana yang butuh keputusan dan mana yang tetap#
Tiga pertanyaan menyortir sebagian besar langkah:
- Apakah aksi berikutnya ditentukan oleh sinyal yang jelas, seperti exit code, status HTTP atau "ditemukan / tidak ditemukan"?
- Apakah aksinya sama setiap kali sinyal itu muncul?
- Apakah tebakan yang salah murah untuk dibatalkan?
Tiga ya: tulis sebagai aturan. Jika tidak, model tetap memegang langkah itu.
Contoh kedua, di luar coding. Katakanlah Anda menjalankan skrip dukungan: pelanggan menulis, skrip mencari pesanan, lalu membalas. Mencari pesanan berdasarkan nomornya adalah kode. Mengisi "Pesanan Anda {id} adalah {status}" dari template juga kode. Membaca "barangnya datang rusak, bagaimana sekarang?" dan memilih antara refund, penggantian dan permintaan maaf adalah penilaian, jadi itu satu panggilan model, bukan tiga.
Cocokkan pasangan
Siapa yang harus menangani setiap langkah?
Ketuk item di kiri, lalu pasangannya
- Build selesai dengan exit code 0, dan langkah berikutnya selalu tesKode: langkah berikutnya tetap
- Tes gagal dengan stack trace; file mana yang perlu diubah?Model: penilaian baru
- Pesanan ditemukan berdasarkan nomor, sekarang masukkan statusnya ke template balasanKode: isi template
- Pelanggan menulis "barangnya datang rusak, bagaimana sekarang?"Model: membaca teks bebas
Satu pengaman membuat ini aman: aturan hanya mencakup jalur bahagia. Build gagal dengan exit code 1? Tes merah? Tool mengembalikan sesuatu yang tidak diharapkan aturan? Kembalikan kendali ke model, persis seperti sebelumnya. Anda menghapus panggilan yang hanya punya satu jawaban yang mungkin, bukan mengeluarkan model dari loop.
Loop 3 langkah, dengan dan tanpa panggilan tambahan#
Mari kita beri angka pada log "perbaiki tes yang gagal". Asumsinya, semuanya milik kami dan mudah diganti dengan milik Anda:
- system prompt plus tugas: 3.000 token
- log build: 1.500 token; log tes: 2.000 token
- balasan yang hanya meminta tool: 60 token; laporan akhir: 300 token
Tebak angkanya
Jika eksekusi tes dipindahkan ke kode, berapa panggilan model yang dilakukan loop?
Tebakan Anda
06
Tampilkan jawaban
Jawaban: 2
Dua: satu untuk memulai build, satu untuk membaca kedua hasil dan menulis laporan. Eksekusi tes tidak lagi membutuhkan keputusan.
Model di setiap langkah. Panggilan 1 membaca 3.000 token. Panggilan 2 membaca 3.000 + 60 + 1.500 = 4.560. Panggilan 3 membaca 4.560 + 60 + 2.000 = 6.620. Total input: 3.000 + 4.560 + 6.620 = 14.180 token; output: 60 + 60 + 300 = 420.
Eksekusi tes di kode. Panggilan 1 membaca 3.000 token. Harness menjalankan build, lalu tes berdasarkan aturan, dan panggilan 2 membaca 3.000 + 60 + 1.500 + 2.000 = 6.560. Total input: 3.000 + 6.560 = 9.560 token; output: 60 + 300 = 360.
Selisihnya adalah 14.180 − 9.560 = 4.620 token input, sekitar sepertiga dari input, ditambah satu jawaban kecil. Pada DeepSeek-V4-Flash satu tugas seperti itu memakan biaya $0.00025 dengan cara pertama dan $0.00018 dengan cara kedua. Satu tugas hanyalah kesalahan pembulatan. Katakanlah agent Anda melakukan 500 tugas sehari (14.180 × 500 = 7.090.000 token input, 420 × 500 = 210.000 token output dibandingkan 4.780.000 dan 180.000):
Selisihnya tumbuh seiring konteks: semakin panjang log yang diseret model, semakin berharga pembacaan ulang yang dilewati. Berikut loop yang sama secara berdampingan:
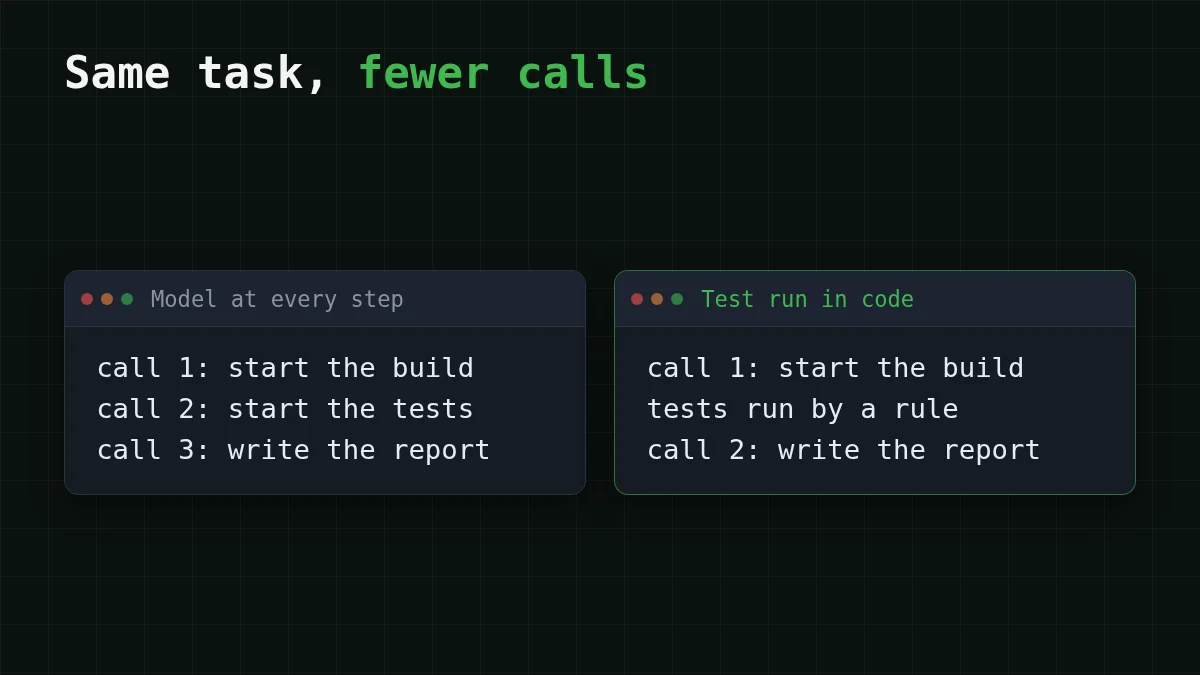
Dalam kode, aturannya hanya beberapa baris. Ini pseudo-code, nama helper-nya milik Anda:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Apa yang dilaporkan penulis HarnessMM#
Idenya bukan hanya milik kami. HarnessMM adalah preprint di arXiv (arXiv:2610.32813, dikirim 23 Oktober 2026, diperiksa 2 November 2026) oleh Yuhua Jiang, Chang Xu, Feifei Gao dan Li Zhao. Pengamatan mereka: harness agent sering memanggil model lagi setelah umpan balik tool bahkan ketika panggilan sebelumnya sudah menentukan aksi berikutnya. Perbaikan mereka, guarded decision reuse, memutar ulang keputusan itu dan kembali ke model asli ketika keputusan semantik baru muncul, bukti tidak didukung atau selector abstain. if di atas adalah versi tulisan tangan dari ide yang sama; bagaimana pengaman mereka memutuskan ada di makalah.
Para penulis melaporkan hasil ini pada HumanEval:
- Harness Codex: 66,72k → 47,02k token per tugas (−29,54%), keberhasilan tidak berubah di 90,82%.
- DeepSeek Harness: 96,28k → 11,62k token per tugas (−87,93%), keberhasilan 71,43% → 85,71%.
Bacalah dengan hati-hati. Ini satu benchmark, harness milik penulis sendiri, preprint yang belum ditinjau sejawat, dan halaman arXiv tidak mencantumkan kode. Anda mungkin melihat "88%" dalam cerita ulang: itu hanya angka DeepSeek Harness, angka Codex sekitar 30%. Perlakukan keduanya sebagai arah, bukan janji untuk agent Anda. Log Anda sendiri memberi tahu lebih banyak.
Periksa agent Anda sendiri dalam sepuluh menit#
Aktifkan log setiap panggilan model, dengan angka usage dari setiap respons (melacak biaya token agent di Python menunjukkan salah satu caranya). Lalu baca dua puluh eksekusi terakhir dan tandai setiap panggilan: keputusan atau tetap. Sebuah panggilan adalah kandidat ketika aksi berikutnya tidak pernah berubah di sepanjang eksekusi tersebut. Apa yang ditunjukkan log Anda?
Pilih kasus Anda
Apa yang ditunjukkan log Anda?
Pilih opsi untuk melihat jawabannya
Pasangan panggilan yang sama di setiap eksekusi
Aturan tetap bersembunyi di sana. Tulis sebagai if pada sinyal yang jelas, seperti exit code, dan pertahankan model sebagai fallback ketika sinyalnya apa pun yang tidak terduga.
Panggilan yang hanya memformat ulang atau menyalin output tool
Pindahkan ke template di kode. Jika teksnya benar-benar membutuhkan model, itu pekerjaan kecil untuk model murah, bukan untuk model terbesar Anda.
Panggilan di mana langkah berikutnya berubah sesuai konten
Pertahankan model di sini. Inilah tujuannya, dan model yang lebih murah sering menangani langkah klasifikasi-dan-pilih yang sederhana; lihat model routing: model murah dulu.
Setiap panggilan membaca ulang log besar
Pangkas apa yang kembali ke percakapan: jauhkan output tool dari konteks. Tugas yang sama menjadi lebih murah tanpa menghapus panggilan apa pun.
Jika Anda ingin mencoba ini pada model dengan konteks panjang, CheapTokens menyediakan DeepSeek-V4-Flash (deepseek-) untuk loop agent: satu harga di jam berapa pun, konteks 380K dan hingga 32.768 token output per jawaban. Untuk langkah yang masih membutuhkan keputusan ada GLM-5.3-Flash (zai-) dengan konteks 390K. Keduanya bekerja melalui API yang kompatibel dengan OpenAI dan Anthropic di https:/, dengan satu saldo untuk semua model. Penyiapan ada di dokumentasi, harga ada di halaman harga, dan halaman modelnya adalah DeepSeek murah.


