Agentes precisam do modelo em cada passo? Coloque passos fixos no código
Por que cada resultado de ferramenta dispara outra chamada ao modelo, quais passos do agente podem ser código puro, e quanto custa um loop de 3 passos com e sem a chamada extra.
Nesta página
Seu agente rodou por dez minutos, e a conta é maior que a tarefa. Muitas vezes o motivo é banal: após cada resultado de ferramenta, o harness chama o modelo de novo, mesmo quando o próximo passo era óbvio.
Então não, um agente não precisa do modelo em cada passo. Ele precisa do modelo onde algo tem que ser decidido. Um passo que é sempre igual, como rodar os testes depois de um build que passou, pode ser uma regra simples no seu código.
Há um motivo financeiro para se importar. Cada chamada extra relê todo o contexto como tokens de entrada (o artigo sobre conversas longas mostra por quê), então uma chamada pulada economiza mais do que sua própria resposta curta. Se o loop em si é novo para você, comece por como funciona um agente de IA e volte depois.
Por que um resultado de ferramenta significa mais uma chamada ao modelo#
O modelo nunca executa nada. Ele escreve "por favor, rode make build", seu harness (o programa em volta do modelo) executa, cola a saída na conversa e chama o modelo de novo com tudo até ali. Esse é o loop inteiro. O modelo só descobre o que uma ferramenta retornou quando você o chama.
Pense num colega novo que liga para o gerente depois de cada passo para perguntar "e agora?", mesmo que o checklist diga "depois de compilar, rode os testes". O gerente responde a mesma coisa toda vez, e cada chamada custa um minuto lendo a história inteira desde o começo.
Veja como isso aparece num log de agente. Digamos que a tarefa seja "corrigir o teste que falha":
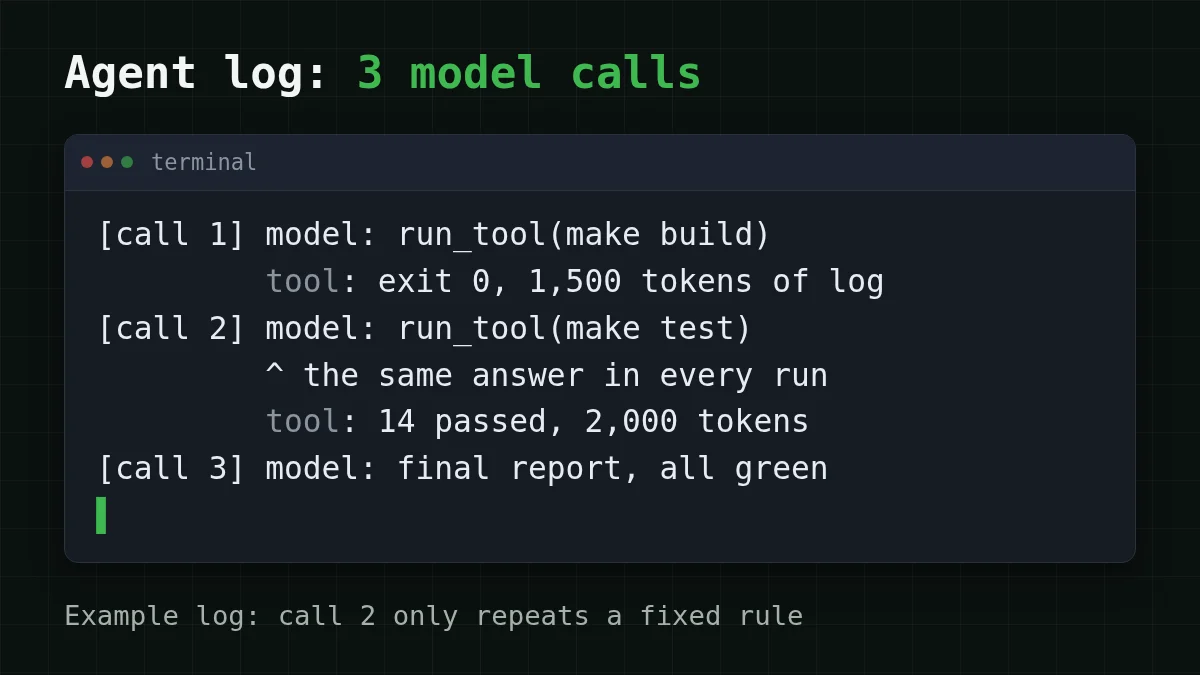
A chamada 2 é a interessante. O build passou, o próximo passo é sempre os testes, e o modelo gasta uma leitura completa do contexto para dizer "rode os testes". A chamada 1 e a chamada 3 são diferentes: a chamada 1 escolhe como começar, a chamada 3 lê os resultados dos testes e escreve o relatório. Essas são trabalho de verdade.
Quais passos exigem uma decisão e quais são fixos#
Três perguntas classificam a maioria dos passos:
- A próxima ação é decidida por um sinal claro, como um código de saída, um status HTTP ou "encontrado / não encontrado"?
- É a mesma ação toda vez que esse sinal aparece?
- Um palpite errado é barato de desfazer?
Três sins: escreva como regra. Caso contrário, o modelo fica com o passo.
Um segundo exemplo, fora da programação. Digamos que você rode um script de suporte: um cliente escreve, o script consulta o pedido e então responde. Consultar o pedido pelo número é código. Preencher "Seu pedido {id} está {status}" a partir de um template também é código. Ler "chegou quebrado, e agora?" e escolher entre reembolso, troca e desculpas é um julgamento, então isso é uma chamada ao modelo, não três.
Emparelhar os pares
Quem deve cuidar de cada passo?
Toque num item à esquerda, depois no seu par
- Build terminou com código de saída 0, e o próximo passo é sempre os testesCódigo: o próximo passo é fixo
- Testes falharam com um stack trace; qual arquivo precisa da mudança?Modelo: um novo julgamento
- Pedido encontrado pelo número, agora coloque o status no template de respostaCódigo: preencher o template
- Cliente escreve "chegou quebrado, e agora?"Modelo: ler texto livre
Uma proteção torna isso seguro: a regra cobre apenas o caminho feliz. Build falhou com código de saída 1? Testes vermelhos? Uma ferramenta retornou algo que a regra não esperava? Devolva o controle ao modelo, exatamente como antes. Você está removendo chamadas que tinham só uma resposta possível, não tirando o modelo do loop.
Um loop de 3 passos, com e sem a chamada extra#
Vamos colocar números no log de "corrigir o teste que falha". As premissas, todas nossas e fáceis de trocar pelas suas:
- prompt de sistema mais tarefa: 3.000 tokens
- log do build: 1.500 tokens; log dos testes: 2.000 tokens
- uma resposta que só pede uma ferramenta: 60 tokens; o relatório final: 300 tokens
Adivinhar o número
Se a execução dos testes passa para o código, quantas chamadas ao modelo o loop faz?
O seu palpite
06
Mostrar resposta
Resposta: 2
Duas: uma para iniciar o build, uma para ler os dois resultados e escrever o relatório. A execução dos testes não precisa mais de uma decisão.
Modelo em cada passo. A chamada 1 lê 3.000 tokens. A chamada 2 lê 3.000 + 60 + 1.500 = 4.560. A chamada 3 lê 4.560 + 60 + 2.000 = 6.620. Entrada no total: 3.000 + 4.560 + 6.620 = 14.180 tokens; saída: 60 + 60 + 300 = 420.
Execução dos testes no código. A chamada 1 lê 3.000 tokens. O harness roda o build, depois os testes por regra, e a chamada 2 lê 3.000 + 60 + 1.500 + 2.000 = 6.560. Entrada no total: 3.000 + 6.560 = 9.560 tokens; saída: 60 + 300 = 360.
A diferença é 14.180 − 9.560 = 4.620 tokens de entrada, cerca de um terço da entrada, mais uma resposta pequena. No DeepSeek-V4-Flash, uma tarefa dessas custa $0.00025 do primeiro jeito e $0.00018 do segundo. Uma tarefa é um erro de arredondamento. Digamos que seu agente faça 500 delas por dia (14.180 × 500 = 7.090.000 tokens de entrada, 420 × 500 = 210.000 tokens de saída contra 4.780.000 e 180.000):
A diferença cresce com o contexto: quanto mais longos os logs que o modelo arrasta, mais vale uma releitura pulada. Aqui está o mesmo loop lado a lado:
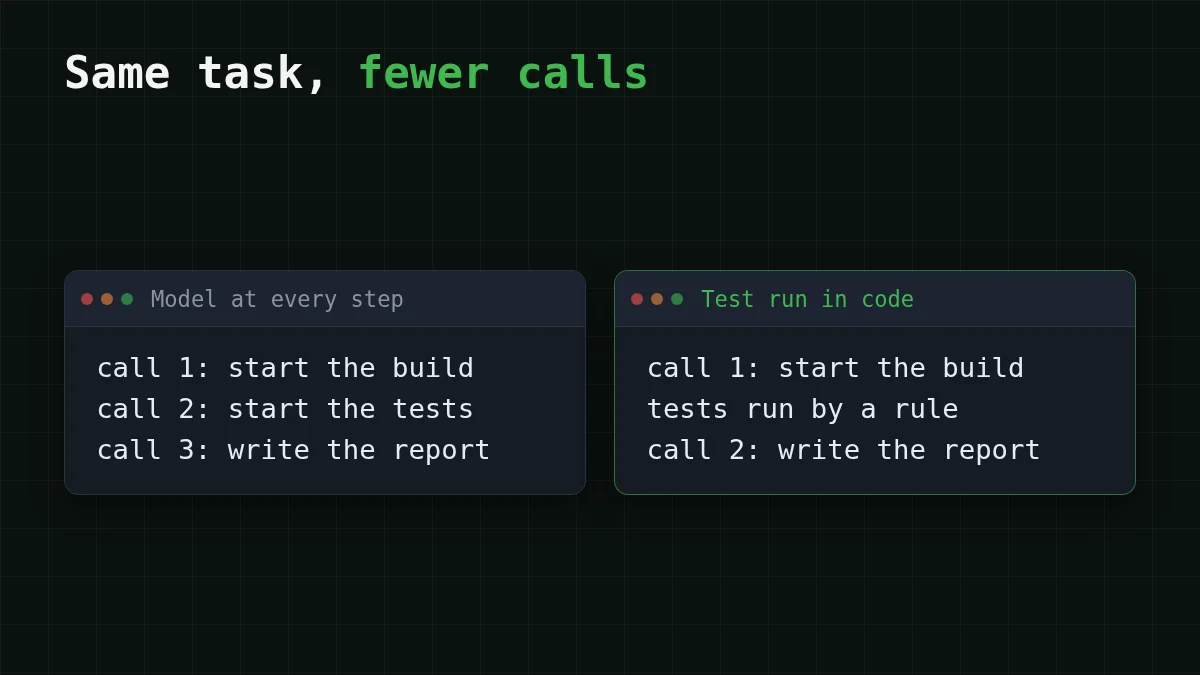
No código, a regra são algumas linhas. Isto é pseudocódigo, os nomes dos helpers são seus:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
O que os autores do HarnessMM relatam#
A ideia não é só nossa. HarnessMM é um preprint no arXiv (arXiv:2610.32813, enviado em 23 de outubro de 2026, verificado em 2 de novembro de 2026) de Yuhua Jiang, Chang Xu, Feifei Gao e Li Zhao. A observação deles: harnesses de agentes muitas vezes chamam o modelo de novo após o feedback da ferramenta, mesmo quando uma chamada anterior já determinou a próxima ação. A correção deles, reuso de decisão com proteção, reproduz essa decisão e recorre ao modelo original quando surge uma nova decisão semântica, a evidência não é suportada ou o seletor se abstém. O if acima é a versão escrita à mão da mesma ideia; como a proteção deles decide está no paper.
Os autores relatam estes resultados no HumanEval:
- Harness do Codex: 66,72k → 47,02k tokens por tarefa (−29,54%), sucesso inalterado em 90,82%.
- DeepSeek Harness: 96,28k → 11,62k tokens por tarefa (−87,93%), sucesso 71,43% → 85,71%.
Leia com cuidado. É um único benchmark, o harness dos próprios autores, um preprint que não passou por revisão por pares, e a página do arXiv não lista código. Você pode ver "88%" em recontagens: esse é só o número do DeepSeek Harness, o do Codex é cerca de 30%. Trate ambos como uma direção, não como uma promessa para o seu agente. Seu próprio log diz mais.
Verifique seu próprio agente em dez minutos#
Ative um log de cada chamada ao modelo, com os números de usage de cada resposta (rastrear o custo de tokens de agentes em Python mostra um jeito). Depois leia as últimas vinte execuções e marque cada chamada: decisão ou fixa. Uma chamada é candidata quando a próxima ação nunca mudou ao longo dessas execuções. O que seu log mostra?
Escolha o seu caso
O que seu log mostra?
Escolha uma opção para ver a resposta
O mesmo par de chamadas em toda execução
Uma regra fixa está escondida ali. Escreva-a como um if sobre um sinal claro, como o código de saída, e mantenha o modelo como fallback quando o sinal for qualquer coisa inesperada.
Chamadas que só reformatam ou copiam a saída de ferramentas
Mova-as para um template no código. Se o texto realmente precisa de um modelo, é um trabalho pequeno para um modelo barato, não para o seu maior.
Chamadas em que o próximo passo muda com o conteúdo
Mantenha o modelo aqui. É para isso que ele serve, e um modelo mais barato muitas vezes dá conta de um passo simples de classificar e escolher; veja roteamento de modelos: modelo barato primeiro.
Toda chamada relê um log enorme
Corte o que volta para a conversa: mantenha a saída de ferramentas fora do contexto. A mesma tarefa fica mais barata sem remover nenhuma chamada.
Se você quiser testar isso num modelo com contexto longo, a CheapTokens serve o DeepSeek-V4-Flash (deepseek-) para loops de agentes: um preço a qualquer hora, contexto de 380K e até 32.768 tokens de saída por resposta. Para os passos que ainda precisam de uma decisão, há o GLM-5.3-Flash (zai-) com contexto de 390K. Ambos funcionam pela API compatível com OpenAI e Anthropic em https:/, com um saldo para todos os modelos. A configuração está na documentação, os preços estão na página de preços, e a página do modelo é DeepSeek barato.


