Por que um agente de IA relê todo o seu histórico a cada passo
Uma correção na linha de status do Claude Code mostra por que sessões longas de agente ficam caras: cada chamada reenvia a conversa. Estime o custo e corte.
Nesta página
Seu agente rodou por dez minutos, e a conta é maior do que a tarefa aparenta. Quase sempre o motivo é o mesmo: o modelo não lembra de nada entre chamadas, então cada passo reenvia toda a conversa até ali como entrada. Uma sessão de 50 passos paga pelas primeiras mensagens 50 vezes, e é por isso que o custo cresce mais rápido que o trabalho feito.
Uma correção que a Anthropic anunciou para o Claude Code em 4–5 de novembro de 2026 mostra isso em um ponto pequeno. Abaixo: o que mudou, a aritmética de um loop de 50 passos e o que você pode fazer a respeito.
Uma linha de status que relia tudo#
O Claude Code pode iniciar subagentes em segundo plano: agentes auxiliares que trabalham em uma tarefa paralela enquanto você continua. Cada um mostra um status de uma linha, algo como 'rodando testes, 3 de 8 concluídos'.
A conta ClaudeDevs no X anunciou a mudança (o post é datado de 5 de novembro de 2026; relatos secundários dizem 4 ou 5 de novembro). O status costumava ser atualizado a cada 30 segundos, e cada atualização relia toda a conversa do subagente. Agora o Haiku 5.5 escreve o status a partir de notas curtas, e a Anthropic estima isso em cerca de 99% mais barato por atualização. É um número por atualização, não por sessão: o trabalho real do subagente ainda lê seu histórico.
Imagine o que o jeito antigo significava. Digamos que um subagente tenha 60.000 tokens de conversa aos vinte minutos. O status em si tem talvez 30 tokens. Mas para escrever esses 30 tokens o modelo tinha que reler todos os 60.000, duas vezes por minuto, enquanto o subagente rodasse.
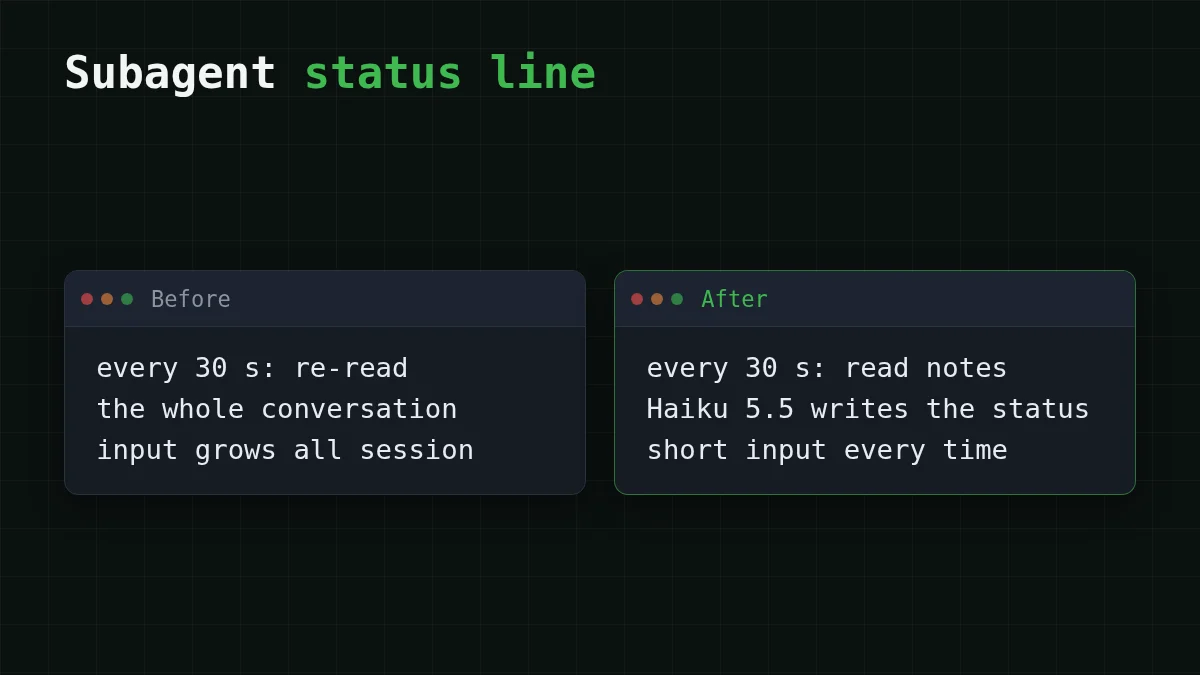
Ninguém precisa da transcrição completa para dizer 'rodando testes'. Algumas linhas de notas (o que estou fazendo, o que está pronto) bastam. Essa é a correção inteira: dê a uma tarefa paralela as notas, não a transcrição.
Por que cada passo reenvia o histórico#
Pense em uma carta para alguém que esquece você no momento em que responde. Para continuar, você envia toda a correspondência de novo mais a nova linha. Um passo de agente é exatamente essa chamada: o prompt de sistema, sua tarefa, toda resposta anterior e todo resultado de ferramenta entram de novo. (A versão de chat desta história está em por que um chat de IA longo custa mais.)
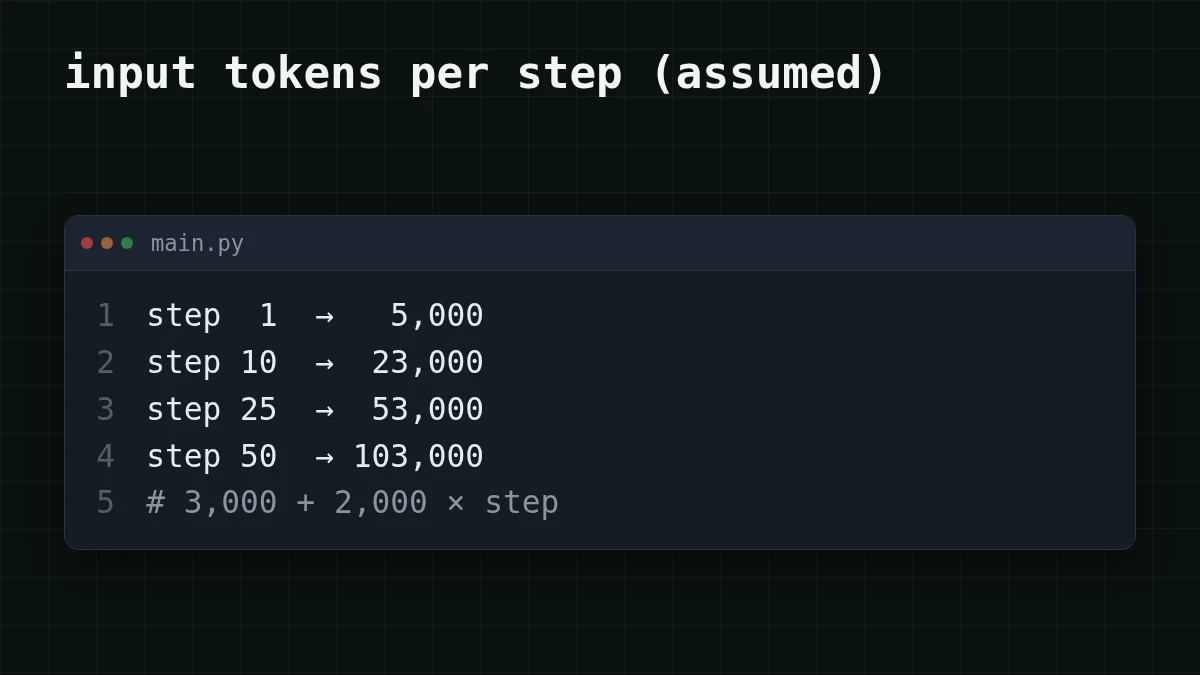
Vamos colocar números nisso. Digamos que o prompt de sistema e a tarefa ocupem 3.000 tokens, e cada passo acrescente cerca de 2.000 (a resposta do modelo mais a saída de ferramenta que ele lê). O passo n então envia 3.000 + 2.000 × n tokens: 5.000 no passo 1, 23.000 no passo 10, 103.000 no passo 50.
Adivinhar o número
Quantos tokens de entrada o passo 50 deste agente envia?
O seu palpite
0200.000
Mostrar resposta
Resposta: 103.000
3.000 + 2.000 × 50 = 103.000. O modelo relê o prompt inicial e todos os 49 passos anteriores, e então seu novo passo por cima.
Agora some todos os 50 passos. A parte que cresce é 2,000 × 1,275 = 2,550,000, onde 1.275 é 1 + 2 + … + 50. O prompt inicial, enviado toda vez, é 50 × 3,000 = 150,000. Juntos: 150,000 + 2,550,000 = 2,700,000 tokens de entrada. A conversa final tem apenas 103.000. Você empurrou 2,7 milhões de tokens pelo modelo para obter uma transcrição de 103.000 tokens, e a conta segue o primeiro número.
Quanto custa: uma tarefa, um dia#
Precifique o mesmo agente de 50 passos no DeepSeek-V4-Flash. O passo médio envia 54.000 tokens, então 54,000 × 50 = 2,700,000 tokens de entrada no total, e ele escreve cerca de 400 por passo (400 × 50 = 20,000). A tarefa inteira custa $0.0425. Aqui está a mesma carga de trabalho em todos os modelos que temos, ao lado do OpenRouter:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 50 solicitações | OpenRouter, 50 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 tokens de entrada e 400 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Na tabela, todo modelo é mais barato que o OpenRouter no total, com entrada e saída contadas juntas.
Agora a linha de status. 120 atualizações é uma hora de um subagente, e cada uma escreve cerca de 30 tokens (30 × 120 = 3,600 de saída). O jeito antigo: 60,000 × 120 = 7,200,000 tokens de entrada, mais de duas vezes e meia as tarefas de 50 passos acima, gastos em nada além de um texto de status. Com uma nota de 500 tokens são 500 × 120 = 60,000. No GLM-5.3-Flash isso é $0.144 contra $0.0013.
Teste seu próprio agente: tokens por passo, passos e tarefas por dia.
Calculadora de custos
Um dia de dez tarefas assim
Tokens de entrada por solicitação: 54.000 · Tokens de saída por solicitação: 400 · Solicitações por dia: 500
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
URL base, chave e uma primeira requisição estão na documentação do CheapTokens; os preços atuais de cada modelo estão na página de preços.
Quatro formas de cortar#
Nenhuma delas precisa de uma ferramenta especial. É um hábito de perguntar: esta chamada realmente precisa do histórico?
O padrão de notas#
Mantenha algumas linhas de notas enquanto o agente trabalha, e entregue só elas a um modelo pequeno quando precisar de um status ou resumo. Aqui está no GLM-5.3-Flash (zai-, contexto de 390K, até 8.192 tokens de saída por resposta):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Você recebe de volta uma linha curta, e o par de uso mostra entrada em dezenas de tokens, não dezenas de milhares. É a mesma ideia da mudança do Claude Code, em uma dúzia de linhas.
Qual hábito se encaixa no seu caso?
Escolha o seu caso
Qual é a sua situação?
Escolha uma opção para ver a resposta
Uma sessão, o assunto mudou
Comece uma sessão nova. Cole cinco linhas de notas (objetivo, o que está feito, o que vem a seguir) em vez da transcrição antiga. As opções de corte estão em cortar histórico de chat: janela deslizante ou resumo.
Uma tarefa paralela: status, resumo, título
Entregue as notas, não o histórico, e envie a um modelo pequeno, como no código acima.
Saída de ferramenta enorme: logs, dumps de teste
Mantenha fora do histórico. Mostre as últimas 20 linhas ou o único teste que falhou, não o dump inteiro: cada linha que você mantém é reenviada em cada passo seguinte. Uso de tokens do Claude Code: mantenha a saída de ferramenta fora do contexto mostra como.
O mesmo prompt longo em toda chamada
Pergunte ao seu provedor sobre cache de prompt, que pode reutilizar um início de prompt repetido em vez de lê-lo do zero a cada vez.
Se você usa o Claude Code, atualize-o e procure no changelog a nota sobre a linha de status.
Para o loop em si, o DeepSeek-V4-Flash (deepseek-) oferece contexto de 380K, até 32.768 tokens de saída por resposta e um preço a qualquer hora. O fim de 103.000 tokens do nosso exemplo cabe nessa janela mais de três vezes. Para notas e resumos, o GLM-5.3-Flash. Outros modelos estão na página de modelos.


