AI per principiantiGuida
Perché un agente AI rilegge tutta la sua cronologia a ogni passo
Una correzione della riga di stato di Claude Code mostra perché le lunghe sessioni degli agenti diventano costose: ogni chiamata reinvia la conversazione. Stima il costo e riducilo.
In questa pagina
Il tuo agente ha lavorato per dieci minuti e il conto è più alto di quanto sembri il compito. Quasi sempre il motivo è lo stesso: il modello non ricorda nulla tra una chiamata e l'altra, quindi ogni passo invia di nuovo come input l'intera conversazione fino a quel momento. Una sessione di 50 passi paga i suoi primi messaggi 50 volte, ed è per questo che il costo cresce più velocemente del lavoro svolto.
Una correzione che Anthropic ha annunciato per Claude Code il 4–5 novembre 2026 lo mostra in un punto piccolo. Qui sotto: cosa è cambiato, l'aritmetica di un ciclo di 50 passi e cosa puoi fare al riguardo.
Una riga di stato che rileggeva tutto#
Claude Code può avviare subagenti in background: agenti ausiliari che lavorano a un compito secondario mentre tu continui. Ognuno mostra una riga di stato, qualcosa come 'esecuzione test, 3 di 8 completati'.
L'account ClaudeDevs su X ha annunciato la modifica (il post è datato 5 novembre 2026; i resoconti secondari dicono 4 o 5 novembre). Lo stato si aggiornava ogni 30 secondi e ogni aggiornamento rileggeva l'intera conversazione del subagente. Ora Haiku 5.5 scrive lo stato da brevi note, e Anthropic stima un risparmio di circa il 99% per aggiornamento. È un dato per aggiornamento, non per sessione: il lavoro vero del subagente legge ancora la sua cronologia.
Immagina cosa significava il vecchio modo. Diciamo che un subagente abbia 60.000 token di conversazione al minuto venti. Lo stato in sé è forse 30 token. Ma per scrivere quei 30 token il modello doveva rileggere tutti i 60.000, due volte al minuto, per tutto il tempo in cui il subagente era in esecuzione.
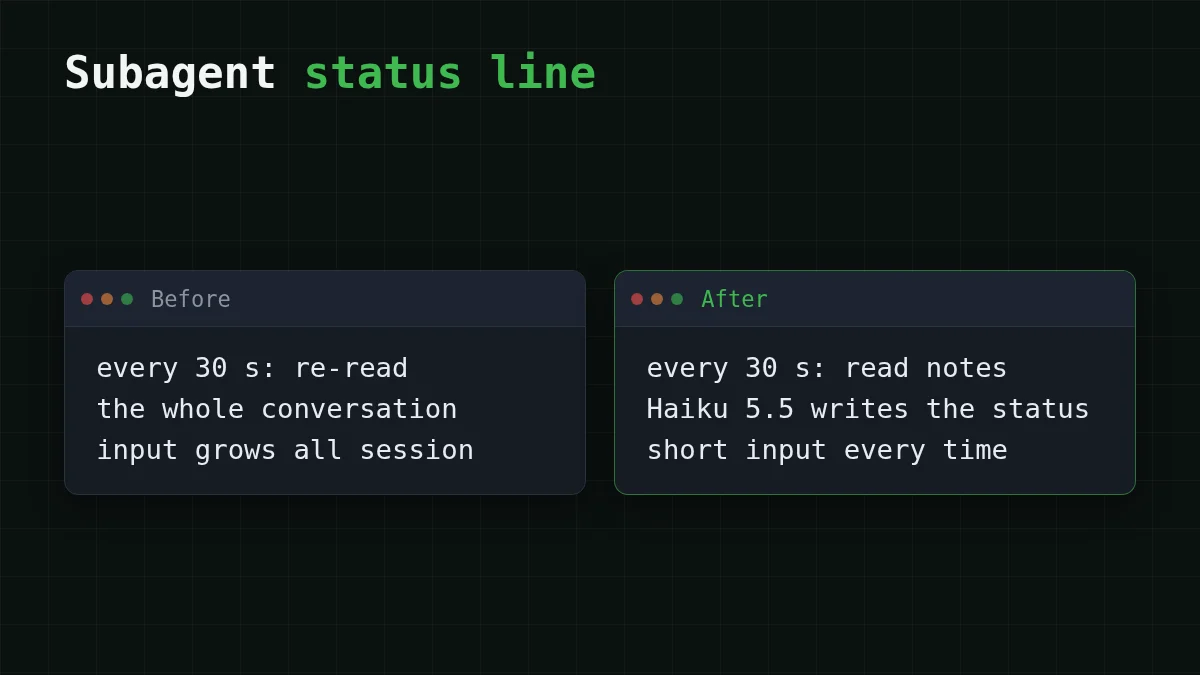
Nessuno ha bisogno della trascrizione completa per dire 'esecuzione test'. Bastano poche righe di note (cosa sto facendo, cosa è finito). È tutta qui la correzione: dai a un compito secondario le note, non la trascrizione.
Perché ogni passo reinvia la cronologia#
Pensa a una lettera a qualcuno che ti dimentica nel momento in cui risponde. Per continuare, invii di nuovo tutta la corrispondenza più la nuova riga. Un passo dell'agente è esattamente quella chiamata: il prompt di sistema, il tuo compito, ogni risposta precedente e ogni risultato degli strumenti entrano di nuovo. (La versione chat di questa storia è in perché una lunga chat AI costa di più.)
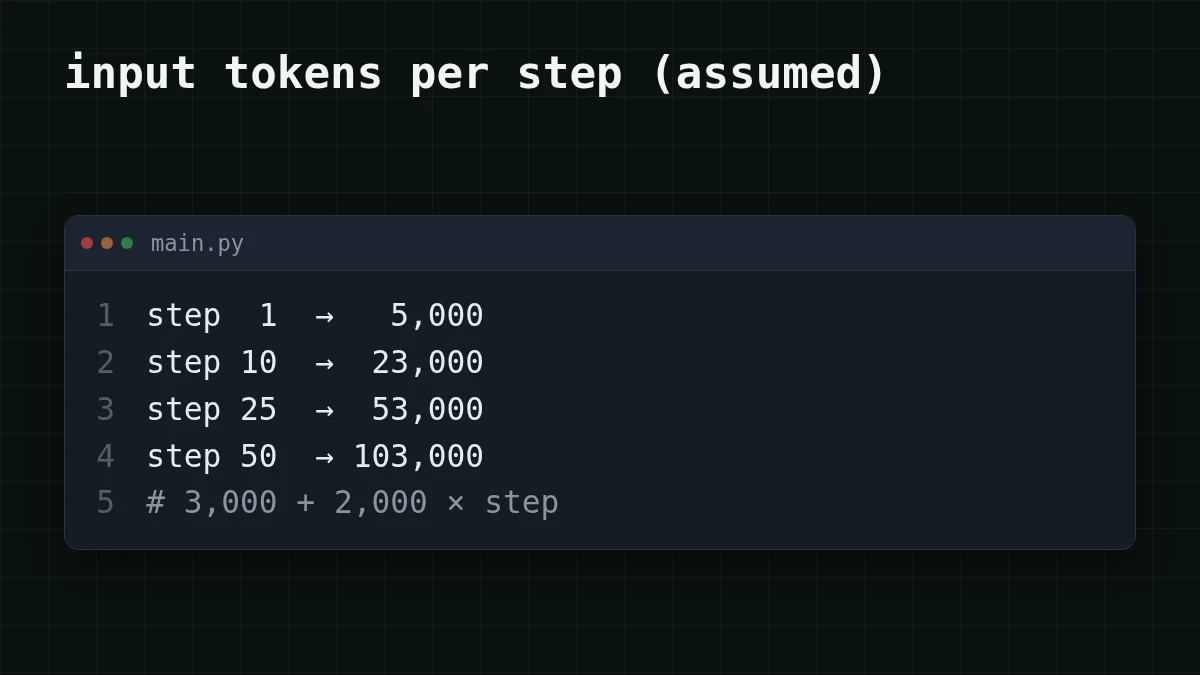
Mettiamoci dei numeri. Diciamo che il prompt di sistema e il compito occupino 3.000 token, e che ogni passo ne aggiunga circa 2.000 (la risposta del modello più l'output dello strumento che legge). Il passo n invia quindi 3.000 + 2.000 × n token: 5.000 al passo 1, 23.000 al passo 10, 103.000 al passo 50.
Indovina il numero
Quanti token di input invia il passo 50 di questo agente?
La tua risposta
0200.000
Mostra risposta
Risposta: 103.000
3.000 + 2.000 × 50 = 103.000. Il modello rilegge il prompt iniziale e tutti i 49 passi precedenti, poi il tuo nuovo passo in cima.
Ora somma tutti i 50 passi. La parte che cresce è 2,000 × 1,275 = 2,550,000, dove 1.275 è 1 + 2 + … + 50. Il prompt iniziale, inviato ogni volta, è 50 × 3,000 = 150,000. Insieme: 150,000 + 2,550,000 = 2,700,000 token di input. La conversazione finita contiene solo 103.000. Hai fatto passare 2,7 milioni di token attraverso il modello per ottenere una trascrizione di 103.000 token, e il conto segue il primo numero.
Quanto costa: un compito, un giorno#
Prezza lo stesso agente da 50 passi su DeepSeek-V4-Flash. Il passo medio invia 54.000 token, quindi 54,000 × 50 = 2,700,000 token di input in totale, e scrive circa 400 per passo (400 × 50 = 20,000). L'intero compito costa $0.0425. Ecco lo stesso carico di lavoro su ogni modello che abbiamo, accanto a OpenRouter:
| Modello | Input $/1M | Output $/1M | Per richiesta | 50 richieste | OpenRouter, 50 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 token di input e 400 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Nella tabella, ogni modello è più economico di OpenRouter in totale, contando insieme input e output.
Ora la riga di stato. 120 aggiornamenti sono un'ora di un subagente, e ognuno scrive circa 30 token (30 × 120 = 3,600 di output). Il vecchio modo: 60,000 × 120 = 7,200,000 token di input, più di due e mezzo dei compiti da 50 passi qui sopra, spesi per nient'altro che un testo di stato. Con una nota da 500 token sono 500 × 120 = 60,000. Su GLM-5.3-Flash sono $0.144 contro $0.0013.
Prova il tuo agente: token per passo, passi e compiti al giorno.
Calcolatore di costi
Un giorno di dieci compiti simili
Token di input per richiesta: 54.000 · Token di output per richiesta: 400 · Richieste al giorno: 500
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, chiave e una prima richiesta sono nella documentazione CheapTokens; i prezzi attuali per ogni modello sono nella pagina dei prezzi.
Quattro modi per ridurlo#
Nessuno di questi richiede uno strumento speciale. È l'abitudine di chiedersi: questa chiamata ha davvero bisogno della cronologia?
Il pattern delle note#
Tieni poche righe di note mentre l'agente lavora e passale solo a un modello piccolo quando ti serve uno stato o un riassunto. Ecco come si fa su GLM-5.3-Flash (zai-, contesto 390K, fino a 8.192 token di output per risposta):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Ricevi indietro una riga breve, e la coppia di usage mostra input nell'ordine delle decine di token, non delle decine di migliaia. È la stessa idea della modifica di Claude Code, in una dozzina di righe.
Quale abitudine si adatta al tuo caso?
Scegli il tuo caso
Qual è la tua situazione?
Scegli un'opzione per vedere la risposta
Una sessione, l'argomento è cambiato
Avvia una sessione nuova. Incolla cinque righe di note (obiettivo, cosa è fatto, cosa viene dopo) invece della vecchia trascrizione. Le opzioni di riduzione sono in ridurre la cronologia chat: finestra scorrevole o riassunto.
Un compito secondario: stato, riassunto, titolo
Dagli le note, non la cronologia, e invialo a un modello piccolo, come nel codice qui sopra.
Output enorme degli strumenti: log, dump dei test
Tienilo fuori dalla cronologia. Mostra le ultime 20 righe o l'unico test che fallisce, non l'intero dump: ogni riga che tieni viene reinviata a ogni passo successivo. Utilizzo dei token in Claude Code: tenere l'output degli strumenti fuori dal contesto mostra come fare.
Lo stesso lungo prompt a ogni chiamata
Chiedi al tuo provider del prompt caching, che può riutilizzare un inizio ripetuto del prompt invece di rileggerlo da zero ogni volta.
Se usi Claude Code, aggiornalo e cerca nel changelog la nota sulla riga di stato.
Per il ciclo stesso, DeepSeek-V4-Flash (deepseek-) ti dà un contesto di 380K, fino a 32.768 token di output per risposta e un prezzo unico a qualsiasi ora. La fine da 103.000 token del nostro esempio entra in quella finestra più di tre volte. Per note e riassunti, GLM-5.3-Flash. Gli altri modelli sono nella pagina dei modelli.


