Novità AIAggiornamento
Prezzo API di Claude Fable 5.2: $8 / $40, modalità fast a 2x
Claude Fable 5.2 costa $8 in input e $40 in output per 1M di token; la modalità fast raddoppia. Scopri l'id API e quanto costa una giornata di un agente.
In questa pagina
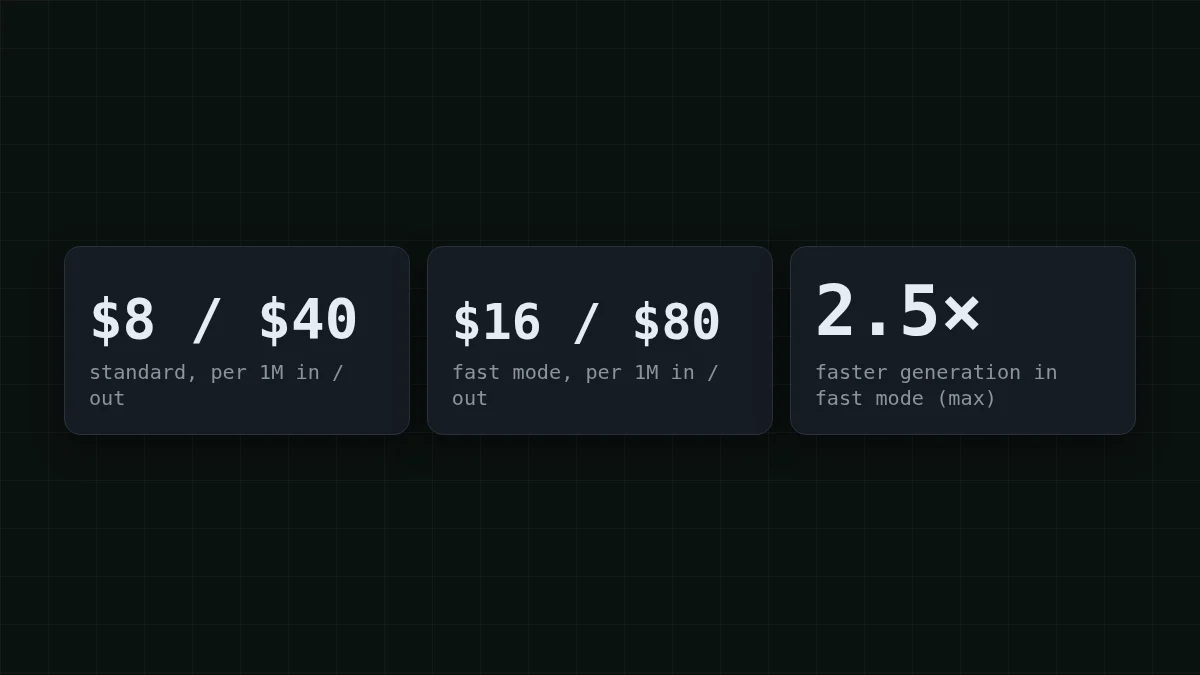
Claude Fable 5.2 è disponibile sull'API come claude-fable-5-2. Il prezzo standard è di $8 per 1M di token in input e $40 per 1M di token in output. La modalità fast genera fino a 2,5 volte più velocemente e costa esattamente il doppio: $16 / $80. Questo è quanto riportato dalla pagina di rilascio di Anthropic del 9 novembre 2026 (verificata il 10 novembre), e il resto di questo post riguarda cosa fanno quei numeri a una bolletta.
Il tuo agente ha girato per dieci minuti, e la bolletta è più grande del task. È la solita storia con un modello di fascia alta in un loop, quindi mettiamo dei numeri reali.
Cosa ha annunciato Anthropic#
La pagina di rilascio, Claude Fable and Mythos 5.2, dice:
- Fable 5.2 è disponibile ora sulla Claude Platform e su AWS, Google Cloud e Microsoft Azure.
- L'output è fino al 30% più veloce di Claude Fable 5.1 (affermazione di Anthropic stessa).
- La modalità fast è disponibile in Claude Code, sulla Claude Platform, su Claude Models su Google Cloud e su Microsoft Foundry.
- Mythos 5.2 è lo stesso modello di base con restrizioni più deboli, limitato alle organizzazioni approvate tramite i Cyber o Life Sciences Verification Programs. Fable ha salvaguardie più forti su cybersecurity e biologia ed è aperto a tutti gli utenti.
La pagina non indica la finestra di contesto né la lunghezza massima dell'output, e qui non le tiro a indovinare. Verificale nella documentazione di Anthropic prima di dimensionare un prompt.
Quanto costa un passo di un agente su Fable 5.2#
Diciamo che il tuo agente di coding faccia una tipica chiamata a metà task: 30.000 token in input (la cronologia che rilegge a ogni passo, più l'output degli strumenti) e 2.000 token in output.
- Input: 30.000 / 1.000.000 × $8 = $0,24
- Output: 2.000 / 1.000.000 × $40 = $0,08
- Un passo: $0,24 + $0,08 = $0,32
Sembra poco. Ora il loop: un agente che fa 200 passi in un giorno costa $0,32 × 200 = $64 al prezzo standard. In modalità fast sono $0,64 × 200 = $128 per lo stesso lavoro.
Nota dove finiscono i soldi: tre quarti di ogni passo sono il lato input, la cronologia che viene riletta. Se non hai mai capito perché succede, why AI agents use so many tokens illustra un esempio di 20 passi.
Indovina il numero
Un passo di un agente con 30.000 token in input e 2.000 in output su Fable 5.2 al prezzo standard: quanti centesimi?
La tua risposta
0100
Mostra risposta
Risposta: 32
32 centesimi: $0,24 per l'input più $0,08 per l'output. La modalità fast lo raddoppierebbe a 64.
La modalità fast vale il doppio?#
La modalità fast cambia la velocità, non la risposta: stesso modello, generazione fino a 2,5 volte più veloce, prezzo per token doppio. Se valga la pena dipende da chi sta aspettando.
Scegli il tuo caso
Dove esegui Fable 5.2?
Scegli un'opzione per vedere la risposta
Sono seduto davanti a Claude Code
Leggi ogni risposta e decidi la mossa successiva, quindi l'attesa è la parte costosa. La modalità fast è pensata esattamente per questo. Attivala nei periodi in cui stai guidando attivamente e disattivala quando ti allontani.
L'agente gira senza supervisione
Nessuno guarda l'orologio, quindi pagheresti il doppio per una velocità che nessuno usa. Resta sul prezzo standard e valuta quali passi richiedano davvero un modello di fascia alta.
Una cautela sull'aritmetica: "fino a 2,5 volte più veloce" è il tetto di Anthropic, non una promessa per ogni richiesta. Cronometra un tuo task in entrambe le modalità prima di decidere.
Dove si inserisce un modello più economico#
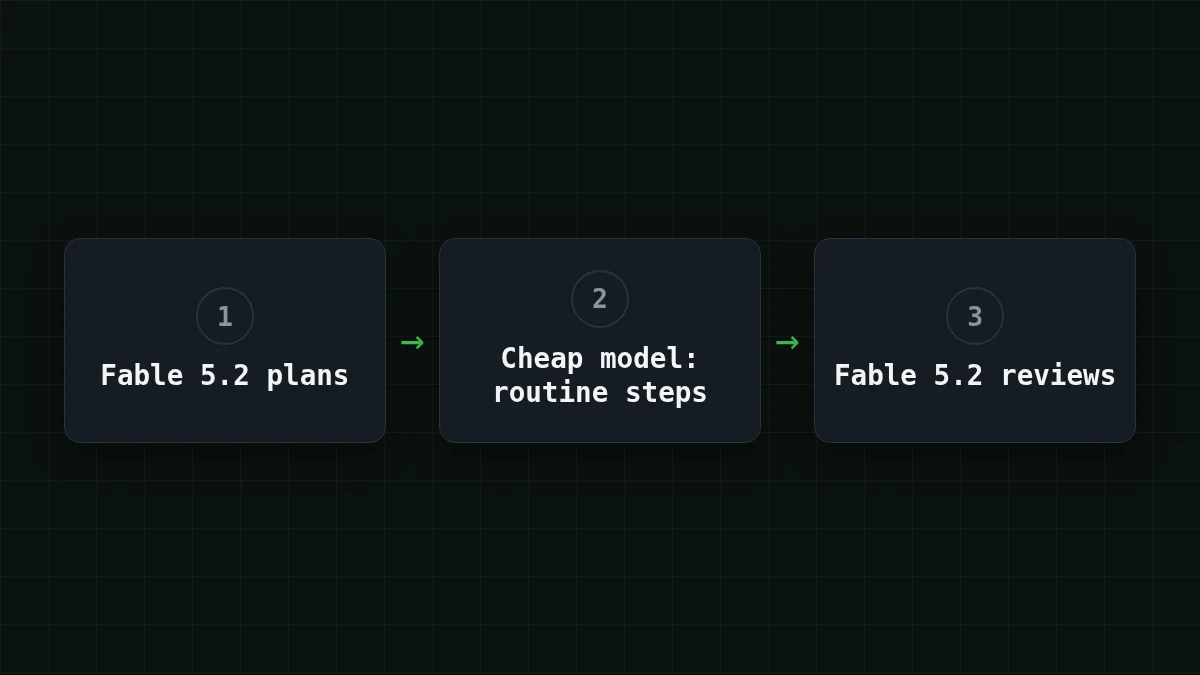
La maggior parte dei loop non è un unico problema difficile. Sono poche decisioni difficili avvolte in molti passi di routine: leggi un file, esegui un comando, riassumi l'output. Quei passi di routine non hanno bisogno del modello più costoso, ed è lì che si accumula il costo di una giornata.
Una suddivisione comune è lasciare che Fable 5.2 pianifichi e riveda, e inviare le chiamate di routine a un modello economico. Per quel ruolo, CheapTokens ha DeepSeek-V4-Flash: fino a 32.768 token per risposta, contesto da 380K, un unico prezzo a qualsiasi ora, e un'API compatibile con OpenAI e Anthropic. Esegui alcuni dei tuoi passi di routine su di esso e leggi usage nella risposta: ti mostra quanto costa davvero un passo.
Ecco lo stesso passo da 30.000 in input e 2.000 in output su di esso: $0.00065. E la giornata da 200 passi, in tempo reale dai prezzi attuali:
| Modello | Input $/1M | Output $/1M | Per richiesta | 200 richieste | OpenRouter, 200 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30.000 token di input e 2000 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La richiesta è una normale chiamata chat. Usa l'id completo del modello dalla documentazione di CheapTokens (deepseek-); l'id breve delle etichette di prezzo non è accettato dall'API.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
La risposta ha un blocco usage con prompt_tokens e completion_, così puoi calcolare il prezzo dei tuoi passi invece di fidarti dei miei 30.000 / 2.000. La configurazione è nella documentazione, i modelli sono sulla pagina DeepSeek, e model routing: cheap first, escalate spiega come decidere quale passo va dove. Per Claude Code nello specifico, vedi how to make Claude Code cheaper.
Verifica la tua comprensione#
Verifica rapida
Cos'è la modalità fast su Fable 5.2?
Mostra risposta
Risposta: Lo stesso modello che genera fino a 2,5 volte più velocemente al doppio del prezzo per token
Anthropic indica la modalità fast a $16 / $80 per 1M di token contro $8 / $40 standard.
Risposte brevi#
Qual è l'id API? claude-fable-5-2.
Quanto costa? $8 per 1M di token in input e $40 per 1M in output; modalità fast $16 / $80 (Anthropic, 9 novembre 2026).
Dove posso usarlo? Sulla Claude Platform, AWS, Google Cloud e Microsoft Azure; la modalità fast in Claude Code, sulla Claude Platform, su Google Cloud e su Microsoft Foundry.
Cos'è Mythos 5.2? Lo stesso modello di base con restrizioni più deboli, per le organizzazioni approvate tramite i programmi di verifica di Anthropic.


