AI 新闻更新
Claude Fable 5.2 API 价格:8 美元 / 40 美元,快速模式翻倍
Claude Fable 5.2 每 100 万 token 输入 8 美元、输出 40 美元;快速模式价格翻倍。查看 API ID 以及 agent 一天的成本。
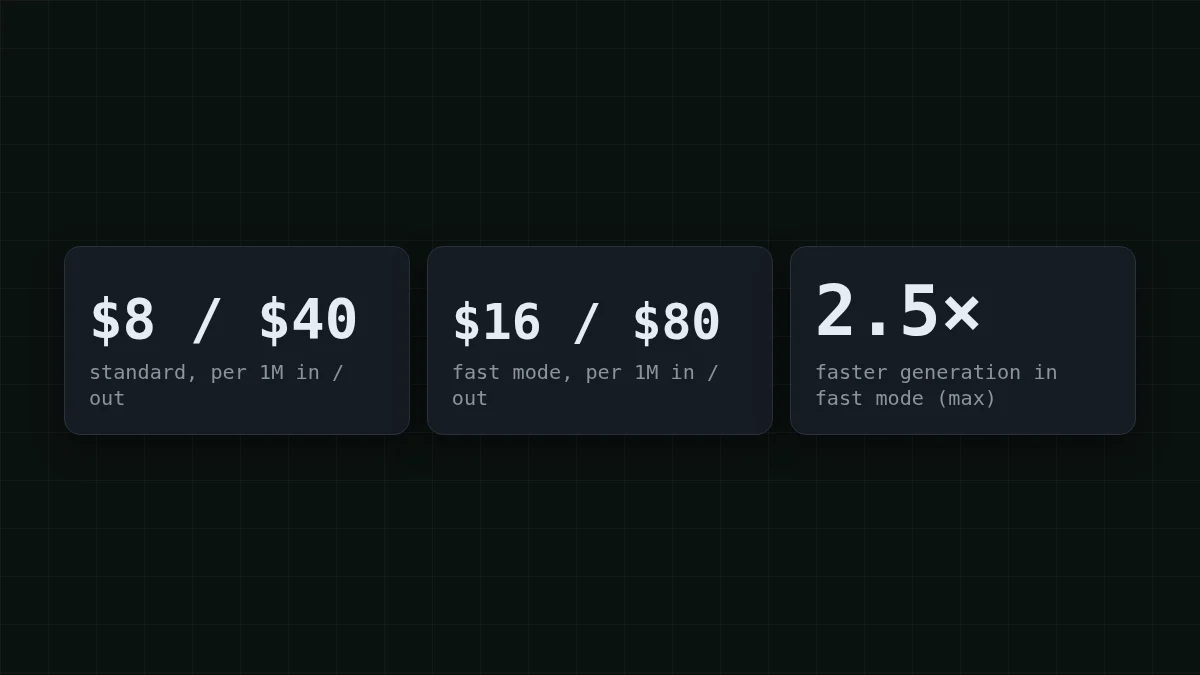
Claude Fable 5.2 已上线 API,模型 ID 为 claude-fable-5-2。标准价格为每 100 万输入 token 8 美元、每 100 万输出 token 40 美元。快速模式生成速度最高提升至 2.5 倍,价格恰好翻倍:16 美元 / 80 美元。以上信息来自 Anthropic 于 2026 年 11 月 9 日发布的页面(11 月 10 日核对),本文其余部分将讨论这些数字对账单的影响。
你的 agent 运行了十分钟,账单却比任务本身还贵。这是顶级模型在循环中运行的常见情况,所以我们用真实数字来算一算。
Anthropic 公布了什么#
发布页面 Claude Fable and Mythos 5.2 写道:
- Fable 5.2 现已在 Claude Platform 以及 AWS、Google Cloud 和 Microsoft Azure 上可用。
- 输出速度比 Claude Fable 5.1 快最多 30%(Anthropic 自己的说法)。
- 快速模式可在 Claude Code、Claude Platform、Google Cloud 上的 Claude Models 和 Microsoft Foundry 中使用。
- Mythos 5.2 是同一个底层模型,但限制更少,仅限通过 Cyber 或 Life Sciences 验证计划批准的组织使用。Fable 具有更强的网络安全和生物学防护措施,并对所有用户开放。
该页面没有给出上下文窗口或最大输出长度,我在这里也不做猜测。在确定提示词规模之前,请先在 Anthropic 文档中查看这些信息。
在 Fable 5.2 上,一个 agent 步骤的成本#
假设你的编码 agent 发起一次任务中段的典型调用:输入 30,000 个 token(它每一步都会重新读取的历史记录,加上工具输出),输出 2,000 个 token。
- 输入:30,000 / 1,000,000 × $8 = $0.24
- 输出:2,000 / 1,000,000 × $40 = $0.08
- 一个步骤:$0.24 + $0.08 = $0.32
这看起来不多。再看循环:一个 agent 一天执行 200 个步骤,按标准价格计算,成本为 $0.32 × 200 = $64。在快速模式下,同样的工作为 $0.64 × 200 = $128。
注意钱花在哪里:每个步骤的四分之三是输入侧,也就是被反复读取的历史记录。如果你从未见过这种情况为何发生,为什么 AI agent 会使用如此多的 token 通过一个 20 步的示例进行了说明。
猜数字
在 Fable 5.2 上,一个 agent 步骤输入 30,000 个 token、输出 2,000 个 token,按标准价格计算:多少美分?
你的猜测
0100
显示答案
答案: 32
32 美分:输入 $0.24 加输出 $0.08。快速模式会翻倍到 64。
快速模式值得双倍价格吗?#
快速模式改变的是速度,而非答案:同一模型,生成速度最高提升 2.5 倍,每 token 价格翻倍。是否值得,取决于谁在等待。
选择你的情况
你在哪里运行 Fable 5.2?
选择一个选项以查看答案
我坐在 Claude Code 前
你会阅读每条回复并决定下一步,所以等待才是昂贵的部分。快速模式正是为此设计。在你主动操控的时段开启,离开时关闭。
智能体无人值守运行
没人在看时钟,所以你会为无人使用的速度支付双倍价格。保持标准价格,并审视哪些步骤真正需要顶级模型。
关于算术的一点提醒:“最高 2.5 倍更快”是 Anthropic 的上限,并非对每个请求的承诺。在决定之前,用两种模式分别计时你自己的一个任务。
更便宜的模型适合用在哪里#
大多数循环并不是一个难题。它们是几个艰难决策包裹在许多例行步骤中:读取文件、运行命令、汇总输出。这些例行步骤不需要最贵的模型,而一天的成本正是在这里累积起来的。
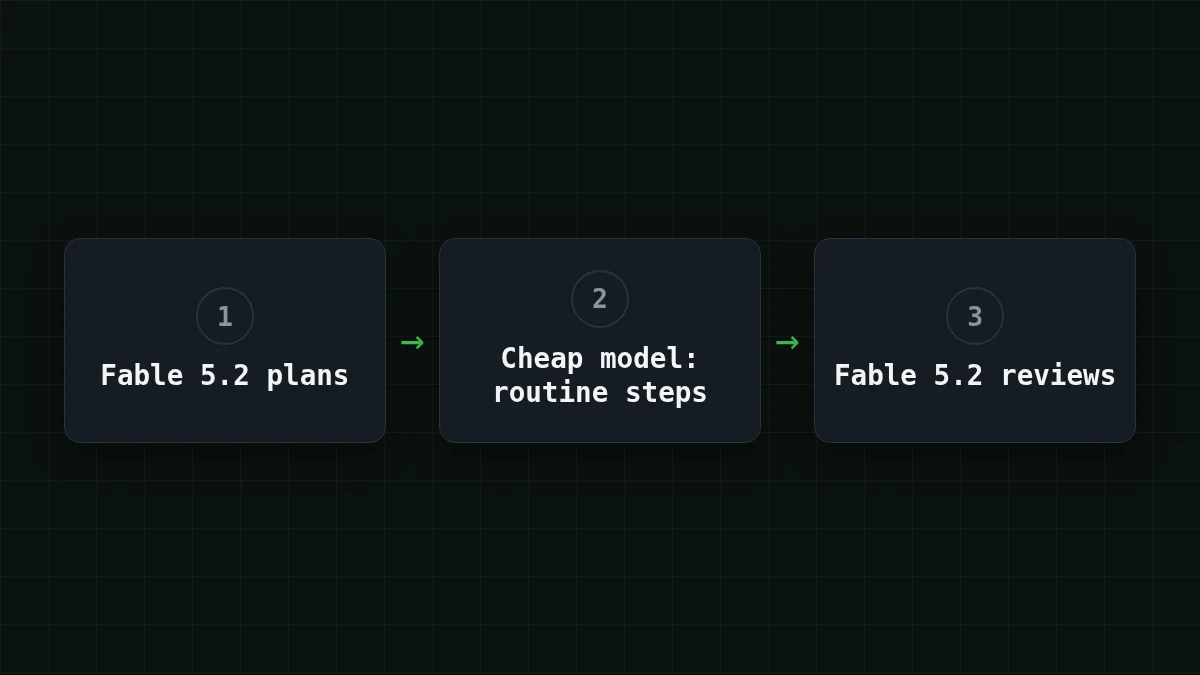
一种常见的分工是让 Fable 5.2 负责规划和审查,把例行调用交给便宜的模型。对于这个角色,CheapTokens 提供了 DeepSeek-V4-Flash:每次回答最多 32,768 个 token,380K 上下文,任何时段统一价格,并且提供兼容 OpenAI 和 Anthropic 的 API。把你自己的几个例行步骤跑在它上面,然后查看回复中的 usage:这能显示一个步骤真正花费你多少。
下面是同样的 30,000 输入、2,000 输出的步骤在它上面的情况:$0.00065。以及按当前价格实时计算的 200 步一天:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 200 次请求 | OpenRouter,200 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
每次请求 30,000 个输入 token 和 2,000 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
请求就是普通的聊天调用。使用 CheapTokens 文档中的完整模型 id(deepseek-);价格标签上的短 id 不会被 API 接受。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
回复中有一个 usage 块,包含 prompt_tokens 和 completion_,因此你可以为自己的步骤定价,而不必相信我的 30,000 / 2,000。设置见文档,模型在 DeepSeek 页面上,模型路由:便宜优先,逐步升级介绍了如何决定哪个步骤该用哪个模型。具体到 Claude Code,请参阅如何让 Claude Code 更便宜。
检查你的理解#
快速检查
Fable 5.2 上的快速模式是什么?
显示答案
答案: 同一个模型,生成速度最高提升 2.5 倍,但每 token 价格翻倍
Anthropic 将快速模式定价为每 100 万 token $16 / $80,而标准模式为 $8 / $40。
简短回答#
API id 是什么? claude-fable-5-2。
费用是多少? 每 100 万输入 token 8 美元,每 100 万输出 token 40 美元;快速模式为 16 美元 / 80 美元(Anthropic,2026 年 11 月 9 日)。
可以在哪里使用? Claude Platform、AWS、Google Cloud 和 Microsoft Azure;快速模式可在 Claude Code、Claude Platform、Google Cloud 和 Microsoft Foundry 中使用。
Mythos 5.2 是什么? 底层模型相同,但限制更少,面向通过 Anthropic 验证计划批准的组织。


