ข่าว AIอัปเดต
ราคา Claude Fable 5.2 API: $8 / $40 โหมดเร็ว 2 เท่า
Claude Fable 5.2 ราคา $8 เข้า และ $40 ออก ต่อ 1M tokens; โหมดเร็วเป็นสองเท่า ดู API id และค่าใช้จ่ายของเอเจนต์หนึ่งวัน
ในหน้านี้
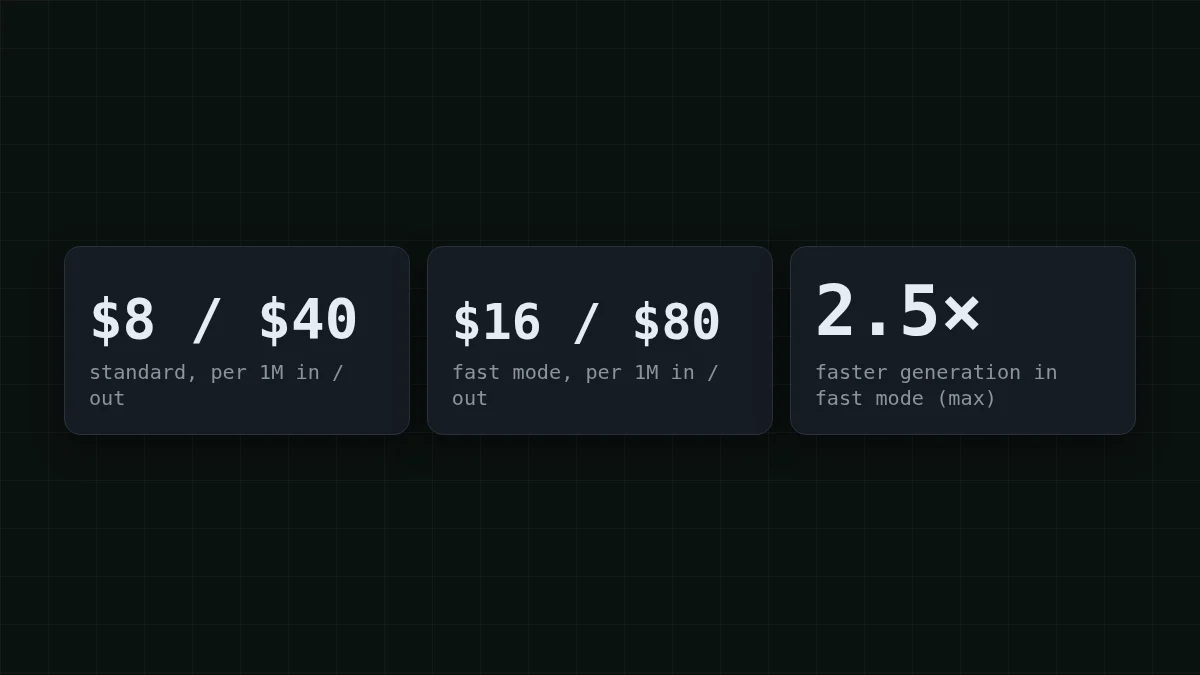
Claude Fable 5.2 อยู่บน API ในชื่อ claude-fable-5-2 ราคามาตรฐานคือ $8 ต่อ 1M input tokens และ $40 ต่อ 1M output tokens โหมดเร็วสร้างผลลัพธ์ได้เร็วขึ้นสูงสุด 2.5 เท่าและมีราคาเป็นสองเท่าพอดี: $16 / $80 ข้อมูลนี้มาจากหน้ารีลีสของ Anthropic วันที่ 9 พฤศจิกายน 2026 (ตรวจสอบเมื่อ 10 พฤศจิกายน) และส่วนที่เหลือของโพสต์นี้ว่าด้วยตัวเลขเหล่านี้ส่งผลต่อบิลอย่างไร
เอเจนต์ของคุณรันไปสิบนาที และบิลก็มากกว่างานเสียอีก นั่นคือเรื่องปกติเมื่อใช้โมเดลระดับท็อปในลูป ดังนั้นมาใส่ตัวเลขจริงกัน
Anthropic ประกาศอะไร#
หน้ารีลีส Claude Fable and Mythos 5.2 ระบุว่า:
- Fable 5.2 พร้อมใช้งานแล้วบน Claude Platform และบน AWS, Google Cloud และ Microsoft Azure
- Output เร็วขึ้นสูงสุด 30% เมื่อเทียบกับ Claude Fable 5.1 (ตามที่ Anthropic กล่าวอ้างเอง)
- โหมดเร็วพร้อมใช้งานใน Claude Code, Claude Platform, Claude Models บน Google Cloud และ Microsoft Foundry
- Mythos 5.2 เป็นโมเดลพื้นฐานเดียวกันที่มีข้อจำกัดน้อยกว่า จำกัดเฉพาะองค์กรที่ผ่านการอนุมัติผ่าน Cyber หรือ Life Sciences Verification Programs ส่วน Fable มีมาตรการป้องกันด้านความปลอดภัยไซเบอร์และชีววิทยาที่เข้มงวดกว่าและเปิดให้ผู้ใช้ทุกคน
หน้าเว็บไม่ได้ระบุ context window หรือความยาว output สูงสุด และผมจะไม่เดาตัวเลขเหล่านั้นที่นี่ ตรวจสอบได้ในเอกสาร Anthropic ก่อนกำหนดขนาดพรอมป์ต
หนึ่งขั้นของเอเจนต์บน Fable 5.2 ราคาเท่าไร#
สมมติว่าเอเจนต์เขียนโค้ดของคุณเรียกแบบกลางๆ ของงานทั่วไป: 30,000 tokens เข้า (ประวัติที่อ่านซ้ำทุกขั้น บวกผลลัพธ์จากเครื่องมือ) และ 2,000 tokens ออก
- Input: 30,000 / 1,000,000 × $8 = $0.24
- Output: 2,000 / 1,000,000 × $40 = $0.08
- หนึ่งขั้น: $0.24 + $0.08 = $0.32
ดูเหมือนน้อย ตอนนี้มาดูลูป: เอเจนต์ที่ใช้ 200 ขั้นต่อวันมีค่าใช้จ่าย $0.32 × 200 = $64 ที่ราคามาตรฐาน ในโหมดเร็วจะเป็น $0.64 × 200 = $128 สำหรับงานเดียวกัน
สังเกตว่าเงินไปไหน: สามในสี่ของแต่ละขั้นคือฝั่ง input นั่นคือประวัติที่ถูกอ่านซ้ำ หากคุณไม่เคยเห็นว่าทำไมถึงเป็นเช่นนั้น why AI agents use so many tokens อธิบายผ่านตัวอย่าง 20 ขั้น
ทายตัวเลข
หนึ่งขั้นของเอเจนต์ที่มี 30,000 tokens เข้าและ 2,000 ออกบน Fable 5.2 ที่ราคามาตรฐาน: กี่เซนต์?
คำตอบของคุณ
0100
แสดงคำตอบ
คำตอบ: 32
32 เซนต์: $0.24 สำหรับ input บวก $0.08 สำหรับ output โหมดเร็วจะเพิ่มเป็นสองเท่าคือ 64
โหมดเร็วคุ้มค่ากับราคาสองเท่าหรือไม่?#
โหมดเร็วเปลี่ยนความเร็ว ไม่ใช่คำตอบ: โมเดลเดิม สร้างเร็วขึ้นสูงสุด 2.5 เท่า ราคาต่อ token สองเท่า จะคุ้มหรือไม่ขึ้นอยู่กับว่าใครเป็นคนรอ
เลือกกรณีของคุณ
คุณรัน Fable 5.2 ที่ไหน?
เลือกตัวเลือกเพื่อดูคำตอบ
ผมนั่งอยู่หน้า Claude Code
คุณอ่านแต่ละคำตอบและตัดสินใจก้าวถัดไป การรอจึงเป็นส่วนที่แพง โหมดเร็วออกแบบมาเพื่อสิ่งนี้โดยตรง เปิดใช้ในช่วงที่คุณกำลังบังคับทิศทางอยู่ และปิดเมื่อคุณลุกไป
เอเจนต์รันแบบไม่มีคนดูแล
ไม่มีใครดูนาฬิกา คุณจึงจ่ายสองเท่าเพื่อความเร็วที่ไม่มีใครได้ใช้ ใช้ราคามาตรฐานต่อไป และพิจารณาว่าขั้นไหนที่จำเป็นต้องใช้โมเดลระดับท็อปจริงๆ
ข้อควรระวังเรื่องการคำนวณ: "เร็วขึ้นสูงสุด 2.5 เท่า" คือเพดานของ Anthropic ไม่ใช่คำสัญญาสำหรับทุกคำขอ จับเวลางานของคุณเองในทั้งสองโหมดก่อนตัดสินใจ
โมเดลที่ถูกกว่าจะเข้าที่ตรงไหน#
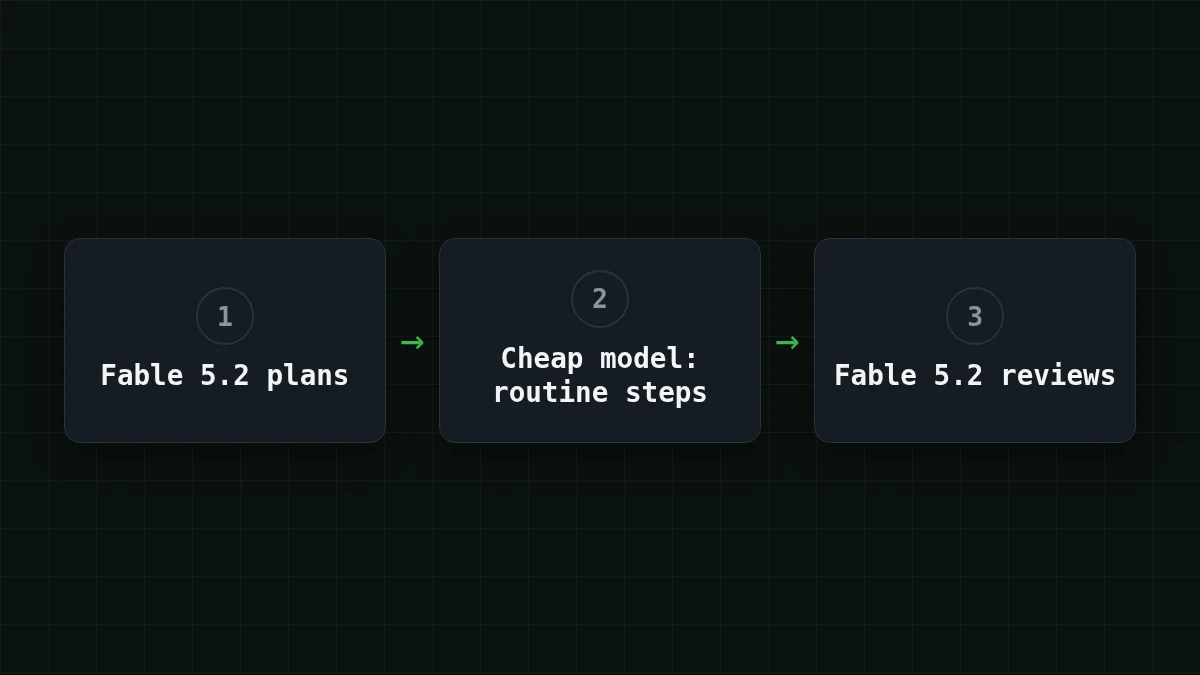
ลูปส่วนใหญ่ไม่ใช่ปัญหายากข้อเดียว แต่เป็นการตัดสินใจยากไม่กี่ครั้งที่ห่อหุ้มด้วยขั้นตอนroutine มากมาย: อ่านไฟล์ รันคำสั่ง สรุปผลลัพธ์ ขั้นตอนroutine เหล่านั้นไม่จำเป็นต้องใช้โมเดลที่แพงที่สุด และนั่นคือที่ที่ค่าใช้จ่ายของทั้งวันพอกพูน
รูปแบบที่พบบ่อยคือให้ Fable 5.2 วางแผนและรีวิว แล้วส่งการเรียกroutine ไปยังโมเดลราคาถูก สำหรับบทบาทนั้น CheapTokens มี DeepSeek-V4-Flash: สูงสุด 32,768 tokens ต่อคำตอบ, context 380K, ราคาเดียวทุกชั่วโมง และ API ที่เข้ากันได้กับ OpenAI และ Anthropic ลองรันขั้นตอนroutine ของคุณเองสักสองสามขั้นบนโมเดลนี้ แล้วอ่าน usage ในคำตอบ: นั่นจะแสดงว่าหนึ่งขั้นของคุณมีค่าใช้จ่ายจริงเท่าไร
นี่คือขั้นเดียวกันกับ 30,000 เข้า 2,000 ออก บนโมเดลนี้: $0.00065 และวัน 200 ขั้น คำนวณสดจากราคาปัจจุบัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 200 คำขอ | OpenRouter, 200 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30,000 โทเค็นอินพุตและ 2,000 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
คำขอเป็นแชททั่วไป ใช้ model id แบบเต็มจากเอกสาร CheapTokens (deepseek-) เพราะ API ไม่รับ id แบบสั้นจากป้ายราคา
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
คำตอบมีบล็อก usage พร้อม prompt_tokens และ completion_ เพื่อให้คุณคำนวณราคาขั้นตอนของคุณเองได้แทนที่จะเชื่อ 30,000 / 2,000 ของผม การตั้งค่าอยู่ในเอกสาร โมเดลต่างๆ อยู่บน หน้า DeepSeek และ model routing: cheap first, escalate อธิบายวิธีตัดสินใจว่าขั้นไหนควรไปที่ไหน สำหรับ Claude Code โดยเฉพาะ ดู how to make Claude Code cheaper
ตรวจสอบความเข้าใจ#
เช็กด่วน
โหมดเร็วบน Fable 5.2 คืออะไร?
แสดงคำตอบ
คำตอบ: โมเดลเดิมที่สร้างเร็วขึ้นสูงสุด 2.5 เท่าในราคาต่อ token สองเท่า
Anthropic ระบุโหมดเร็วที่ $16 / $80 ต่อ 1M tokens เทียบกับ $8 / $40 มาตรฐาน
คำตอบสั้นๆ#
API id คืออะไร? claude-fable-5-2
ราคาเท่าไร? $8 ต่อ 1M input และ $40 ต่อ 1M output tokens; โหมดเร็ว $16 / $80 (Anthropic, 9 พฤศจิกายน 2026)
ใช้ได้ที่ไหน? Claude Platform, AWS, Google Cloud และ Microsoft Azure; โหมดเร็วใน Claude Code, Claude Platform, Google Cloud และ Microsoft Foundry
Mythos 5.2 คืออะไร? โมเดลพื้นฐานเดียวกันที่มีข้อจำกัดน้อยกว่า สำหรับองค์กรที่ผ่านการอนุมัติผ่านโปรแกรมตรวจสอบของ Anthropic


