ข่าว AIอัปเดต
ราคา Meta Muse Ember API: $0.10 / $0.50, บริบท 1M
Muse Ember ของ Meta: ระดับราคา, บริบท 1M, เอาต์พุต 512K และค่าใช้จ่ายของเซสชันเอเจนต์ 50 ขั้น พร้อมทางเลือกงานย่อยราคาถูก
ในหน้านี้
Muse Ember ตัวใหม่ของ Meta เป็นโมเดลขนาดเล็กที่สร้างมาสำหรับขั้นตอนซ้ำ ๆ ราคาถูกภายในเอเจนต์ และตามประกาศของ Meta ราคาอยู่ที่ $0.10 สำหรับอินพุตและ $0.50 สำหรับเอาต์พุตต่อ 1M โทเคนเมื่อพรอมต์ไม่เกิน 200K โทเคน หากเกิน 200K ราคาจะเพิ่มขึ้นสามเท่า เซสชันเอเจนต์ 50 ขั้นที่ส่ง 20K โทเคนเข้าและ 500 ออกต่อขั้นจะอยู่ที่ประมาณ $0.11 บน Ember และบทบาทเดียวกันนี้เปิดให้คุณใช้ที่ CheapTokens กับ DeepSeek-V4-Flash
โมเดลนี้ประกาศเมื่อวันที่ 9 พฤศจิกายน 2026 บนบล็อกวิจัยของ Meta (research.meta.ai/blog/muse-ember); โพสต์ระบุวันที่แต่ไม่มีเวลา เราได้ตรวจสอบบล็อกและหน้าโมเดลที่ dev.meta.ai เมื่อวันที่ 10 พฤศจิกายน 2026
สิ่งที่ Meta ประกาศ#
Muse Ember (model id muse-ember-1.0) เป็นโมเดลที่เล็กที่สุดและมีประสิทธิภาพที่สุดในสาย Muse ของ Meta มุ่งเป้าไปที่งานย่อยของเอเจนต์: การเรียกเครื่องมือ, การสกัดข้อมูล, การจัดเส้นทาง, การแยกวิเคราะห์เอกสารยาว คุณเข้าถึงได้ผ่าน Muse Code, Meta Model API (โหมด Standard เท่านั้น), Google Cloud และ Oracle Cloud Meta ไม่ได้ประกาศน้ำหนักแบบเปิด ดังนั้น API และ Muse Code จึงเป็นช่องทางเข้า ไม่มีการระบุภูมิภาค
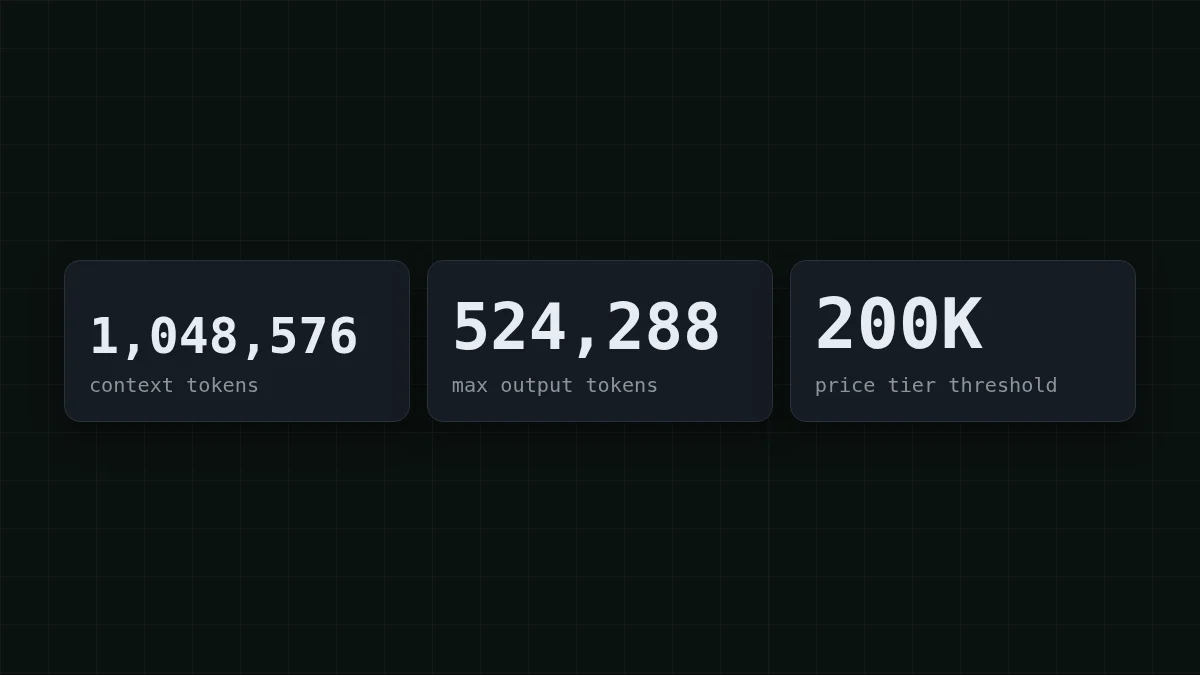
ขีดจำกัดจากหน้าโมเดลของ Meta (dev.meta.ai/docs/muse-ember, หน้าไม่มีวันที่) หน้าต่างบริบท — 1,048,576 โทเคน, เอาต์พุตสูงสุด — 524,288 โทเคน และระดับราคาที่สูงขึ้นเริ่มเมื่อพรอมต์เกิน 200K โทเคน
รับข้อความ, รูปภาพ, วิดีโอ, เสียง และ PDF เป็นอินพุตและคืนค่าข้อความ คุณเรียกใช้ได้ผ่าน endpoint Responses, Chat Completions หรือ Messages พร้อมการเรียกเครื่องมือ, เอาต์พุตแบบมีโครงสร้าง, การใช้คอมพิวเตอร์, การเข้าใจภาพ และการค้นหาอ้างอิง ระดับความพยายามในการให้เหตุผลมีตั้งแต่ minimal ถึง max และค่าเริ่มต้นคือ max ไม่มีการกล่าวถึงสตรีมมิ่งในหน้าเว็บ所以我们จะไม่ยืนยัน
Meta ยังเผยแพร่ตัวเลข benchmark ซึ่งเป็นของ Meta เอง ส่วนใหญ่ที่ระดับการให้เหตุผล max: Terminal-Bench 4.0 ที่ 40.9% เทียบกับ 39.2% ของ Haiku 5.5, AutomationBench-AA ที่ 37.8% เทียบกับ 13.9% และ 20.2% ของอีกสองตัวที่ Meta ระบุ และ FrontierCode 2.0-AA ที่ 27.2% ตามหลัง Haiku 5.5 ที่ 34.9% บน Artificial Analysis Intelligence Index ได้ 36 เทียบกับ 37 ของ Muse Spark 1.3 ให้ถือเป็นคำกล่าวอ้างของผู้ขายจนกว่าคุณจะทดสอบกับเคสของคุณเอง
เซสชัน 50 ขั้นบน Ember มีค่าใช้จ่ายเท่าไร#
ตารางราคา ตามประกาศของ Meta (หน้าโมเดลเองชี้ไปยังหน้าราคาที่ไม่มีตัวเลข):
เลื่อนตารางไปทางขวา →
| ขนาดพรอมต์ | อินพุต | อินพุตแคช | เอาต์พุต |
|---|---|---|---|
| ไม่เกิน 200K โทเคน | $0.10 | $0.004 | $0.50 |
| เกิน 200K โทเคน | $0.30 | $0.012 | $1.50 |
ราคาต่อ 1M โทเคน ตรวจสอบเมื่อ 10 พฤศจิกายน 2026 แหล่งข้อมูลทุติยภูมิอธิบายกฎเกิน 200K ต่างกัน ดังนั้นโปรดยืนยันบนหน้าราคาของ Meta ก่อนตั้งงบประมาณ
ทีนี้มาดูเซสชัน สมมติว่าเอเจนต์ของคุณทำ 50 ขั้น และแต่ละขั้นส่งประมาณ 20K โทเคน (ประวัติที่โตขึ้นบวกผลลัพธ์เครื่องมือ) และได้กลับมาประมาณ 500 โทเคน นั่นคือ 1M โทเคนเข้าและ 25K ออกทั้งหมด บน Ember: 1 × $0.10 + 0.025 × $0.50 = $0.1125 (จำนวนโทเคนเป็นล้าน) ฝั่งอินพุตเกือบเป็นค่าใช้จ่ายทั้งหมด ซึ่งเป็นเหตุผลว่าทำไมราคาอินพุตแคชที่ $0.004 จึงสำคัญหากเอเจนต์ของคุณเก็บคำนำหน้าเดิมไว้
ทายตัวเลข
สมมติว่าอัตราที่สูงขึ้นใช้กับพรอมต์ทั้งหมด (นั่นคือวิธีที่ถ้อยคำของ Meta อ่านได้) อินพุตของพรอมต์ 250K โทเคนบน Ember คิดเป็นกี่เซนต์?
คำตอบของคุณ
020
แสดงคำตอบ
คำตอบ: 7.5
หากอัตราที่สูงขึ้นใช้กับพรอมต์ทั้งหมด: 250,000 × $0.30 ต่อ 1M = $0.075 ดังนั้น 7.5 เซนต์สำหรับอินพุตอย่างเดียว ห้าสิบขั้นเช่นนี้จะเป็น $3.75 ของอินพุต
ทำไมต้องมีพรอมต์ยาว? เพราะเอเจนต์ส่งประวัติซ้ำในทุกขั้น; หากคุณยังไม่คุ้นเคย ทำไมเอเจนต์จึงอ่านประวัติทั้งหมดซ้ำ อธิบายด้วยตัวอย่างเล็ก ๆ
พรอมต์ของคุณอยู่ในระดับไหน?#
เส้น 200K คือจุดที่ต้องจับตา Meta ระบุอัตราสูงกว่าสามเท่าสำหรับพรอมต์ที่ยาวกว่า: $0.30 สำหรับอินพุต, $0.012 สำหรับอินพุตแคช และ $1.50 สำหรับเอาต์พุต
เลือกกรณีของคุณ
คำขอที่ใหญ่ที่สุดของเอเจนต์คุณอยู่ตรงไหน?
เลือกตัวเลือกเพื่อดูคำตอบ
ต่ำกว่า 200K โทเคน
คุณอยู่ในระดับล่าง ตั้งงบด้วย $0.10 เข้า / $0.50 ออก และจับตาฝั่งเอาต์พุตหากคุณคงระดับความพยายามในการให้เหตุผลไว้ที่ค่าเริ่มต้น
ระหว่าง 200K ถึง 1M โทเคน
ระดับที่สูงขึ้นมีผล และหน้าต่าง 1,048,576 โทเคนของ Ember ยังพอดีกับคุณ ตัดผลลัพธ์เครื่องมือเก่าก่อนที่จะข้าม 200K หรือแบ่งงานเพื่อให้มีเพียงขั้นเดียวที่ถือเอกสารเต็ม
เกิน 1M โทเคน
ไม่พอดีกับคำขอเดียว แบ่งอินพุตเป็นชิ้นและให้ planner รวมผลลัพธ์
บทบาทงานย่อยราคาถูกเดียวกันที่ CheapTokens#
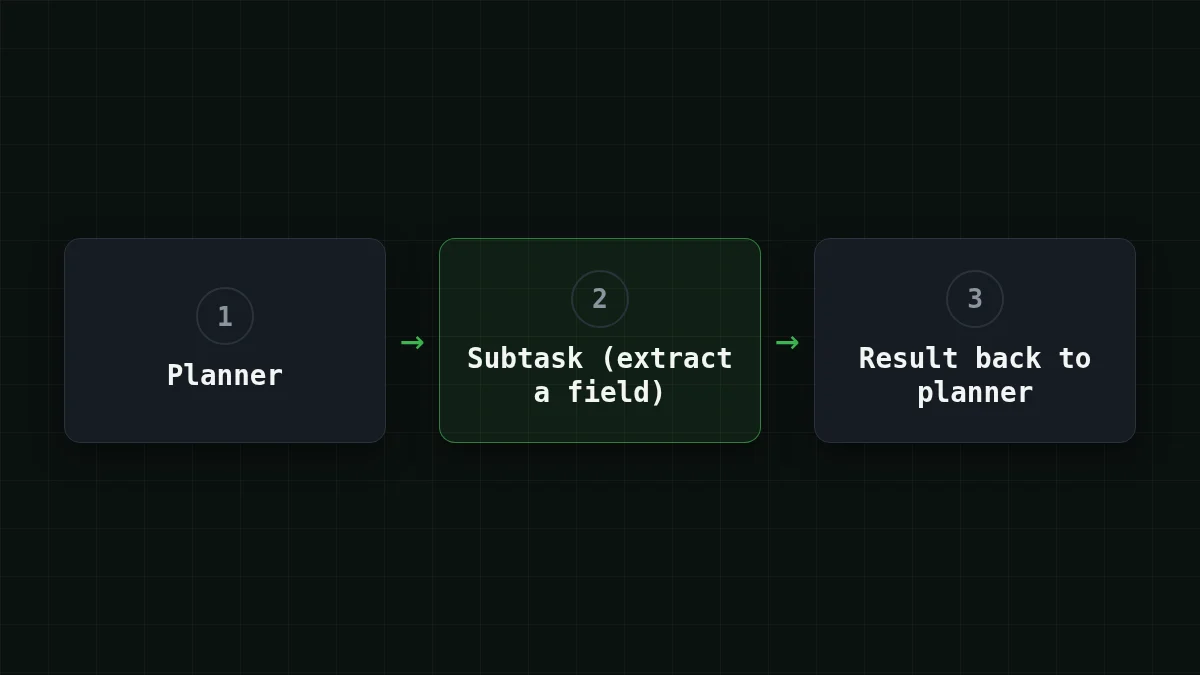
โครงสร้างเอเจนต์ทั่วไปเก็บโมเดลที่ใหญ่กว่าสำหรับการวางแผนและส่งงานย่อยซ้ำ ๆ ไปยังโมเดลราคาถูก สำหรับที่นั่งที่สองนั้น CheapTokens มี DeepSeek-V4-Flash: บริบท 380K, เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ, ราคาเดียวตลอดเวลาของวันโดยไม่มีช่วงพีค, API ที่เข้ากันได้กับ OpenAI และ Anthropic และยอดคงเหลือเดียวครอบคลุมทุกโมเดล GLM-5.3-Flash เป็นอีกตัวเลือกสำหรับลูปการเรียกเครื่องมือและการแยกวิเคราะห์เอกสารยาว ด้วยบริบท 390K และเอาต์พุตสูงสุด 8,192 โทเคน ลองรันงานย่อยของคุณเอง 20 งานบน DeepSeek-V4-Flash และเปรียบเทียบผลลัพธ์ด้วยฟิลด์ usage
นี่คือเซสชัน 50 ขั้นเดียวกัน ส่ง 20K โทเคนเข้าและ 500 ออกต่อขั้น ราคาแบบเรียลไทม์:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 50 คำขอ | OpenRouter, 50 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20,000 โทเค็นอินพุตและ 500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
บรรทัด DeepSeek-V4-Flash สำหรับทั้งเซสชันคือ $0.0175; โดยรวมเมื่อนับอินพุตและเอาต์พุตรวมกัน ออกมาถูกกว่าราคาอ้างอิงของ OpenRouter สำหรับโมเดลเดียวกัน ราคาบนหน้านี้อัปเดตเอง
การลองใช้ใช้เพียงหนึ่งคำขอ คีย์ใส่ในตัวแปรสภาพแวดล้อม และ model id คือตัวเต็มจากเอกสาร (เอกสาร มีรายการ; ราคา อัตราปัจจุบัน):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
คำตอบมีออบเจกต์ usage ตามปกติ ดังนั้นคุณสามารถอ่านจำนวนโทเคนอินพุตและเอาต์พุตจริงของงานย่อยและนำไปใส่ในตารางด้านบน สำหรับรูปแบบการจัดเส้นทางเอง ดู model routing: โมเดลราคาถูกก่อน, escalate และสำหรับข้อมูลเพิ่มเติมเกี่ยวกับโมเดล ดู DeepSeek บน CheapTokens
จับตาฝั่งเอาต์พุต#
ระดับความพยายามในการให้เหตุผลเริ่มต้นของ Ember คือ max และตัวเลข benchmark ของ Meta เองส่วนใหญ่รันแบบนั้น งานย่อยที่เพียงแค่ดึงฟิลด์ออกจากเอกสารไม่จำเป็นต้องใช้ และความพยายามในการให้เหตุผลที่สูงขึ้นอาจหมายถึงโทเคนเอาต์พุตมากขึ้น ซึ่งเป็นฝั่งที่แพงกว่า หน้าเว็บของ Meta ไม่ได้ระบุวิธีนับโทเคนการให้เหตุผล ดังนั้นอ่าน usage แทนการสันนิษฐาน
ลองด้วยตัวเองลองดู: คุณจะรู้ได้อย่างไรว่างานย่อยหนึ่งใช้จ่ายจริงเท่าไร?แสดงคำตอบ
ส่งงานย่อยจริง 20 งานที่ระดับความพยายามต่ำสุด จากนั้นที่ค่าเริ่มต้น และอ่าน usage ในแต่ละคำตอบ คูณค่าเฉลี่ยอินพุตและเอาต์พุตด้วยจำนวนขั้นต่อวันของคุณและคำนวณค่าใช้จ่ายตามราคาของ Ember จากตารางด้านบน หากคำตอบตรงกันในเคสของคุณ การตั้งค่าที่ถูกกว่าคือสิ่งที่ควรเก็บไว้ เหตุผลที่ได้ผลอยู่ใน ความพยายามในการให้เหตุผลและโทเคนการคิด
ข้อสรุปเชิงปฏิบัติสำหรับนักพัฒนา: Ember ตั้งราคาสำหรับที่นั่งราคาถูกในเอเจนต์ เส้น 200K คือตัวเลขที่ต้องออกแบบให้สอดคล้อง และตัวเลขเดียวที่ชี้ขาดคือตัวเลขจากฟิลด์ usage ของคุณเอง


