การลดต้นทุนคู่มือ
การกำหนดเส้นทางโมเดลเพื่อลดค่าใช้จ่าย API: โมเดลราคาถูกก่อน แล้วยกระดับ
ส่งคำขอที่ง่ายไปยังโมเดลราคาถูกและยกระดับเฉพาะคำขอที่ยาก ดูค่าใช้จ่ายผสมของ 10,000 คำขอที่การยกระดับ 10%, 30% และ 50% พร้อมเราเตอร์ Python สั้นๆ
ในหน้านี้
การกำหนดเส้นทางสามารถลดค่าใช้จ่ายได้เมื่อโมเดลราคาถูกให้ผลลัพธ์รอบแรกถูกกว่ามากเมื่อเทียบกับโมเดลที่สอง และมีคำขอไม่มากที่ต้องยกระดับ: ส่งทุกคำขอไปยังโมเดลราคาถูกก่อน แล้วส่งเฉพาะคำขอที่ยากไปยังโมเดลที่สอง การประหยัดจริงหรือไม่ขึ้นอยู่กับสัดส่วนคำขอที่คุณยกระดับ ด้านล่างคือการคำนวณสำหรับ 10,000 คำขอที่ 10%, 30% และ 50% พร้อมฟังก์ชัน Python ที่คุณคัดลอกไปใช้ในโปรเจกต์ได้
รูปแบบนี้ไม่ใช่เรื่องใหม่ โพสต์วิศวกรรมของ Anthropic "Building effective agents" (19 ธันวาคม 2024) เรียกสิ่งนี้ว่าเวิร์กโฟลว์การกำหนดเส้นทาง: คำถามทั่วไปที่ง่ายจะไปยังโมเดลที่เล็กกว่าและคุ้มต้นทุน ส่วนคำถามที่แปลกและยากจะไปยังโมเดลที่ความสามารถสูงกว่า โพสต์นั้นไม่ได้ให้ราคา ตัวเลขในที่นี้จึงเป็นของเราเอง โดยอิงราคาสดของ CheapTokens
คำขอใดของคุณที่ง่าย?#
การกำหนดเส้นทางจะได้ผลก็ต่อเมื่อคุณบอกได้ด้วยกฎว่า "ยาก" หมายถึงอะไร ไม่ใช่ด้วยความรู้สึก แต่เป็นกฎที่โค้ดตรวจสอบได้ เลือกกรณีที่ใกล้เคียงกับของคุณที่สุด:
เลือกกรณีของคุณ
เลือกกรณีของคุณ
เลือกตัวเลือกเพื่อดูคำตอบ
แชทบอทสนับสนุน
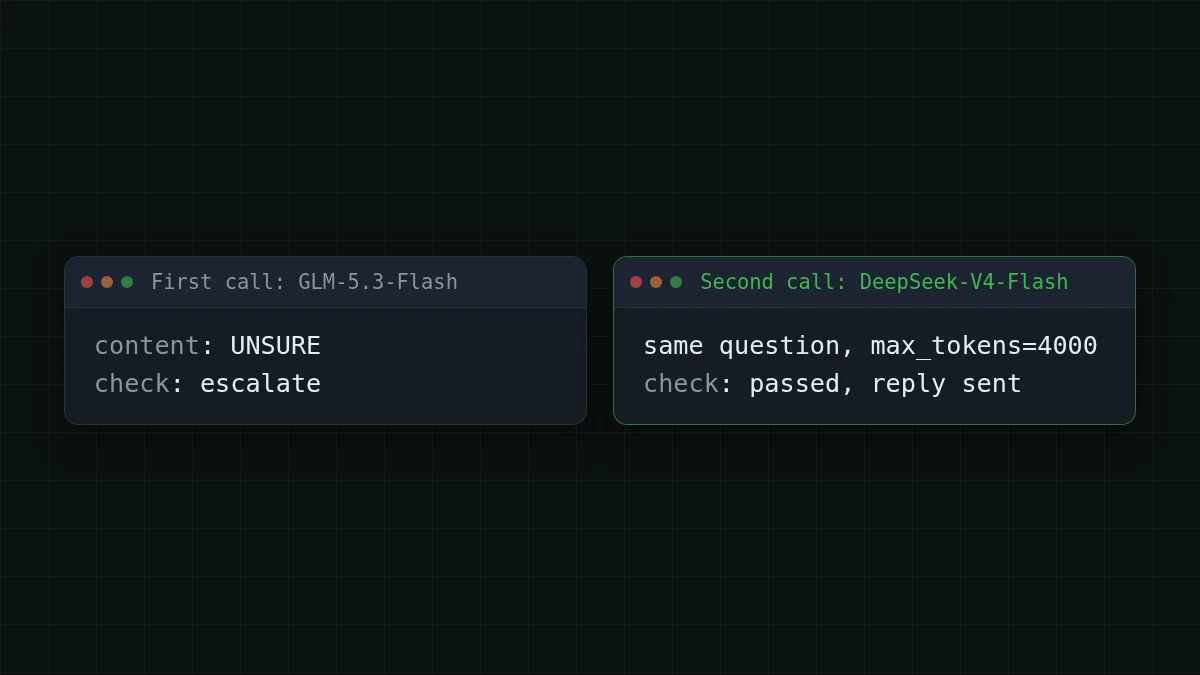
ตั๋วส่วนใหญ่เป็นคำถามที่พบบ่อยสั้นๆ: คำสั่งซื้อของฉันอยู่ที่ไหน รีเซ็ตรหัสผ่านอย่างไร มีไม่กี่รายการที่ต้องการคำตอบยาวและละเอียด ง่าย: โมเดลแรกตอบและไม่ตอบกลับ UNSURE ยาก: มันตอบ UNSURE หรือคำตอบถูกตัด (finish_reason เป็น length)
ไปป์ไลน์เอกสาร
ทุกเอกสารผ่านการสกัดก่อน ง่าย: ผลลัพธ์แยกวิเคราะห์เป็น JSON ที่ถูกต้องพร้อมฟิลด์ที่จำเป็นครบถ้วน ยาก: การแยกวิเคราะห์ล้มเหลวหรือฟิลด์ว่าง เฉพาะเอกสารเหล่านั้นเท่านั้นที่รันซ้ำบนโมเดลที่สอง
เอเจนต์เขียนโค้ด
การแก้ไขง่ายๆ ไปยังโมเดลราคาถูก ยกระดับขั้นตอนเมื่อขั้นตอนเดิมล้มเหลวสองครั้งติดต่อกัน หรือเมื่อคำตอบถูกตัด (finish_reason เป็น length)
อย่ายกระดับเพียงเพราะ "โมเดลดูไม่มั่นใจ" เว้นแต่คุณบอกวิธีให้มันสื่อออกมา คำสั่งบรรทัดเดียว ("ตอบกลับ UNSURE เป๊ะๆ หากคุณตอบไม่ได้") เปลี่ยนความรู้สึกให้เป็นสิ่งที่ if อ่านได้
10,000 คำขอมีค่าใช้จ่ายเท่าไร: แบบคาสเคดเทียบกับเราเตอร์#
สมมติว่าคุณรันบอทสนับสนุนด้วย 10,000 คำขอต่อเดือน คำขอเฉลี่ย 800 โทเค็นขาเข้าและ 300 โทเค็นขาออก นี่คือสมมติฐาน; เปลี่ยนเป็นของคุณเองจาก usage (บทความการนับโทเค็น ของเราแสดงว่าอ่านได้จากที่ไหน)
มีสองวิธีในการต่อสายการกำหนดเส้นทาง และคิดเงินต่างกัน:
- คาสเคด ทุกคำขอไปยังโมเดลราคาถูก สัดส่วน p ไม่ผ่านการตรวจและถูกส่งอีกครั้งไปยังโมเดลที่สอง คำขอเหล่านั้นจ่ายสองครั้ง: ค่าใช้จ่าย = N × [ราคาถูก + p × โมเดลที่สอง]
- เราเตอร์ การเรียกตัวจำแนกขนาดเล็กตัดสินใจล่วงหน้า ง่ายไปยังโมเดลราคาถูก ยากไปยังโมเดลที่สองโดยตรง: ค่าใช้จ่าย = N × [(1 − p) × ราคาถูก + p × โมเดลที่สอง] บวกตัวจำแนกในทุกคำขอ
เราจะใช้คาสเคด เพราะไม่ต้องมีตัวจำแนกและเริ่มต้นได้ง่ายกว่า รอบแรกคือ GLM-5.3-Flash (zai-, คอนเท็กซ์ 390K, เอาต์พุตสูงสุด 8,192 โทเค็น) รอบที่สองคือ DeepSeek-V4-Flash รีลีส 0731 (deepseek-, คอนเท็กซ์ 380K, เอาต์พุตสูงสุด 32,768 โทเค็น) ดังนั้นคำตอบที่ไม่พอใน 8,192 โทเค็นจึงมีที่ให้จบ ทั้งคู่ถูกกว่า OpenRouter โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน ตารางสดด้านล่างแสดงคอลัมน์ OpenRouter เทียบกับของเรา
รอบแรกครอบคลุมทั้ง 10,000 คำขอเสมอ: อินพุต 8,000,000 และเอาต์พุต 3,000,000 โทเค็น รอบที่สองครอบคลุมเฉพาะสัดส่วนที่ยกระดับ คอลัมน์สุดท้ายคือทางเลือก: ทั้ง 10,000 คำขอไปยังโมเดลที่สองโดยตรง
เลื่อนตารางไปทางขวา →
| สัดส่วนที่ยกระดับ | โทเค็นรอบที่สอง (เข้า / ออก) | รอบแรก ทั้ง 10,000 | รอบที่สอง เฉพาะที่ยกระดับ | ทั้งหมดบนโมเดลที่สอง ทั้ง 10,000 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
บวกคอลัมน์รอบแรกและรอบที่สองในแต่ละแถวเพื่อให้ได้ยอดต่อเดือนของคาสเคด แล้วเปรียบเทียบผลรวมนั้นกับคอลัมน์สุดท้าย รอบแรกเป็นต้นทุนคงที่ และมีเพียงรอบที่สองที่โตตาม p นั่นคือเรื่องทั้งหมดของคาสเคด: ยิ่งคุณยกระดับมากเท่าไร คุณก็ยิ่งใกล้จ่ายค่างานสองครั้งมากขึ้นเท่านั้น
นี่คือโหลดเดียวกันสำหรับทุกโมเดลพร้อมกัน เพื่อให้คุณเห็นว่าตัวเลือกโมเดลเดียวอยู่ตรงไหน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 10,000 คำขอ | OpenRouter, 10,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
เมื่อใดที่คาสเคดไม่คุ้ม? เมื่อรอบแรกบวกสัดส่วนที่ยกระดับมีค่าใช้จ่ายมากกว่าการส่งทุกอย่างไปยังโมเดลที่สอง ในสัญลักษณ์: ราคาถูก + p × โมเดลที่สอง < โมเดลที่สอง ซึ่งหมายถึง p < 1 − ราคาถูก/โมเดลที่สอง สำหรับคู่นี้ รอบแรกมีค่าใช้จ่ายเป็นสัดส่วนที่เห็นได้ชัดของราคาโมเดลที่สองบนโหลดนี้ ดังนั้นกำไรจากคาสเคดจึงหดลง และที่สัดส่วนการยกระดับสูงมันก็หายไป ที่ 50% คาสเคดอาจแพ้การส่งทั้ง 10,000 คำขอไปยังโมเดลที่สองโดยตรง ดังนั้นตรวจสอบผลรวมของสองรอบเทียบกับคอลัมน์สุดท้ายก่อนตัดสินใจ อัตราส่วนขึ้นอยู่กับส่วนผสมอินพุต/เอาต์พุตของคุณ เพราะสองโมเดลคิดราคาสองด้านต่างกัน ดังนั้นอ่านจากแถวของคุณเอง
ตัวแปรเราเตอร์เพิ่มสิ่งหนึ่ง: ตัวจำแนก สมมติว่ามันอ่านอินพุต 300 โทเค็นและตอบใน 5 โทเค็นบนโมเดลราคาถูก ต่อคำขอ สำหรับ 10,000 คำขอ นั่นคืออินพุต 3,000,000 และเอาต์พุต 50,000 โทเค็น หรือ $0.062 ต่อเดือนเพิ่มเติม เปรียบเทียบบรรทัดนี้กับสัดส่วน p ของคอลัมน์รอบแรก (10%, 30% หรือ 50% ของมัน): นั่นคือสิ่งที่คาสเคดเสียเปล่าโดยการรันรอบแรกบนคำขอที่แล้วยกระดับ หากบรรทัดตัวจำแนกใหญ่กว่า คาสเคดคือจุดเริ่มต้นที่ถูกกว่า; หากเล็กกว่า เราเตอร์ประหยัดกว่า
ลองตัวเลขของคุณเองก่อนสร้างอะไร:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งเดือนของบอทสนับสนุน ทั้งหมดบนโมเดลเดียว
โทเค็นอินพุตต่อคำขอ: 800 · โทเค็นเอาต์พุตต่อคำขอ: 300 · คำขอต่อวัน: 10,000
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
เปลี่ยน runs เป็นปริมาณของคุณและอ่านยอดรวมสำหรับแต่ละโมเดล จากนั้นใช้ตารางด้านบนเพื่อดูว่ารอบที่สองจะเพิ่มเท่าไร
เราเตอร์ใน Python: สองการเรียกและการตรวจหนึ่งครั้ง#
ทั้งสองโมเดลอยู่หลัง base URL เดียวที่เข้ากันได้กับ OpenAI และยอดเงินเดียว ดังนั้นการกำหนดเส้นทางไม่ต้องมีบัญชีหรือคีย์ที่สอง โค้ดด้านล่างเป็นตัวอย่าง: ตัวเลขในนั้น (max_tokens, กฎ UNSURE) เป็นของคุณที่จะปรับแต่ง การเรียกครั้งที่สองได้ max_tokens สูงกว่า ดังนั้นคำตอบที่ถูกตัดที่ 600 โทเค็นจึงจบได้ Base URL, model ids และอื่นๆ อยู่ใน เอกสาร CheapTokens
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text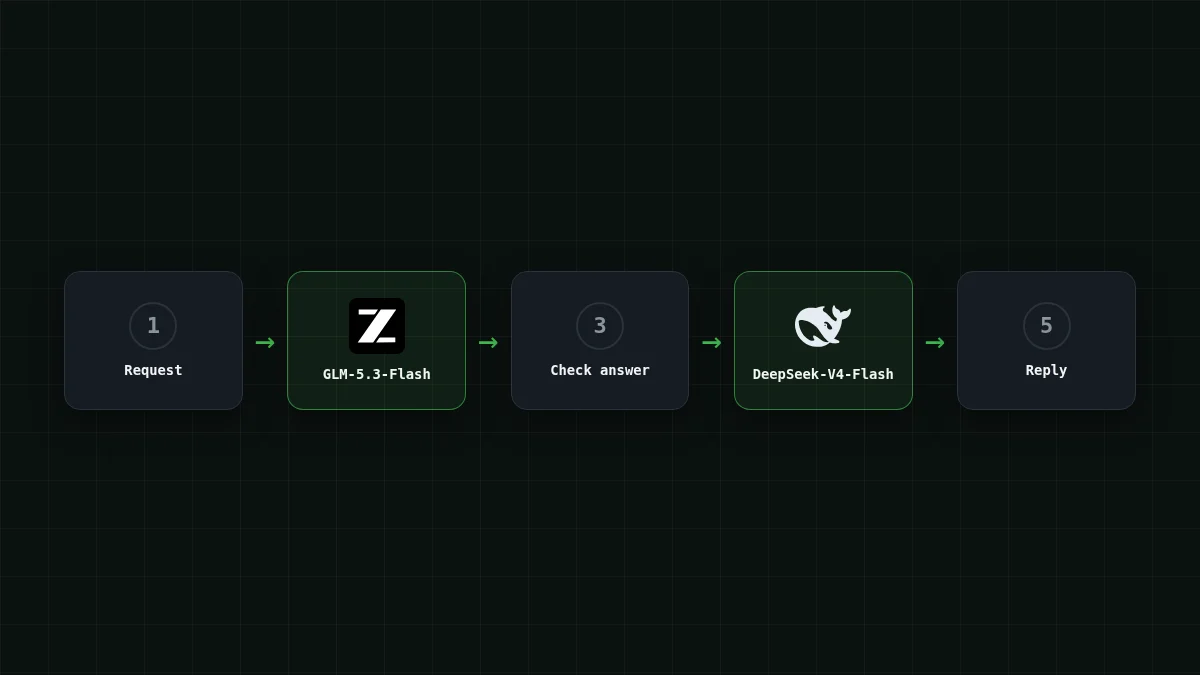
สามนิสัยทำให้สิ่งนี้ซื่อสัตย์ไม่ใช่แค่ถูก:
- นับการยกระดับ บันทึกว่า
needs_escalationทำงานบ่อยแค่ไหน นั่นคือ p ของคุณ และเป็นตัวเลขที่ตัดสินว่าคาสเคดคุ้มหรือไม่ - เลือกโมเดลที่สองจากชุดทดสอบของคุณเอง นำ 50 คำขอยากจากบันทึกของคุณ รันผ่านทั้งสองโมเดล และเก็บโมเดลที่สองไว้เฉพาะเมื่อมันแก้สิ่งที่โมเดลแรกพลาดไป จุดเด่นที่เอกสารระบุคือขีดจำกัดคำตอบ 32,768 โทเค็น และชุดของคุณเองแสดงว่านั่นคือจุดเด่นที่คุณต้องการหรือไม่
- ส่งคำขอเดิม ไม่ใช่คำขอที่ยาวขึ้น หากคุณวางคำตอบที่ล้มเหลวลงในการเรียกครั้งที่สอง คุณจ่ายมันเป็นอินพุต เริ่มรอบที่สองใหม่สะอาด เว้นแต่คำตอบแรกจะเป็นบริบทที่มีประโยชน์จริงๆ
ตรวจสอบตัวเอง#
เช็กด่วน
ในคาสเคด 30% ของคำขอล้มเหลวการตรวจบนโมเดลแรก คำขอเหล่านั้นมีค่าใช้จ่ายเท่าไร?
แสดงคำตอบ
คำตอบ: ราคาโมเดลแรกบวกราคาโมเดลที่สอง
การเรียกครั้งแรกถูกคิดเงินแล้วเมื่อคุณทิ้งคำตอบ คำขอที่ยกระดับจ่ายสองครั้ง ซึ่งเป็นเหตุผลที่สัดส่วน p ตัดสินทุกอย่าง
ไปที่ไหนต่อ#
หากคุณไม่แน่ใจว่าโมเดลใดควรรับรอบแรก MiniMax-M2.7 vs DeepSeek-V4-Flash เปรียบเทียบตามงาน สำหรับมุมมองต่องานแทนที่จะต่อโทเค็น ดู ราคาต่อ 1M โทเค็นเทียบกับค่าใช้จ่ายต่องาน และสำหรับลูปที่มีหลายขั้นตอน วิธีประมาณค่าใช้จ่ายของเอเจนต์ AI ราคาสดของทุกโมเดลอยู่ที่ หน้าราคา และหน้าโมเดลคือ DeepSeek และ GLM


