Optymalizacja kosztówPrzewodnik
Routing modeli, aby obniżyć koszt API: najpierw tani model, eskaluj
Wysyłaj łatwe żądania do taniego modelu i eskaluj tylko trudne. Zobacz łączny koszt 10 000 żądań przy 10%, 30% i 50% eskalacji oraz krótki router w Pythonie.
Na tej stronie
Routing może obniżyć rachunek, gdy pierwsze przejście taniego modelu jest znacznie tańsze niż drugi model, a niewiele żądań jest eskalowanych: najpierw wyślij każde żądanie do taniego modelu, a tylko trudne wyślij ponownie do drugiego modelu. To, czy faktycznie oszczędzasz, zależy od udziału żądań, które eskalujesz. Poniżej znajduje się arytmetyka dla 10 000 żądań przy 10%, 30% i 50% oraz funkcja w Pythonie, którą możesz wkleić do swojego projektu.
Wzorzec nie jest nowy. Wpis inżynierski Anthropic "Building effective agents" (19 grudnia 2024) nazywa to workflow routingu: typowe, łatwe pytania trafiają do mniejszego, efektywnego kosztowo modelu, a nietypowe, trudne do bardziej zdolnego. Wpis nie podaje cen, więc liczby tutaj są nasze własne, na aktualnych cenach CheapTokens.
Które z Twoich żądań są łatwe?#
Routing działa tylko wtedy, gdy potrafisz powiedzieć, w regule, co oznacza "trudne". Nie w odczuciu, w regule, którą kod może sprawdzić. Wybierz przypadek najbliższy Twojemu:
Wybierz swój przypadek
Wybierz swój przypadek
Wybierz opcję, aby zobaczyć odpowiedź
Chatbot wsparcia
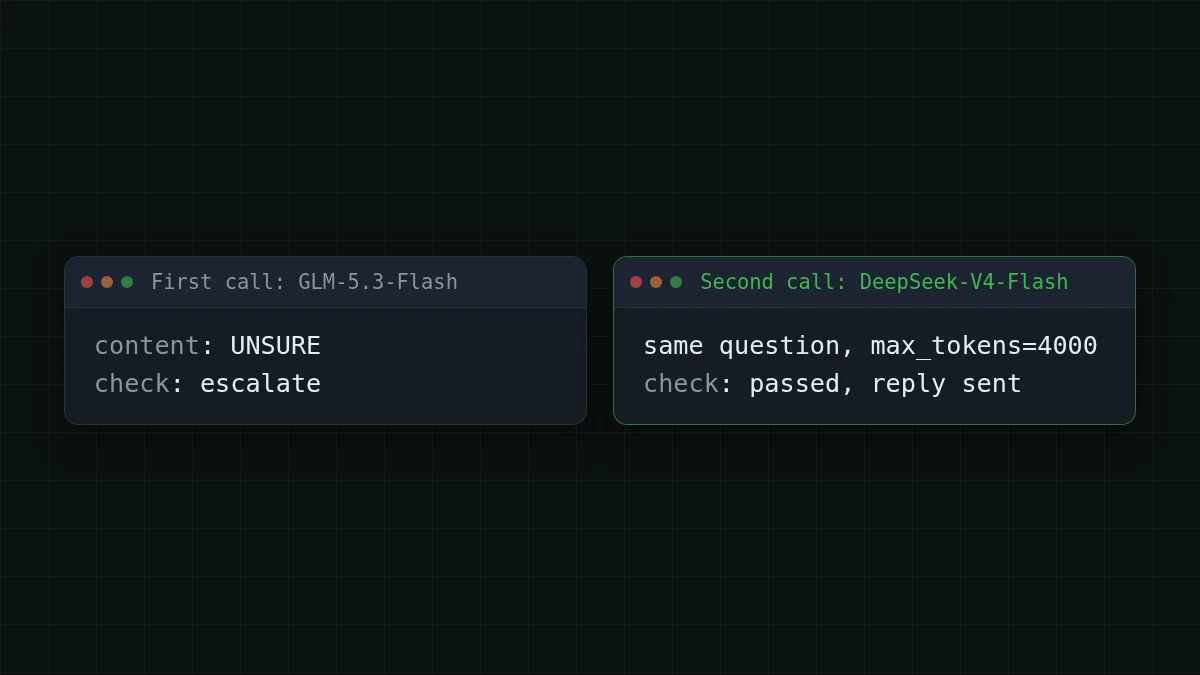
Większość zgłoszeń to krótkie FAQ: gdzie jest moje zamówienie, jak zresetować hasło. Kilka wymaga długiej, starannej odpowiedzi. Łatwe: pierwszy model odpowiada i nie odpowiada UNSURE. Trudne: mówi UNSURE lub odpowiedź jest ucięta (finish_reason to length).
Potok dokumentów
Każdy dokument najpierw przechodzi przez ekstrakcję. Łatwe: wynik parsuje się jako poprawny JSON ze wszystkimi wymaganymi polami. Trudne: parsowanie się nie udaje lub pole jest puste. Tylko te dokumenty są ponownie uruchamiane na drugim modelu.
Agent kodujący
Proste edycje trafiają do taniego modelu. Eskaluj krok, gdy ten sam krok zawiódł dwa razy z rzędu lub gdy odpowiedź została ucięta (finish_reason to length).
Nie eskaluj na podstawie "model brzmi niepewnie", chyba że powiedziałeś mu, jak to wyrazić. Jednolinijkowa instrukcja ("odpowiedz dokładnie UNSURE, jeśli nie możesz odpowiedzieć") zamienia wrażenie w coś, co if może odczytać.
Ile kosztuje 10 000 żądań: kaskada vs router#
Załóżmy, że prowadzisz bota wsparcia z 10 000 żądań miesięcznie. Przeciętne żądanie to 800 tokenów wejściowych i 300 tokenów wyjściowych. To założenia; podmień własne z usage (nasz artykuł o liczeniu tokenów pokazuje, gdzie je odczytać).
Istnieją dwa sposoby podłączenia routingu i rozliczają się inaczej:
- Kaskada. Każde żądanie trafia do taniego modelu. Udział p nie przechodzi sprawdzenia i jest wysyłany ponownie do drugiego modelu. Te żądania są płacone dwa razy: koszt = N × [tani + p × drugi].
- Router. Małe wywołanie klasyfikatora decyduje z góry. Łatwe trafiają do taniego modelu, trudne prosto do drugiego: koszt = N × [(1 − p) × tani + p × drugi], plus klasyfikator przy każdym żądaniu.
Użyjemy kaskady, ponieważ nie wymaga klasyfikatora i jest łatwiejsza na start. Pierwsze przejście to GLM-5.3-Flash (zai-, kontekst 390K, do 8 192 tokenów wyjściowych). Drugie przejście to DeepSeek-V4-Flash wydanie 0731 (deepseek-, kontekst 380K, do 32 768 tokenów wyjściowych), więc odpowiedź, która nie zmieściła się w 8 192 tokenach, ma miejsce, by się dokończyć. Oba są tańsze niż OpenRouter łącznie, z wejściem i wyjściem liczonym razem; tabela na żywo poniżej pokazuje kolumnę OpenRouter obok naszej.
Pierwsze przejście zawsze obejmuje wszystkie 10 000 żądań: 8 000 000 wejściowych i 3 000 000 wyjściowych tokenów. Drugie przejście obejmuje tylko eskalowany udział. Ostatnia kolumna to alternatywa: wszystkie 10 000 żądań prosto na drugim modelu.
Przewiń tabelę w prawo →
| Eskalowany udział | Tokeny drugiego przejścia (wej. / wyj.) | Pierwsze przejście, wszystkie 10 000 | Drugie przejście, tylko eskalowane | Wszystko na drugim modelu, wszystkie 10 000 |
|---|---|---|---|---|
| 10% | 800 000 / 300 000 | $0.28 | $0.042 | $0.42 |
| 30% | 2 400 000 / 900 000 | $0.28 | $0.126 | $0.42 |
| 50% | 4 000 000 / 1 500 000 | $0.28 | $0.21 | $0.42 |
Dodaj kolumny pierwszego i drugiego przejścia w każdym wierszu, aby otrzymać miesięczny koszt kaskady, a następnie porównaj tę sumę z ostatnią kolumną. Pierwsze przejście to stały koszt, a tylko drugie przejście rośnie wraz z p. To cała historia kaskady: im więcej eskalujesz, tym bliżej jesteś płacenia za pracę dwa razy.
Oto to samo obciążenie dla każdego modelu naraz, abyś zobaczył, gdzie lądują opcje z jednym modelem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 10 000 żądań | OpenRouter, 10 000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Kiedy kaskada się nie opłaca? Gdy pierwsze przejście plus eskalowany udział kosztuje więcej niż wysłanie wszystkiego do drugiego modelu. W symbolach: tani + p × drugi < drugi, co oznacza p < 1 − tani/drugi. Dla tej pary pierwsze przejście kosztuje zauważalny udział ceny drugiego modelu przy tym obciążeniu, więc zysk z kaskady maleje, a przy wysokim udziale eskalacji znika. Przy 50% kaskada może przegrać z prostym wysłaniem wszystkich 10 000 żądań do drugiego modelu, więc sprawdź sumę obu przejść względem ostatniej kolumny, zanim się zobowiążesz. Stosunek zależy od Twojej mieszanki wejścia/wyjścia, ponieważ oba modele wyceniają obie strony inaczej, więc odczytaj go z własnego wiersza.
Wariant routera dodaje jedną rzecz: klasyfikator. Załóżmy, że czyta 300 tokenów wejściowych i odpowiada w 5 tokenach na tanim modelu, na żądanie. Dla 10 000 żądań to 3 000 000 wejściowych i 50 000 wyjściowych tokenów, czyli $0.062 miesięcznie dodatkowo. Porównaj tę linię z udziałem p kolumny pierwszego przejścia (10%, 30% lub 50% jej): to, co kaskada marnuje, uruchamiając pierwsze przejście na żądaniach, które potem eskalują. Jeśli linia klasyfikatora jest większa, kaskada jest tańszym startem; jeśli mniejsza, router oszczędza więcej.
Wypróbuj własne liczby, zanim cokolwiek zbudujesz:
Kalkulator kosztów
Jeden miesiąc bota wsparcia, wszystko na jednym modelu
Tokeny wejściowe na żądanie: 800 · Tokeny wyjściowe na żądanie: 300 · Żądania dziennie: 10 000
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Zmień runs na swój wolumen i odczytaj sumę dla każdego modelu. Następnie użyj powyższej tabeli, aby zobaczyć, ile z tego dodałoby drugie przejście.
Router w Pythonie: dwa wywołania i jedno sprawdzenie#
Oba modele stoją za jednym bazowym URL zgodnym z OpenAI i jednym saldem, więc routing nie wymaga drugiego konta ani klucza. Poniższy kod to przykład: liczby w nim (max_tokens, reguła UNSURE) są do dostrojenia. Drugie wywołanie dostaje wyższy max_tokens, więc odpowiedź ucięta na 600 tokenach może się dokończyć. Bazowy URL, identyfikatory modeli i reszta są w dokumentacji CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text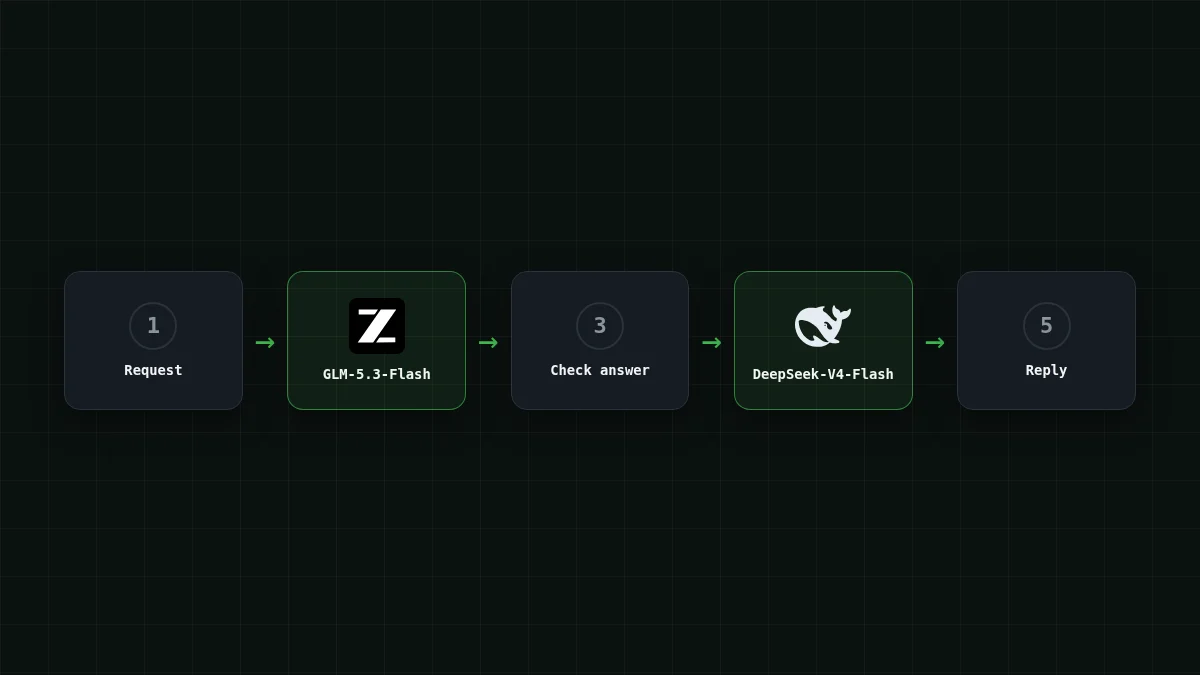
Trzy nawyki czynią to uczciwym, a nie tylko tanim:
- Licz eskalacje. Loguj, jak często uruchamia się
needs_escalation. To jest Twoje p i to liczba, która decyduje, czy kaskada się opłaca. - Wybierz drugi model na własnym zestawie testowym. Weź 50 trudnych żądań z logów, przepuść je przez oba modele i zachowaj drugi model tylko wtedy, gdy naprawia te, które pierwszy pominął. Jego udokumentowana przewaga to limit odpowiedzi 32 768 tokenów, a Twój własny zestaw pokazuje, czy to jest przewaga, której potrzebujesz.
- Wysyłaj to samo żądanie, nie dłuższe. Jeśli wkleisz nieudaną odpowiedź do drugiego wywołania, płacisz za nią jako wejście. Zacznij drugie przejście czysto, chyba że pierwsza odpowiedź jest naprawdę użytecznym kontekstem.
Sprawdź się#
Szybkie sprawdzenie
W kaskadzie 30% żądań nie przechodzi sprawdzenia na pierwszym modelu. Ile kosztują te żądania?
Pokaż odpowiedź
Odpowiedź: Cena pierwszego modelu plus cena drugiego modelu
Pierwsze wywołanie jest już rozliczone, gdy wyrzucasz jego odpowiedź. Eskalowane żądania płacą dwa razy, dlatego udział p decyduje o wszystkim.
Dokąd dalej#
Jeśli nie jesteś pewien, który model powinien wziąć pierwsze przejście, MiniMax-M2.7 vs DeepSeek-V4-Flash porównuje je według zadań. Aby zobaczyć widok na zadanie zamiast na token, zobacz cena za 1M tokenów vs koszt na zadanie, a dla pętli z wieloma krokami jak oszacować koszt agenta AI. Aktualne ceny dla każdego modelu są na stronie cen, a strony modeli to DeepSeek i GLM.


