Pierwsze krokiPrzewodnik
Pierwsze żądanie do CheapTokens w Pythonie z requests, bez SDK
20-linijkowy skrypt Pythona korzystający tylko z requests: jedno uzupełnienie czatu, limit czasu, obsługa błędów HTTP oraz wypisana odpowiedź, finish_reason i usage.
Na tej stronie
Nie potrzebujesz pakietu openai, aby rozmawiać z API zgodnym z OpenAI. Wystarczy jedno wywołanie requests.post, klucz Bearer i ciało JSON, a przy okazji zobaczysz dokładnie, co idzie po sieci. Ten przewodnik buduje taki skrypt dla CheapTokens (https:/) i kończy się wypisaniem odpowiedzi, finish_reason i zużycia tokenów.
To dobre rozwiązanie, jeśli pracujesz na zamkniętej maszynie, gdzie zainstalowany jest tylko requests, jeśli mały zadanie cron nie powinno ciągnąć SDK, albo jeśli po prostu chcesz zrozumieć, co SDK robi za Ciebie. Przewodnik po pierwszym żądaniu omawia SDK, curl i Node; ten dotyczy czystego Pythona.
Cały skrypt#
Najpierw umieść klucz w zmiennej środowiskowej (zobacz jak bezpiecznie przechowywać klucz API), a następnie zapisz to jako ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Uruchom python ask.py. Identyfikator modelu to pełny identyfikator bramy, deepseek-; jeśli nie wiesz, co tam wpisać, wylistuj modele za pomocą GET /v1/models. Aby wypróbować inny model, podmień zai- i nie zmieniaj niczego więcej: jedno saldo obejmuje wszystkie modele.
Co robi każda linia#
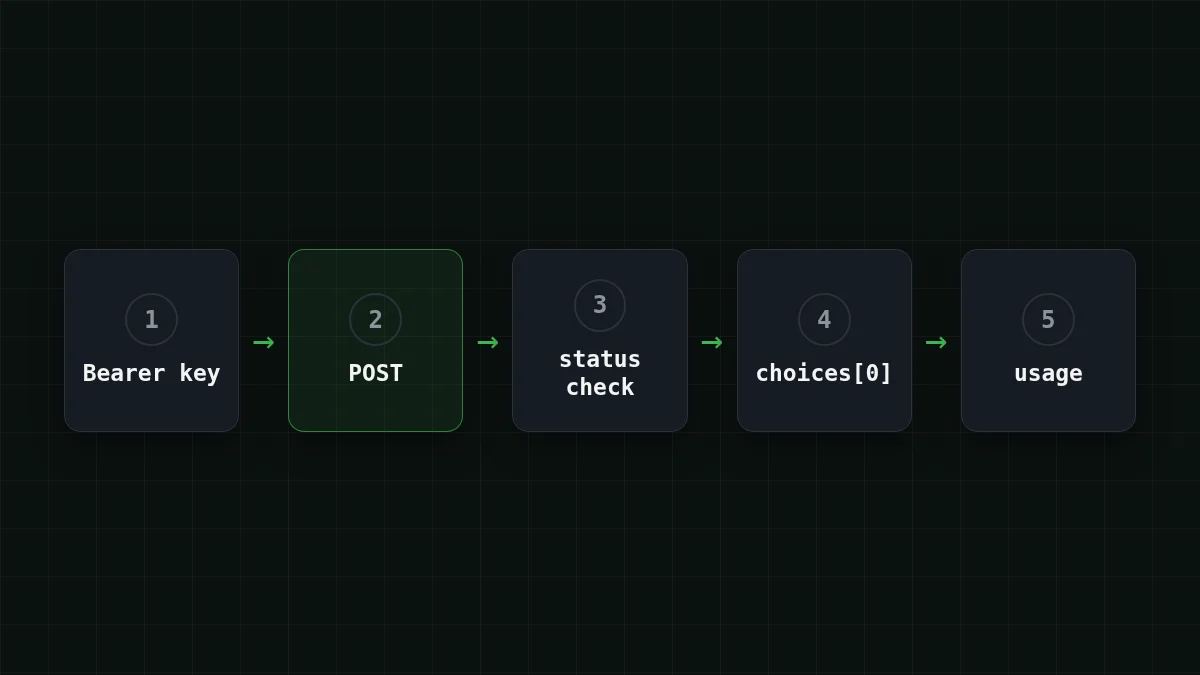
Oto pięć koncepcji, na których opiera się skrypt. Quickstart requests (żywa dokumentacja, sprawdzona 2 listopada 2026) wyjaśnia większość z nich, a dokumentacja Chat Completions od OpenAI definiuje pola w odpowiedzi.
Fiszki
Pięć rzeczy w skrypcie
Dotknij kartę, aby ją odwrócić
Trzeci punkt to ten, który ludzie pomijają. Skrypt, który wisi w nieskończoność w zadaniu cron, jest znacznie gorszy niż taki, który głośno zawodzi po 30 sekundach.
Odczytaj odpowiedź#
Udana odpowiedź to JSON. Części, które Cię interesują, zgodnie z dokumentacją Chat Completions:
choices[0].to tekst. Może byćmessage. content null, więc nie wywołuj na nim metod tekstowych bez zastanowienia.choices[0].mówi, dlaczego model się zatrzymał:finish_ reason stop(skończył),length(limitmax_tokensgo uciął),tool_calls,content_filter.usage.,prompt_ tokens usage.icompletion_ tokens usage.to to, za co płacisz: wejście, wyjście i ich suma.total_ tokens
Odpowiedź ma taki kształt (liczby są przykładowe):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Spróbuj samWypróbuj: ustaw max_tokens na 5 i uruchom skrypt ponownie. Co mówi finish_reason?Pokaż odpowiedź
Mówi length: model został zatrzymany przez Twój limit max_tokens, więc odpowiedź kończy się w połowie zdania. Podnieś limit, a znowu dostaniesz stop. Pełna historia jest w Odpowiedź AI ucięta? Napraw finish_reason "length".
Kiedy nie działa#
Skrypt zamienia większość błędów w jedną linię wyjścia. Oto co zwykle oznacza każda z nich:
Dopasuj pary
Dopasuj każdy komunikat do jego zwykłej przyczyny
Dotknij element po lewej, a następnie jego parę
- HTTP 401Klucz jest brakujący, błędnie wpisany lub nie ten, który chciałeś wysłać
- HTTP 404Ścieżka URL lub identyfikator modelu jest błędny
- requests.exceptions.TimeoutŻadne bajty nie dotarły w ramach limitu czasu
- KeyError: 'CHEAPTOKENS_API_KEY'Zmienna środowiskowa nie jest ustawiona w tym terminalu
Aby zobaczyć rzeczywiste ciała błędów i krok po kroku sprawdzić klucz, bazowy URL i identyfikator modelu, skorzystaj z Błąd API 401 lub 404: zły klucz, bazowy URL lub identyfikator modelu. Dwie mniejsze pułapki: jeśli widzisz KeyError: 'choices', sparsowałeś ciało błędu jako sukces, co oznacza, że raise_ zostało pominięte. A jeśli Twoja maszyna ma plik ~/.netrc, requests może użyć jego poświadczeń zamiast ustawionego przez Ciebie nagłówka Authorization.
Ile kosztuje jedno wywołanie#
Przy przykładowych liczbach z powyższej odpowiedzi (około 18 tokenów wejścia, 52 wyjścia) jedno wywołanie DeepSeek-V4-Flash kosztuje $0.0000055. To liczba, której nie poczujesz, więc przeskaluj ją. Powiedzmy, że Twój skrypt podsumowuje 1000 zgłoszeń do supportu dziennie, mniej więcej 800 tokenów wejścia i 300 wyjścia każde:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Ceny są stałe dla modelu, bez godzin szczytu, więc ten sam skrypt kosztuje tyle samo o 3 w nocy i w południe. Aktualne ceny dla poszczególnych modeli są na stronie cennika, a dokumentacja wymienia endpointy.
Dokąd dalej#
Gdy to działa, zwykłe kolejne kroki to pętla po wielu wejściach, ponowna próba przy 429 (zobacz 429 Too Many Requests: ponowne próby z backoffem) albo to samo wywołanie ze streamingiem. Jeśli wolisz nie zarządzać HTTP samodzielnie, droga przez SDK to jedna zmiana base_url.


