Per iniziareGuida
Prima richiesta a CheapTokens in Python con requests, senza SDK
Uno script Python di 20 righe con solo requests: un chat completion, un timeout, gestione degli errori HTTP e la stampa di risposta, finish_reason e usage.
In questa pagina
Non hai bisogno del pacchetto openai per parlare con un'API compatibile con OpenAI. Una chiamata requests.post, una chiave Bearer e un corpo JSON sono sufficienti, e vedi esattamente cosa passa sulla rete. Questa guida costruisce quello script per CheapTokens (https:/) e termina con la stampa della risposta, finish_reason e dell'utilizzo dei token.
È adatto se sei su una macchina bloccata dove è installato solo requests, se un piccolo cron job non dovrebbe tirare dentro un SDK, o se vuoi semplicemente capire cosa fa l'SDK per te. La guida alla prima richiesta copre le vie SDK, curl e Node; questa è quella in puro Python.
Lo script completo#
Metti prima la tua chiave in una variabile d'ambiente (vedi come memorizzare in sicurezza una chiave API), poi salva questo come ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Esegui python ask.py. L'id del modello è l'id completo del gateway, deepseek-; se non sei sicuro di cosa mettere, elenca i modelli con GET /v1/models. Per provare un altro modello, sostituisci con zai- e non cambiare altro: un saldo copre tutti i modelli.
Cosa fa ogni riga#
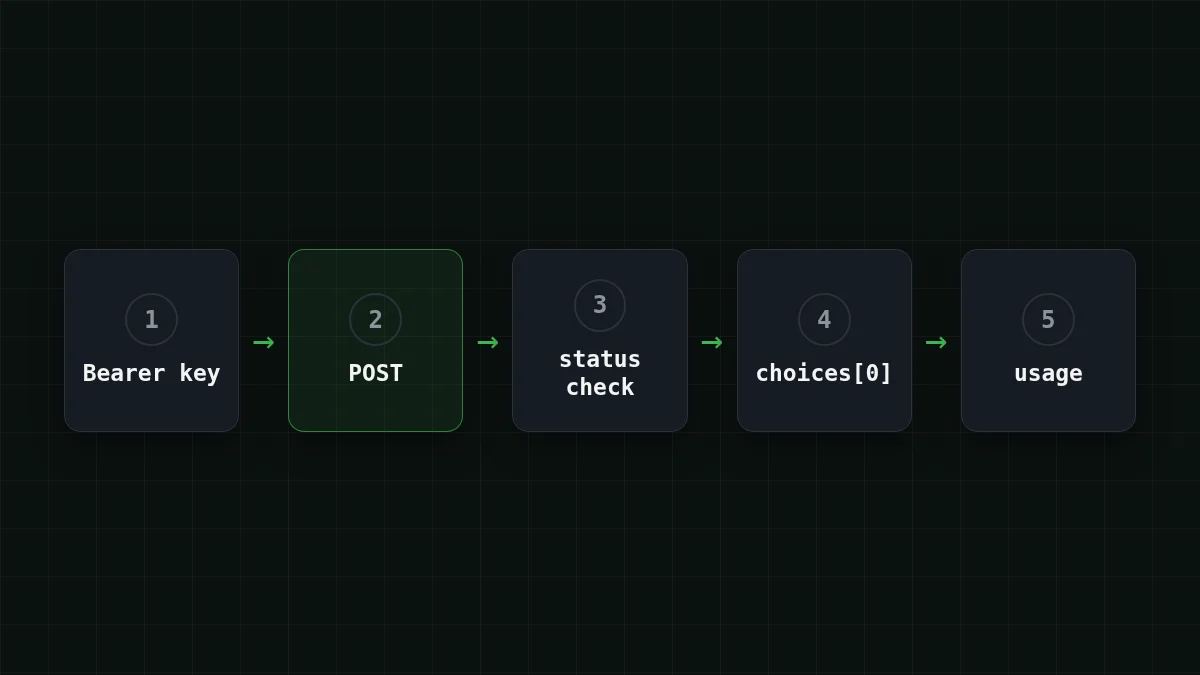
Ecco le cinque idee su cui si basa lo script. Il Quickstart di requests (documentazione viva, verificata il 2 novembre 2026) spiega la maggior parte di esse, e il riferimento Chat Completions di OpenAI definisce i campi della risposta.
Flashcard
Cinque cose nello script
Tocca una carta per girarla
Il terzo punto è quello che la gente salta. Uno script che si blocca per sempre in un cron job è molto peggio di uno che fallisce rumorosamente dopo 30 secondi.
Leggere la risposta#
Una risposta riuscita è JSON. Le parti che ti interessano, secondo il riferimento Chat Completions:
choices[0].è il testo. Può esseremessage. content null, quindi non chiamare metodi di stringa su di esso alla cieca.choices[0].dice perché il modello si è fermato:finish_ reason stop(ha finito),length(il limitemax_tokensl'ha interrotto),tool_calls,content_filter.usage.,prompt_ tokens usage.ecompletion_ tokens usage.sono ciò per cui paghi: input, output e la loro somma.total_ tokens
La risposta ha questa forma (i numeri sono segnaposto):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Provalo tu stessoProvalo: imposta max_tokens a 5 ed esegui di nuovo lo script. Cosa dice finish_reason?Mostra risposta
Dice length: il modello è stato fermato dal tuo limite max_tokens, quindi la risposta finisce a metà frase. Alza il limite e ottieni di nuovo stop. La storia completa è in Risposta AI troncata? Correggi finish_reason "length".
Quando non funziona#
Lo script trasforma la maggior parte dei fallimenti in una riga di output. Ecco cosa significa di solito ciascuno:
Abbina le coppie
Abbina ogni messaggio alla sua causa abituale
Tocca un elemento a sinistra, poi il suo abbinamento
- HTTP 401La chiave manca, è scritta male o non è quella che volevi inviare
- HTTP 404Il percorso URL o l'id del modello è sbagliato
- requests.exceptions.TimeoutNessun byte è arrivato entro il timeout
- KeyError: 'CHEAPTOKENS_API_KEY'La variabile d'ambiente non è impostata in questo terminale
Per i corpi di errore effettivi e un controllo passo passo di chiave, URL di base e id del modello, usa Errore API 401 o 404: chiave, URL di base o id del modello sbagliati. Due insidie minori: se vedi KeyError: 'choices', hai analizzato un corpo di errore come successo, il che significa che raise_ è stato saltato. E se la tua macchina ha un file ~/.netrc, requests può usare le sue credenziali invece dell'header Authorization che hai impostato.
Quanto costa una chiamata#
Con i numeri segnaposto della risposta sopra (circa 18 token in, 52 out), una chiamata a DeepSeek-V4-Flash costa $0.0000055. È un numero che non riesci a percepire, quindi ingrandiscilo. Diciamo che il tuo script riassume 1.000 ticket di supporto al giorno, circa 800 token in e 300 out ciascuno:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
I prezzi sono fissi per modello, senza ore di punta, quindi lo stesso script costa lo stesso alle 3 di notte e a mezzogiorno. I prezzi attuali per modello sono sulla pagina dei prezzi, e la documentazione elenca gli endpoint.
Da dove andare da qui#
Una volta che funziona, i prossimi passi abituali sono un ciclo su molti input, un retry su 429 (vedi 429 Too Many Requests: retry con backoff), o la stessa chiamata con lo streaming. Se preferisci non gestire HTTP da solo, la via SDK è a un cambio di base_url di distanza.


