Stima il costo API di un torneo di modelli prima di eseguirlo
Conta i token per seggio, moltiplica per partite e inversioni di ruolo, e imposta un limite rigido in Python: una stima svolta per un torneo di modelli a 6 seggi e 60 partite.
In questa pagina
Puoi conoscere il conto di un torneo di modelli prima della prima richiesta: conta i token che un seggio invia nell'arco di un'intera partita, moltiplica per seggi e partite, e metti un limite rigido nel codice. La parte che le persone trascurano è la cronologia. Ogni turno rinvia tutto ciò che è stato detto finora, quindi l'input cresce molto più velocemente del numero di turni.
Cosa ti dice e cosa non ti dice un titolo da $20.000#
Il 5 novembre 2026 il podcaster Dwarkesh Patel ha pubblicato Clocktower Bench, un benchmark in cui i modelli giocano l'uno contro l'altro al gioco di deduzione sociale Blood on the Clocktower. Dice di aver speso circa $20.000 di crediti API per costruire l'harness, e che gran parte è andata all'iterazione sul design dell'ambiente, più dei token che aveva previsto.
Il README del progetto (verificato l'8 novembre 2026) descrive la configurazione: 11 modelli, 386 partite per la classifica principale, un modello che gioca ogni seggio buono e un altro ogni seggio malvagio, 10–12 giocatori, partite che durano diverse ore. Ogni mano viene rigiocata con i ruoli invertiti, così nessuno dei due modelli ottiene il ruolo più facile. Include anche una dry run gratuita (--model random), scrive la spesa su games/ e ha un limite --budget che per impostazione predefinita è $1.000.
Ciò che non fornisce sono i token per partita. Quindi non c'è nulla da copiare; la stima te la costruisci da solo. È quello che fa il resto di questo articolo, con assunzioni dichiarate che puoi sostituire con le tue.
Un seggio: perché l'input continua a crescere#
Supponi di gestire una partita più piccola: 6 seggi, ogni seggio è un modello con la propria conversazione, 20 turni per seggio. Ipotizza un system prompt da 2.000 token (regole e ruolo del seggio), 600 nuovi token di conversazione al tavolo che arrivano prima di ogni turno e una risposta da 300 token. L'API non ha memoria, quindi ogni richiesta porta di nuovo l'intera conversazione (perché una chat lunga costa di più).
Il turno 1 invia 2.000 + 600 = 2.600 token. Il turno 20 invia 2.000 + 600 × 20 + 300 × 19 = 19.700. Prova tu stesso l'ultimo numero:
Indovina il numero
Quanti token di input invia un seggio al suo 20° turno?
La tua risposta
040.000
Mostra risposta
Risposta: 19.700
19.700: il system prompt da 2.000 token, 20 × 600 di nuova conversazione e 19 risposte precedenti da 300 ciascuna. Ogni vecchia risposta e ogni vecchio messaggio vengono reinviati.
Somma tutti i 20 turni per un seggio: 2.000 × 20 + 600 × 210 + 300 × 190 = 40.000 + 126.000 + 57.000 = 223.000 token di input. L'output è solo 20 × 300 = 6.000. Se contassi ogni messaggio una volta sola, otterresti 2.000 + 20 × 600 = 14.000 e sbaglieresti di un fattore sedici.
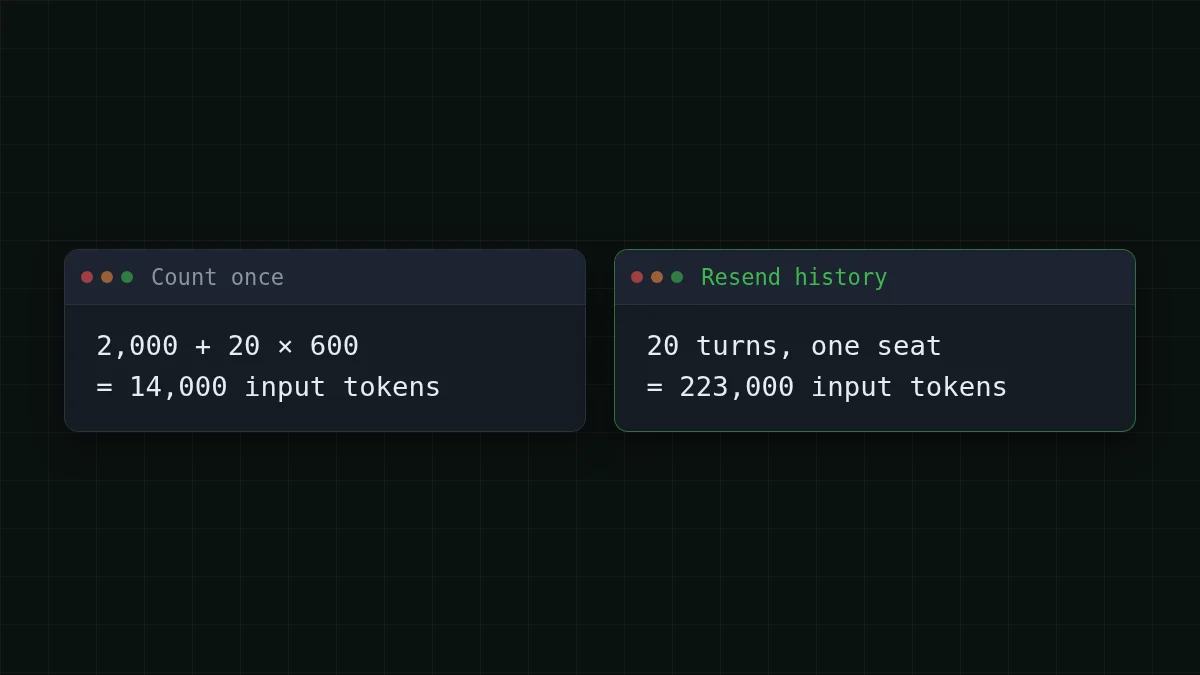
Il lato output si muove appena. È l'input dove vanno i soldi, ed è il lato che peggiora man mano che le partite si allungano.
Da un seggio a un intero torneo#
Ora scalalo con tre moltiplicatori.
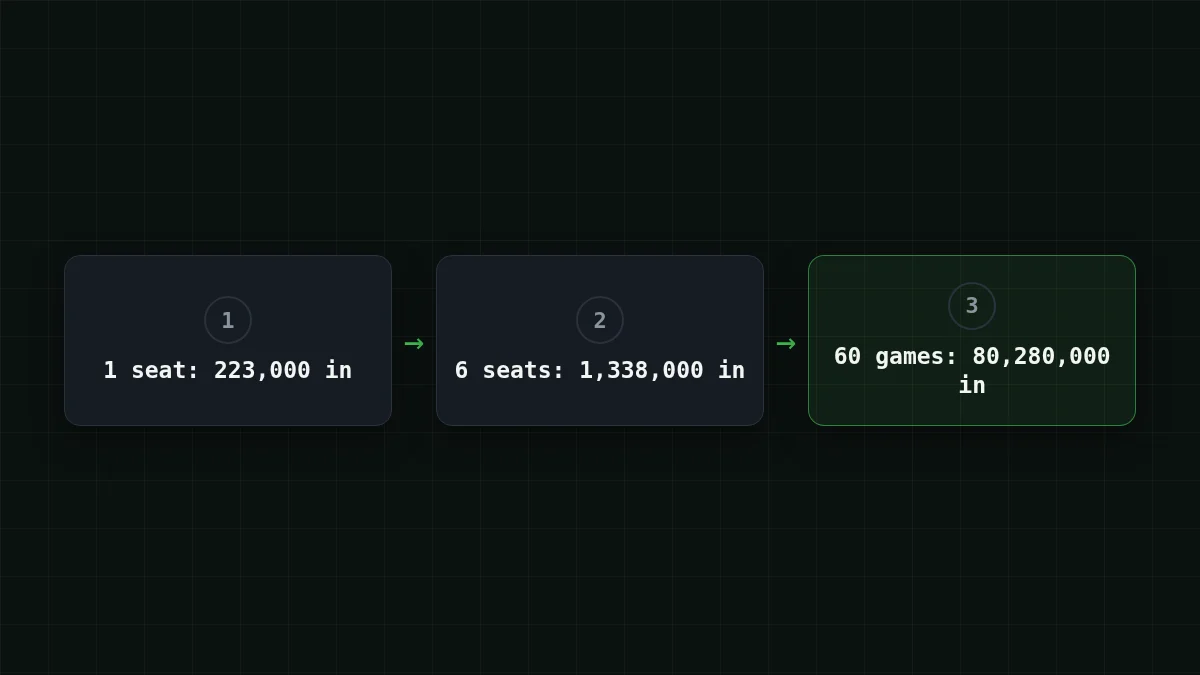
- Seggi. 6 seggi × 223.000 = 1.338.000 token di input e 6 × 6.000 = 36.000 token di output per partita.
- Inversione dei ruoli. Prendi 3 modelli in un girone all'italiana: 3 accoppiamenti. Gioca 10 mani per accoppiamento, ciascuna due volte con i ruoli invertiti: 3 × 10 × 2 = 60 partite.
- Partite. 60 × 1.338.000 = 80.280.000 di input e 60 × 36.000 = 2.160.000 token di output per il torneo.
Una partita su DeepSeek-V4-Flash arriva a $0.0237. La tabella sotto prezza l'intero torneo da 60 partite come se quel singolo modello giocasse ogni seggio, così puoi confrontare i tre modelli che CheapTokens offre per questo tipo di lavoro a conversazione lunga. In totale, contando input e output insieme, ciascuno di essi è più economico del riferimento OpenRouter nell'ultima colonna.
| Modello | Input $/1M | Output $/1M | Per richiesta | 60 richieste | OpenRouter, 60 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 token di input e 36.000 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
A livello di budget è tutto qui il trucco: non ti serve una voce da $20.000 per scoprire quale di tre modelli gioca meglio a un gioco di negoziazione. Ti serve la stima qui sopra, e poi un vero pilota per verificarla.
Verifica rapida
La tua partita a 6 seggi passa da 20 a 40 turni per seggio. Cosa succede al conto dell'input?
Mostra risposta
Risposta: Cresce di circa 3,6 volte
Per 40 turni la stessa formula dà 2.000 × 40 + 600 × 820 + 300 × 780 = 806.000 token di input, contro 223.000 per 20 turni. Il termine della cronologia cresce con il quadrato del numero di turni.
Due verifiche prima di fidarti di un numero del genere. Primo, la richiesta più grande deve stare nella finestra del modello. A 20 turni la richiesta più grande è 19.700 token, nessun problema. Una partita di più ore con 200 turni per seggio arriva a 2.000 + 600 × 200 + 300 × 199 = 181.700, circa 182K, quindi leggi la dimensione del contesto nella pagina del modello prima di progettare la partita. DeepSeek-V4-Flash ha una finestra da 380K e fino a 32.768 token di output; vedi la pagina del modello. Secondo, se un modello emette ragionamenti lunghi, i tuoi 300 token di output diventano di più (token di ragionamento in un job in blocco).
Metti un limite rigido nel codice#
Il flag --budget del README è l'idea giusta, e servono dieci righe per copiarlo nel tuo harness. Lo script sotto stima prima di eseguire, rifiuta di inviare una richiesta che potrebbe portare il totale oltre il limite e registra ogni chiamata in un file di registro. I prezzi al suo interno sono un esempio: sostituiscili con quelli attuali da la tabella dei prezzi.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) stampa (1338000, 36000), gli stessi numeri per partita di sopra, così il codice e l'aritmetica si verificano a vicenda. usage. e usage. provengono dalla risposta e sono ciò per cui vieni fatturato; il pre-controllo usa un conteggio pessimistico dei caratteri perché il conteggio reale si conosce solo dopo la chiamata. Maggiori dettagli sui registri per progetto in tracciare il costo in token degli agenti in Python.
Un ordine sicuro per la prima esecuzione#
La sequenza del repository stesso è un buon modello: prima gratis, poi economico, infine costoso. Metti questi passaggi in ordine:
Metti in ordine
Metti in ordine i passaggi di una prima esecuzione sicura
Trascina gli elementi o usa le frecce
- Dry run con un giocatore casuale, nessuna chiamata API
- Esegui
estimate()e confrontalo con il tuo limite - Gioca una partita reale e leggi il registro
- Correggi le assunzioni con i conteggi reali dei token
- Lancia il torneo completo con il limite attivo
Il README dice che una partita demo su modelli economici costa circa $2–5. È un'affermazione dell'autore e i modelli non sono nominati, quindi trattala come un intervallo di sanità, non come un preventivo per la tua configurazione. La tua partita pilota dà il numero che conta: se il suo registro mostra 1.500.000 token di input dove avevi assunto 1.338.000, hai imparato qualcosa per pochi centesimi invece che alla partita 40.
Per esperimenti più lunghi, le leve abituali sono in ridurre la cronologia della chat: taglia ciò che ogni seggio deve rileggere, e il termine quadratico si riduce di conseguenza. Quando sei pronto a eseguirlo, la documentazione ha l'endpoint e gli id dei modelli.


