KostenoptimierungAnleitung
Schätzen Sie die API-Kosten eines Modellturniers, bevor Sie es starten
Zählen Sie Tokens pro Sitz, multiplizieren Sie mit Spielen und Seitentausch und setzen Sie ein hartes Limit in Python: eine durchgerechnete Schätzung für ein Modellturnier mit 6 Sitzen und 60 Spielen.
Auf dieser Seite
Sie können die Rechnung eines Modellturniers kennen, bevor die erste Anfrage rausgeht: Zählen Sie die Tokens, die ein Sitz über ein ganzes Spiel sendet, multiplizieren Sie mit Sitzen und Spielen und setzen Sie ein hartes Limit in den Code. Was dabei oft übersehen wird, ist die Historie. Jede Runde sendet alles bisher Gesagte erneut, sodass der Input viel schneller wächst als die Zahl der Runden.
Was eine Schlagzeile von 20.000 $ verrät und was nicht#
Am 5. November 2026 veröffentlichte der Podcaster Dwarkesh Patel Clocktower Bench, einen Benchmark, bei dem Modelle das Social-Deduction-Spiel Blood on the Clocktower gegeneinander spielen. Er sagt, er habe etwa 20.000 $ an API-Guthaben für den Aufbau der Testumgebung ausgegeben, und ein großer Teil davon sei in die Iteration am Umgebungsdesign geflossen, mehr als die Tokens, die er geplant hatte.
Die README des Projekts (geprüft am 8. November 2026) beschreibt den Aufbau: 11 Modelle, 386 Spiele für das Schlagzeilen-Ranking, ein Modell spielt jeden guten Sitz und ein anderes jeden bösen Sitz, 10–12 Spieler, Spiele, die mehrere Stunden dauern. Jede Runde wird mit getauschten Seiten wiederholt, damit kein Modell die leichtere Rolle bekommt. Außerdem gibt es einen kostenlosen Probelauf (--model random), schreibt die Ausgaben nach games/ und hat ein --budget-Limit, das standardmäßig bei 1.000 $ liegt.
Was es nicht liefert, sind Tokens pro Spiel. Es gibt also nichts zum Kopieren; Sie bauen die Schätzung selbst. Das macht der Rest dieses Artikels, mit genannten Annahmen, die Sie durch Ihre eigenen ersetzen können.
Ein Sitz: warum der Input immer weiter wächst#
Nehmen wir an, Sie veranstalten ein kleineres Spiel: 6 Sitze, jeder Sitz ist ein Modell mit eigener Konversation, 20 Runden pro Sitz. Gehen Sie von einem System-Prompt mit 2.000 Tokens aus (Regeln und die Rolle des Sitzes), 600 neuen Tokens Tischgespräch, die vor jeder Runde eintreffen, und einer Antwort mit 300 Tokens. Die API hat kein Gedächtnis, also trägt jede Anfrage die gesamte Konversation erneut mit sich (warum ein langer Chat mehr kostet).
Runde 1 sendet 2.000 + 600 = 2.600 Tokens. Runde 20 sendet 2.000 + 600 × 20 + 300 × 19 = 19.700. Probieren Sie die letzte Zahl selbst aus:
Zahl erraten
Wie viele Input-Tokens sendet ein Sitz in seiner 20. Runde?
Deine Schätzung
040.000
Antwort anzeigen
Antwort: 19.700
19.700: der System-Prompt mit 2.000 Tokens, 20 × 600 neues Gerede und 19 frühere Antworten mit je 300. Jede alte Antwort und jede alte Nachricht geht wieder mit rein.
Summieren Sie alle 20 Runden für einen Sitz: 2.000 × 20 + 600 × 210 + 300 × 190 = 40.000 + 126.000 + 57.000 = 223.000 Input-Tokens. Der Output beträgt nur 20 × 300 = 6.000. Wenn Sie jede Nachricht einmal zählen würden, kämen Sie auf 2.000 + 20 × 600 = 14.000 und lägen um den Faktor sechzehn daneben.
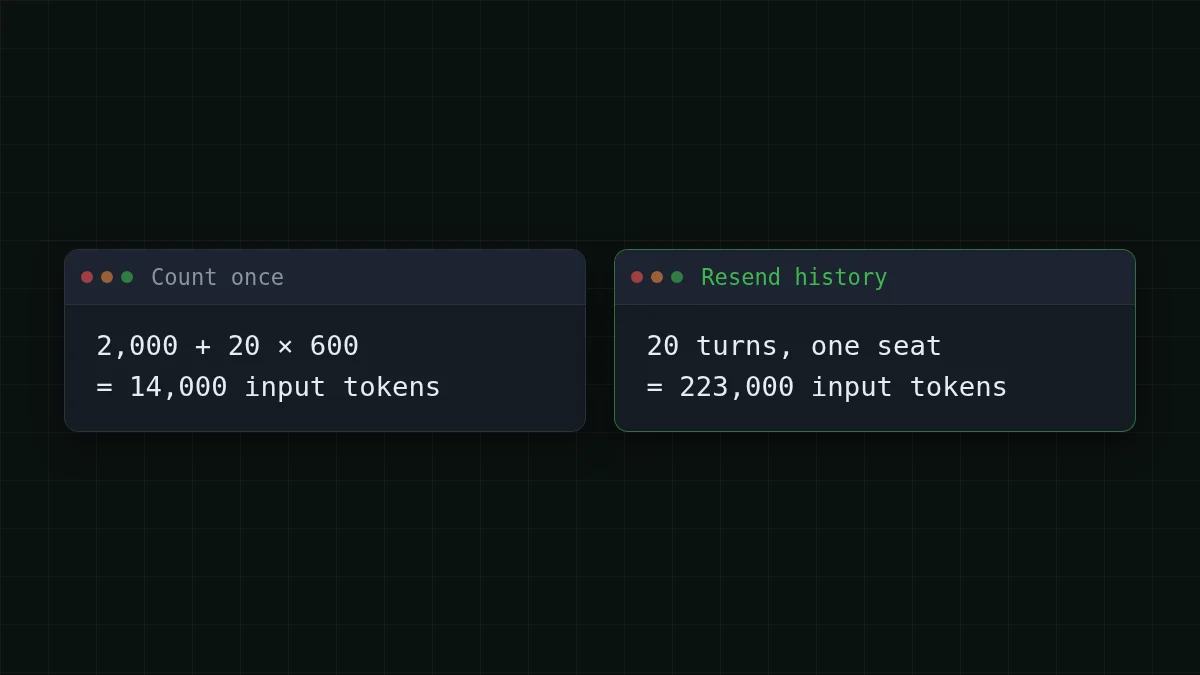
Die Output-Seite bewegt sich kaum. Der Input ist, wo das Geld hingeht, und das ist die Seite, die bei längeren Spielen schlechter wird.
Von einem Sitz zum ganzen Turnier#
Skalieren Sie es nun mit drei Multiplikatoren.
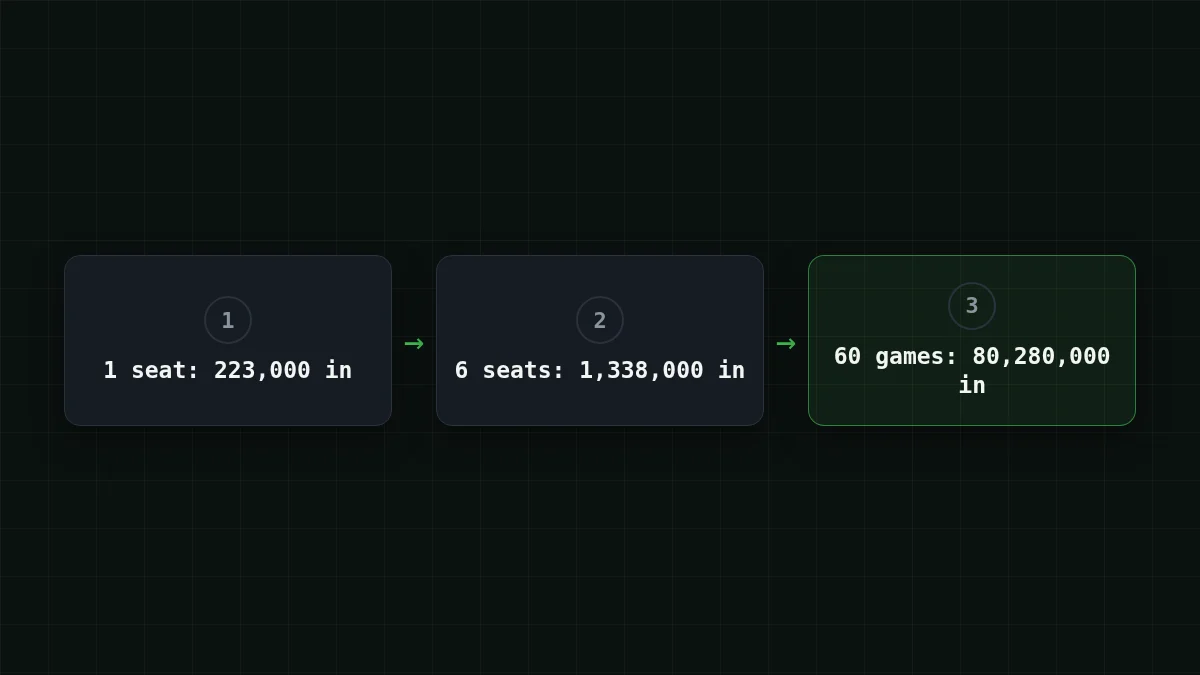
- Sitze. 6 Sitze × 223.000 = 1.338.000 Input-Tokens und 6 × 6.000 = 36.000 Output-Tokens pro Spiel.
- Seitentausch. Nehmen Sie 3 Modelle im Round Robin: 3 Paarungen. Spielen Sie 10 Runden pro Paarung, jede zweimal mit getauschten Seiten: 3 × 10 × 2 = 60 Spiele.
- Spiele. 60 × 1.338.000 = 80.280.000 Input- und 60 × 36.000 = 2.160.000 Output-Tokens für das Turnier.
Ein Spiel auf DeepSeek-V4-Flash kommt auf $0.0237. Die folgende Tabelle bepreist das gesamte 60-Spiele-Turnier, als ob dieses eine Modell jeden Sitz spielen würde, damit Sie die drei Modelle vergleichen können, die CheapTokens für diese Art von Langkonversations-Aufgabe anbietet. Insgesamt, mit Input und Output zusammengerechnet, ist jedes von ihnen günstiger als die OpenRouter-Referenz in der letzten Spalte.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 60 Anfragen | OpenRouter, 60 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1.338.000 Input- und 36.000 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Budgetmäßig ist das der ganze Trick: Sie brauchen keinen Posten von 20.000 $, um herauszufinden, welches von drei Modellen ein Verhandlungsspiel besser spielt. Sie brauchen die obige Schätzung und dann einen echten Piloten, um sie zu prüfen.
Kurzer Check
Ihr 6-Sitze-Spiel geht von 20 auf 40 Runden pro Sitz. Was passiert mit der Input-Rechnung?
Antwort anzeigen
Antwort: Sie wächst um etwa das 3,6-Fache
Für 40 Runden ergibt dieselbe Formel 2.000 × 40 + 600 × 820 + 300 × 780 = 806.000 Input-Tokens, gegenüber 223.000 für 20 Runden. Der Historien-Term wächst mit dem Quadrat der Rundenzahl.
Zwei Prüfungen, bevor Sie einer solchen Zahl trauen. Erstens muss die größte Anfrage in das Fenster des Modells passen. Bei 20 Runden ist die größte Anfrage 19.700 Tokens, kein Problem. Ein mehrstündiges Spiel mit 200 Runden pro Sitz erreicht 2.000 + 600 × 200 + 300 × 199 = 181.700, etwa 182K, also lesen Sie die Kontextgröße auf der Modellseite, bevor Sie das Spiel entwerfen. DeepSeek-V4-Flash hat ein 380K-Fenster und bis zu 32.768 Output-Tokens; siehe die Modellseite. Zweitens: Wenn ein Modell lange Begründungen ausgibt, werden aus Ihren 300 Output-Tokens mehr (Thinking-Tokens in einem Bulk-Job).
Setzen Sie ein hartes Limit in den Code#
Das --budget-Flag aus der README ist die richtige Idee, und es braucht zehn Zeilen, um es in Ihre eigene Testumgebung zu übernehmen. Das folgende Skript schätzt vor dem Lauf, verweigert das Senden einer Anfrage, die die Summe über das Limit treiben könnte, und protokolliert jeden Aufruf in einer Ledger-Datei. Die darin enthaltenen Preise sind ein Beispiel: Ersetzen Sie sie durch die aktuellen aus der Preistabelle.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) gibt (1338000, 36000) aus, dieselben Zahlen pro Spiel wie oben, sodass Code und Arithmetik sich gegenseitig prüfen. usage. und usage. stammen aus der Antwort und sind das, wofür Sie abgerechnet werden; die Vorabprüfung verwendet eine pessimistische Zeichenzählung, weil die echte Zahl erst nach dem Aufruf bekannt ist. Mehr zu Ledgers pro Projekt in Tracking der Token-Kosten von Agenten in Python.
Eine sichere Reihenfolge für den ersten Lauf#
Die eigene Reihenfolge des Repos ist ein gutes Vorbild: erst kostenlos, dann günstig, zuletzt teuer. Bringen Sie diese Schritte in die richtige Reihenfolge:
In die richtige Reihenfolge bringen
Bringen Sie die Schritte eines sicheren ersten Laufs in die richtige Reihenfolge
Ziehe die Elemente oder benutze die Pfeile
- Probelauf mit einem zufälligen Spieler, keine API-Aufrufe
estimate()ausführen und mit Ihrem Limit vergleichen- Ein echtes Spiel spielen und das Ledger lesen
- Die Annahmen mit den echten Token-Zahlen korrigieren
- Das volle Turnier mit aktivem Limit starten
Die README sagt, ein Demo-Spiel auf günstigen Modellen kostet etwa 2–5 $. Das ist die Aussage des Autors, und die Modelle werden nicht genannt, also behandeln Sie es als Plausibilitätsbereich, nicht als Angebot für Ihr Setup. Ihr eigenes Pilotspiel liefert die Zahl, auf die es ankommt: Wenn sein Ledger 1.500.000 Input-Tokens zeigt, wo Sie 1.338.000 angenommen haben, haben Sie etwas für ein paar Cent gelernt statt bei Spiel 40.
Für längere Experimente finden Sie die üblichen Hebel in Kürzen der Chat-Historie: Schneiden Sie weg, was jeder Sitz erneut lesen muss, und der quadratische Term schrumpft mit. Wenn Sie bereit sind, es laufen zu lassen, finden Sie in der Dokumentation den Endpoint und die Modell-IDs.


