খরচ অপ্টিমাইজেশনগাইড
চালানোর আগেই একটি মডেল টুর্নামেন্টের API খরচ অনুমান করুন
প্রতি সিটে টোকেন গুনুন, খেলা ও পক্ষ বদল দিয়ে গুণ করুন, এবং Python-এ একটি কঠোর সীমা বসান: ৬-সিট, ৬০-খেলার মডেল টুর্নামেন্টের একটি কার্যপ্রণালীভিত্তিক অনুমান।
এই পৃষ্ঠায়
প্রথম অনুরোধের আগেই একটি মডেল টুর্নামেন্টের বিল জানা যায়: একটি সিট পুরো খেলায় কত টোকেন পাঠায় তা গুনুন, সিট ও খেলার সংখ্যা দিয়ে গুণ করুন, এবং কোডে একটি কঠোর সীমা বসান। মানুষ যে অংশটি মিস করে তা হলো হিস্ট্রি। প্রতিটি টার্নে এখন পর্যন্ত বলা সবকিছু আবার পাঠানো হয়, তাই ইনপুট টার্নের সংখ্যার চেয়ে অনেক দ্রুত বাড়ে।
$20,000 শিরোনাম কী বলে আর কী বলে না#
৫ নভেম্বর ২০২৬-এ পডকাস্টার Dwarkesh Patel Clocktower Bench প্রকাশ করেন, একটি বেঞ্চমার্ক যেখানে মডেলগুলো একে অপরের বিরুদ্ধে সোশ্যাল-ডিডাকশন গেম Blood on the Clocktower খেলে। তিনি বলেন হার্নেস তৈরিতে তিনি প্রায় $20,000 API ক্রেডিট খরচ করেছেন, এবং এর অনেকটাই পরিবেশ ডিজাইন পুনরাবৃত্তিতে গেছে, পরিকল্পিত টোকেনের চেয়ে বেশি।
প্রকল্পের README (৮ নভেম্বর ২০২৬-এ যাচাইকৃত) সেটআপ বর্ণনা করে: ১১টি মডেল, শিরোনাম র্যাংকিংয়ের জন্য ৩৮৬টি খেলা, একটি মডেল প্রতিটি ভালো সিটে এবং অন্যটি প্রতিটি খারাপ সিটে খেলে, ১০–১২ জন খেলোয়াড়, কয়েক ঘণ্টা স্থায়ী খেলা। প্রতিটি ডিল পক্ষ বদলে পুনরায় খেলা হয়, যাতে কোনো মডেল সহজ ভূমিকা না পায়। এতে একটি বিনামূল্যে ড্রাই রান (--model random) রয়েছে, খরচ games/-এ লেখে, এবং একটি --budget সীমা আছে যা ডিফল্ট $1,000।
যা দেয় না তা হলো প্রতি খেলায় টোকেন। তাই কপি করার কিছু নেই; আপনি নিজেই অনুমান তৈরি করেন। এই নিবন্ধের বাকি অংশ তা-ই করে, স্পষ্ট অনুমানসহ যা আপনি নিজের দিয়ে বদলাতে পারেন।
একটি সিট: ইনপুট কেন বাড়তেই থাকে#
ধরুন আপনি একটি ছোট খেলা চালান: ৬টি সিট, প্রতিটি সিট একটি মডেল যার নিজস্ব কথোপকথন, প্রতি সিটে ২০ টার্ন। ধরে নিন ২,০০০-টোকেন সিস্টেম প্রম্পট (নিয়ম ও সিটের ভূমিকা), প্রতিটি টার্নের আগে ৬০০ নতুন টোকেন টেবিল টক আসে, এবং ৩০০-টোকেন উত্তর। API-এর কোনো স্মৃতি নেই, তাই প্রতিটি অনুরোধ পুরো কথোপকথন আবার বহন করে (দীর্ঘ চ্যাট কেন বেশি খরচ করে)।
টার্ন ১ পাঠায় ২,০০০ + ৬০০ = ২,৬০০ টোকেন। টার্ন ২০ পাঠায় ২,০০০ + ৬০০ × ২০ + ৩০০ × ১৯ = ১৯,৭০০। শেষ সংখ্যাটি নিজে চেষ্টা করুন:
সংখ্যা অনুমান করুন
একটি সিট তার ২০তম টার্নে কত ইনপুট টোকেন পাঠায়?
আপনার অনুমান
০৪০,০০০
উত্তর দেখান
উত্তর: ১৯,৭০০
১৯,৭০০: ২,০০০-টোকেন সিস্টেম প্রম্পট, ২০ × ৬০০ নতুন টক, এবং ১৯টি আগের উত্তর প্রতিটি ৩০০। প্রতিটি পুরনো উত্তর ও প্রতিটি পুরনো বার্তা আবার ভেতরে যায়।
একটি সিটের জন্য সব ২০ টার্ন যোগ করুন: ২,০০০ × ২০ + ৬০০ × ২১০ + ৩০০ × ১৯০ = ৪০,০০০ + ১২৬,০০০ + ৫৭,০০০ = ২২৩,০০০ ইনপুট টোকেন। আউটপুট মাত্র ২০ × ৩০০ = ৬,০০০। যদি প্রতিটি বার্তা একবার গুনতেন, পেতেন ২,০০০ + ২০ × ৬০০ = ১৪,০০০ এবং ষোলো গুণ ভুল করতেন।
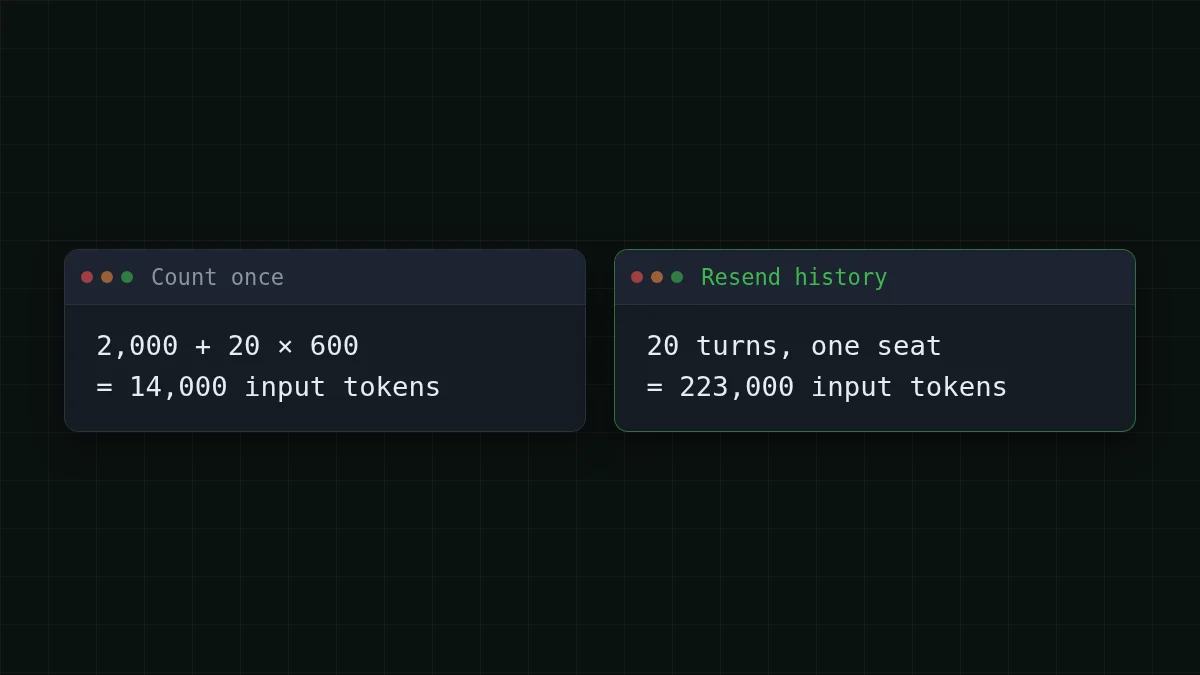
আউটপুট দিক প্রায় নড়ে না। টাকা যায় ইনপুটে, এবং খেলা দীর্ঘ হলে সেই দিকটাই খারাপ হয়।
একটি সিট থেকে পুরো টুর্নামেন্টে#
এখন তিনটি গুণক দিয়ে স্কেল করুন।
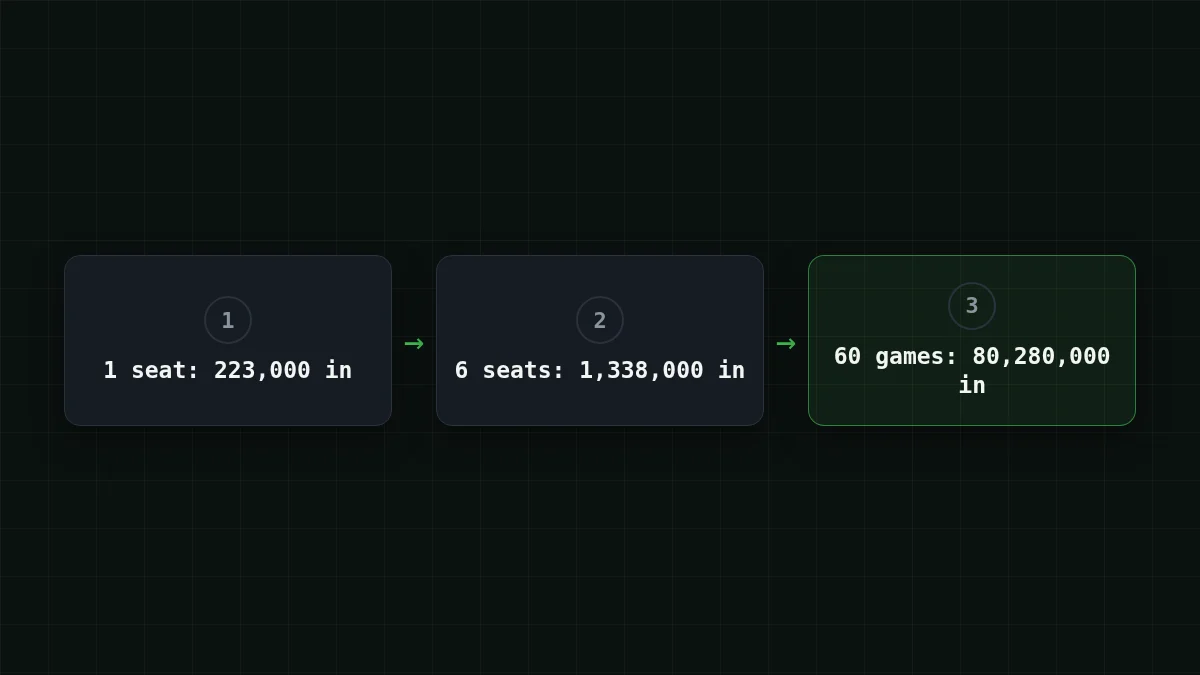
- সিট। ৬ সিট × ২২৩,০০০ = ১,৩৩৮,০০০ ইনপুট টোকেন এবং ৬ × ৬,০০০ = ৩৬,০০০ আউটপুট টোকেন প্রতি খেলায়।
- পক্ষ বদল। রাউন্ড রবিনে ৩টি মডেল নিন: ৩টি জোড়া। প্রতি জোড়ায় ১০টি ডিল, প্রতিটি দুইবার পক্ষ বদলে: ৩ × ১০ × ২ = ৬০ খেলা।
- খেলা। ৬০ × ১,৩৩৮,০০০ = ৮০,২৮০,০০০ ইনপুট এবং ৬০ × ৩৬,০০০ = ২,১৬০,০০০ আউটপুট টোকেন টুর্নামেন্টের জন্য।
DeepSeek-V4-Flash-এ একটি খেলা দাঁড়ায় $0.0237। নিচের টেবিল পুরো ৬০-খেলার টুর্নামেন্টের দাম করে যেন সেই একটি মডেল প্রতিটি সিটে খেলেছে, যাতে আপনি এই ধরনের দীর্ঘ-কথোপকথন কাজের জন্য CheapTokens যে তিনটি মডেল দেয় তা তুলনা করতে পারেন। মোট, ইনপুট ও আউটপুট একসাথে গুনলে, তাদের প্রত্যেকেই শেষ কলামের OpenRouter রেফারেন্সের চেয়ে সস্তা।
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৬০টি অনুরোধ | OpenRouter, ৬০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
প্রতি অনুরোধে ১৩,৩৮,০০০ ইনপুট এবং ৩৬,০০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
বাজেটের দিক থেকে এটাই পুরো কৌশল: তিনটি মডেলের মধ্যে কোনটি একটি দর-কষাকষির খেলা ভালো খেলে তা জানতে আপনার $20,000 লাইন আইটেম দরকার নেই। আপনার দরকার উপরের অনুমান, এবং তারপর তা যাচাই করার একটি বাস্তব পাইলট।
দ্রুত যাচাই
আপনার ৬-সিট খেলা প্রতি সিটে ২০ থেকে ৪০ টার্নে যায়। ইনপুট বিলের কী হয়?
উত্তর দেখান
উত্তর: প্রায় ৩.৬ গুণ বাড়ে
৪০ টার্নের জন্য একই সূত্র দেয় ২,০০০ × ৪০ + ৬০০ × ৮২০ + ৩০০ × ৭৮০ = ৮০৬,০০০ ইনপুট টোকেন, ২০ টার্নের ২২৩,০০০-এর বিপরীতে। হিস্ট্রি পদটি টার্ন সংখ্যার বর্গের সাথে বাড়ে।
এমন কোনো সংখ্যা বিশ্বাস করার আগে দুটি যাচাই। প্রথমত, সবচেয়ে বড় অনুরোধ মডেলের উইন্ডোতে ফিট হতে হবে। ২০ টার্নে সবচেয়ে বড় অনুরোধ ১৯,৭০০ টোকেন, সমস্যা নেই। প্রতি সিটে ২০০ টার্নের বহু-ঘণ্টার খেলা পৌঁছায় ২,০০০ + ৬০০ × ২০০ + ৩০০ × ১৯৯ = ১৮১,৭০০, প্রায় ১৮২K, তাই খেলা ডিজাইনের আগে মডেলের পৃষ্ঠায় কনটেক্সট সাইজ পড়ুন। DeepSeek-V4-Flash-এর ৩৮০K উইন্ডো এবং সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন; দেখুন মডেল পৃষ্ঠা। দ্বিতীয়ত, যদি কোনো মডেল দীর্ঘ রিজনিং দেয়, আপনার ৩০০ আউটপুট টোকেন বেশি হয়ে যায় (বাল্ক কাজে থিংকিং টোকেন)।
কোডে একটি কঠোর সীমা বসান#
README-র --budget ফ্ল্যাগ সঠিক ধারণা, এবং নিজের হার্নেসে কপি করতে দশ লাইন লাগে। নিচের স্ক্রিপ্ট চালানোর আগে অনুমান করে, এমন কোনো অনুরোধ পাঠাতে অস্বীকার করে যা মোট সীমার উপরে ঠেলে দিতে পারে, এবং প্রতিটি কল একটি লেজার ফাইলে লগ করে। এতে থাকা দামগুলো একটি উদাহরণ: প্রাইসিং টেবিল থেকে বর্তমানগুলো বসান।
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) প্রিন্ট করে (1338000, 36000), উপরের মতোই প্রতি-খেলার সংখ্যা, তাই কোড ও গণিত একে অপরকে যাচাই করে। usage. এবং usage. রেসপন্স থেকে আসে এবং এগুলোই আপনার বিল হয়; প্রি-চেক একটি হতাশাবাদী অক্ষর গণনা ব্যবহার করে কারণ প্রকৃত গণনা কেবল কলের পরেই জানা যায়। প্রতি-প্রকল্প লেজার নিয়ে আরও জানতে Python-এ এজেন্ট টোকেন খরচ ট্র্যাকিং।
প্রথম রানের জন্য একটি নিরাপদ ক্রম#
রেপোর নিজস্ব ক্রম একটি ভালো মডেল: আগে বিনামূল্যে, তারপর সস্তা, শেষে ব্যয়বহুল। এই ধাপগুলো ক্রমে সাজান:
ক্রমে সাজান
একটি নিরাপদ প্রথম রানের ধাপগুলো ক্রমে সাজান
আইটেমগুলো ড্র্যাগ করুন বা তীর ব্যবহার করুন
- একটি র্যান্ডম প্লেয়ার দিয়ে ড্রাই রান, কোনো API কল নেই
estimate()চালান এবং আপনার সীমার সাথে তুলনা করুন- একটি বাস্তব খেলা খেলুন এবং লেজার পড়ুন
- প্রকৃত টোকেন গণনা দিয়ে অনুমান সংশোধন করুন
- সীমা চালু রেখে পুরো টুর্নামেন্ট শুরু করুন
README বলে সস্তা মডেলে একটি ডেমো খেলা খরচ করে প্রায় $2–5। এটি লেখকের বিবৃতি এবং মডেলগুলোর নাম দেওয়া নেই, তাই এটিকে একটি যুক্তিসঙ্গত পরিসর ধরুন, আপনার সেটআপের কোট নয়। আপনার নিজের পাইলট খেলা সেই সংখ্যা দেয় যা গুরুত্বপূর্ণ: যদি এর লেজার দেখায় ১,৫০০,০০০ ইনপুট টোকেন যেখানে আপনি ধরে নিয়েছিলেন ১,৩৩৮,০০০, তাহলে আপনি কয়েক সেন্টে কিছু শিখেছেন, ৪০তম খেলায় নয়।
দীর্ঘ পরীক্ষার জন্য, সাধারণ লিভারগুলো চ্যাট হিস্ট্রি ছাঁটাই-তে আছে: প্রতিটি সিটকে যা আবার পড়তে হয় তা কাটুন, এবং বর্গীয় পদটি তার সাথে ছোট হয়। চালানোর জন্য প্রস্তুত হলে, ডকুমেন্টেশন-এ এন্ডপয়েন্ট ও মডেল আইডি আছে।


