成本优化指南
在运行模型锦标赛之前估算其 API 成本
统计每个座位的 token 数,乘以局数和阵营交换次数,并在 Python 中设置硬性上限:一个 6 座位、60 局模型锦标赛的完整估算示例。
你可以在第一次请求之前就知道一场模型锦标赛的账单:统计一个座位在一整局游戏中发送的 token 数,乘以座位数和局数,并在代码中设置硬性上限。人们容易忽略的是历史记录。每一轮都会重新发送此前说过的所有内容,因此输入的增长速度远快于轮数。
20,000 美元的头条数字能说明什么、不能说明什么#
2026 年 11 月 5 日,播客主 Dwarkesh Patel 发布了 Clocktower Bench,这是一个让模型互相对战社交推理游戏《Blood on the Clocktower》的基准测试。他说自己花了约 20,000 美元的 API 额度来搭建这套测试框架,其中很大一部分用于反复迭代环境设计,超出了他原本计划的 token 用量。
该项目的 README(2026 年 11 月 8 日查看)描述了这套设置:11 个模型,用于头条排名的 386 局游戏,一个模型扮演所有好人座位,另一个模型扮演所有邪恶座位,10–12 名玩家,每局持续数小时。每一手牌都会交换阵营重放一次,因此两个模型都不会拿到更轻松的角色。它还附带一次免费的试运行(--model random),将花费写入 games/,并有一个默认值为 $1,000 的 --budget 上限。
它没有提供的是每局游戏的 token 数。所以没有现成的东西可以照搬;你需要自己构建估算。这就是本文其余部分要做的事,其中的假设都已明确说明,你可以替换成自己的假设。
一个座位:为什么输入会持续增长#
假设你运行一个更小的游戏:6 个座位,每个座位都是一个拥有自己对话的模型,每个座位 20 轮。假设系统提示词为 2,000 token(规则和该座位的角色),每轮之前到达 600 token 的新桌面发言,以及 300 token 的回复。API 没有记忆,因此每次请求都会再次携带整个对话(为什么长聊天成本更高)。
第 1 轮发送 2,000 + 600 = 2,600 token。第 20 轮发送 2,000 + 600 × 20 + 300 × 19 = 19,700。自己算一下最后一个数字:
猜数字
一个座位在第 20 轮发送多少输入 token?
你的猜测
040,000
显示答案
答案: 19,700
19,700:2,000 token 的系统提示词、20 × 600 的新发言,以及 19 条此前每条 300 的回复。每一条旧回复和每一条旧消息都会被重新发送。
把一个座位的全部 20 轮加起来:2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 输入 token。输出只有 20 × 300 = 6,000。如果你把每条消息只计一次,你会得到 2,000 + 20 × 600 = 14,000,差了十六倍。
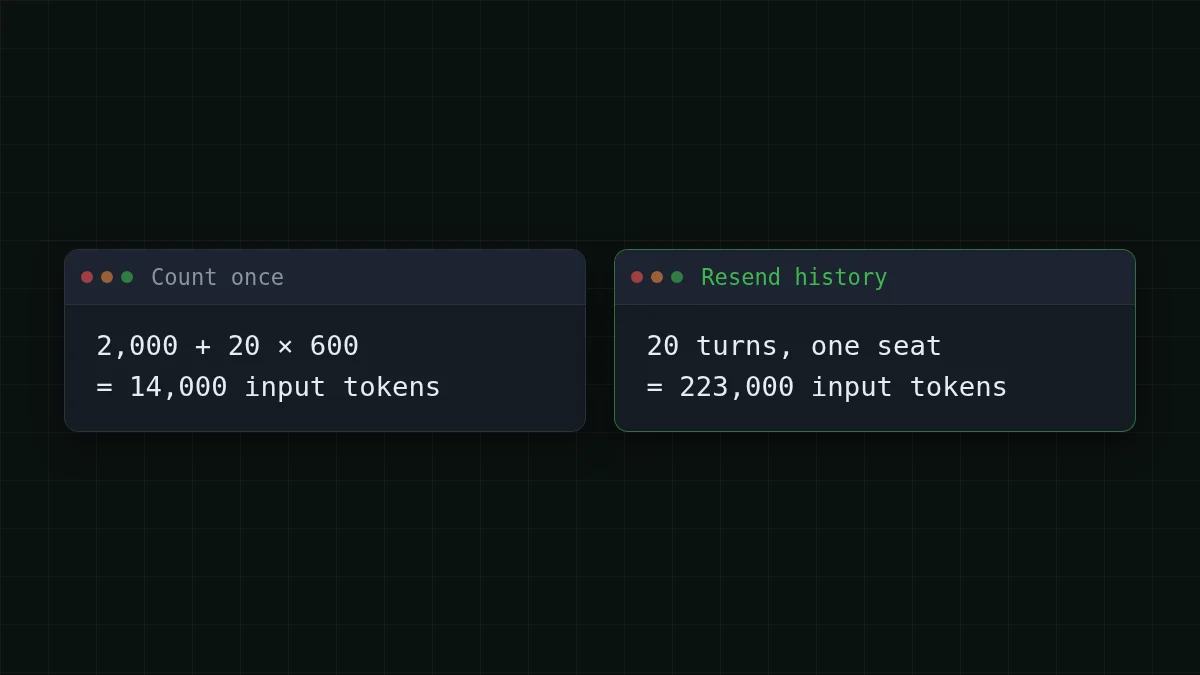
输出侧几乎不变。钱主要花在输入上,而随着游戏变长,这一侧会变得更糟。
从一个座位到整场锦标赛#
现在用三个乘数来放大它。
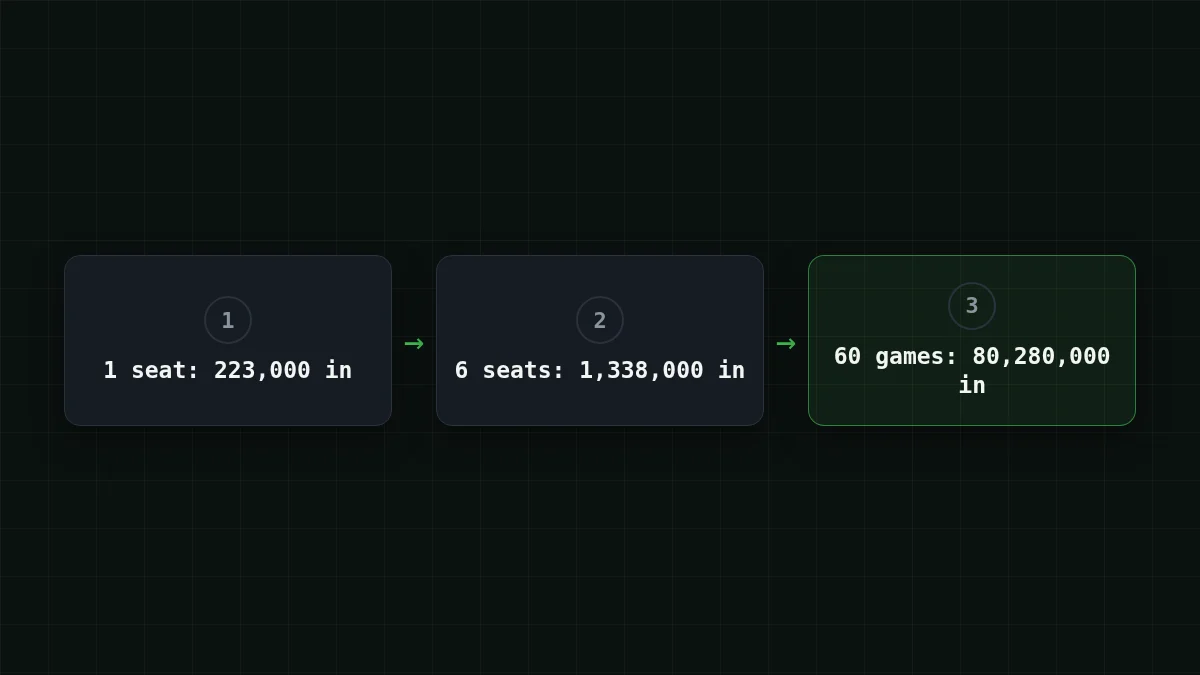
- 座位。 6 个座位 × 223,000 = 1,338,000 输入 token,每局 6 × 6,000 = 36,000 输出 token。
- 交换阵营。 取 3 个模型进行循环赛:3 个配对。每个配对打 10 手牌,每一手都交换阵营打两次:3 × 10 × 2 = 60 局。
- 局数。 整场锦标赛 60 × 1,338,000 = 80,280,000 输入 token 和 60 × 36,000 = 2,160,000 输出 token。
在 DeepSeek-V4-Flash 上,一局游戏的成本为 $0.0237。下表按这一个模型扮演所有座位来为整场 60 局锦标赛定价,这样你可以比较 CheapTokens 为这类长对话任务提供的三个模型。总计将输入和输出加在一起,它们每一个都比最后一列中的 OpenRouter 参考价更便宜。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 60 次请求 | OpenRouter,60 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
每次请求 1,338,000 个输入 token 和 36,000 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
从预算角度看,这就是全部的诀窍:你不需要一笔 20,000 美元的支出项来了解三个模型中哪一个更擅长玩谈判游戏。你需要的是上面的估算,然后进行一次真实的试点来验证它。
快速检查
你的 6 座游戏从每个座位 20 轮增加到 40 轮。输入账单会发生什么变化?
显示答案
答案: 增长约 3.6 倍
对于 40 轮,同样的公式给出 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 输入 token,而 20 轮为 223,000。历史项随轮数的平方增长。
在信任任何此类数字之前,先做两项检查。第一,最大的请求必须能放进模型的上下文窗口。在 20 轮时,最大的请求是 19,700 token,没有问题。一场持续数小时、每个座位 200 轮的游戏会达到 2,000 + 600 × 200 + 300 × 199 = 181,700,约 182K,所以在设计游戏之前,先阅读模型页面上的上下文大小。DeepSeek-V4-Flash 有 380K 的窗口和最多 32,768 输出 token;参见模型页面。第二,如果模型输出很长的推理,你的 300 输出 token 会变得更多(批量任务中的思考 token)。
在代码中设置硬性上限#
README 中的 --budget 标志是正确思路,复制到你自己的测试框架中只需十行代码。下面的脚本在运行前先估算,拒绝发送可能使总额超过上限的请求,并将每次调用记录到账本文件。其中的价格只是示例:请从价格表中替换为当前价格。
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) 会打印 (1338000, 36000),与上面的每局数字相同,因此代码和算术可以相互校验。usage. 和 usage. 来自响应,也是你实际被计费的部分;预检查使用悲观的字符计数,因为真实计数只有在调用之后才能知道。更多关于按项目记账的内容,参见在 Python 中跟踪 agent token 成本。
首次运行的安全顺序#
仓库自身的顺序就是一个好模型:先免费,再便宜,最后昂贵。将这些步骤排序:
排序
将安全首次运行的步骤排序
拖动项目或使用箭头
- 用随机玩家试运行,不进行 API 调用
- 运行
estimate()并与你的上限比较 - 玩一局真实游戏并读取账本
- 用真实 token 数修正假设
- 在开启上限的情况下启动完整锦标赛
README 说,在便宜模型上进行一局演示游戏大约花费 $2–5。这是作者的说法,且没有点名模型,所以把它当作一个合理的参考范围,而不是针对你的设置的报价。你自己的试点游戏会给出真正重要的数字:如果它的账本显示 1,500,000 输入 token,而你假设的是 1,338,000,那么你只花了几美分就学到了东西,而不是等到第 40 局。
对于更长的实验,常用的手段在裁剪聊天历史中:减少每个座位必须重读的内容,二次项也会随之缩小。当你准备好运行时,文档中有端点和模型 ID。


