Оптимизация расходовИнструкция
Сколько стоит турнир моделей: оценка до запуска
Считаем токены на место за столом, умножаем на партии и обмен сторонами и ставим жёсткий лимит в Python: расчёт турнира моделей на 60 партий.
Содержание
Счёт за турнир моделей можно узнать до первого запроса: посчитайте токены, которые одно место отправляет за всю партию, умножьте на места и партии и поставьте в код жёсткий лимит. Чаще всего забывают про историю. Каждый ход отправляет заново всё, что было сказано, поэтому вход растёт куда быстрее, чем число ходов.
Что говорят 20 000 долларов, а что нет#
5 ноября 2026 года подкастер Dwarkesh Patel опубликовал Clocktower Bench — бенчмарк, где модели играют друг против друга в «Кровь на часовой башне». По его словам, на создание инструмента ушло около $20 000 API-кредитов, причём заметная часть — на доработку среды, больше, чем он планировал потратить на токены.
В README проекта (на 8 ноября 2026 года) описано устройство: 11 моделей, 386 партий для главного рейтинга, одна модель играет за всех добрых, другая за всех злых, 10–12 игроков, партия идёт несколько часов. Каждая раздача переигрывается с обменом сторон, чтобы ни одной модели не досталась более лёгкая роль. Есть и бесплатный пробный прогон (--model random), журнал расходов games/ и лимит --budget, по умолчанию $1 000.
Чего там нет — токенов на партию. Копировать нечего, оценку придётся строить самим. Этим и займёмся, с допущениями, которые легко заменить своими.
Одно место: почему вход всё растёт#
Допустим, партия поменьше: 6 мест, за каждым своя модель со своим диалогом, по 20 ходов на место. Системный промпт — 2 000 токенов (правила и роль), перед каждым ходом приходит 600 новых токенов разговора за столом, ответ — 300 токенов. Память у API нет, поэтому каждый запрос несёт весь диалог заново (почему длинный чат дороже).
Ход 1 отправляет 2 000 + 600 = 2 600 токенов. Ход 20 — 2 000 + 600 × 20 + 300 × 19 = 19 700. Последнее число проверьте сами:
Угадайте число
Сколько входных токенов отправляет место на 20-м ходу?
Ваш вариант
040 000
Показать ответ
Ответ: 19 700
19 700: системный промпт на 2 000, 20 × 600 нового разговора и 19 прежних ответов по 300. Каждое старое сообщение и каждый старый ответ уходят снова.
Сложим все 20 ходов одного места: 2 000 × 20 + 600 × 210 + 300 × 190 = 40 000 + 126 000 + 57 000 = 223 000 входных токенов. Выход — всего 20 × 300 = 6 000. Если считать каждое сообщение один раз, выйдет 2 000 + 20 × 600 = 14 000, и ошибка составит в шестнадцать раз.
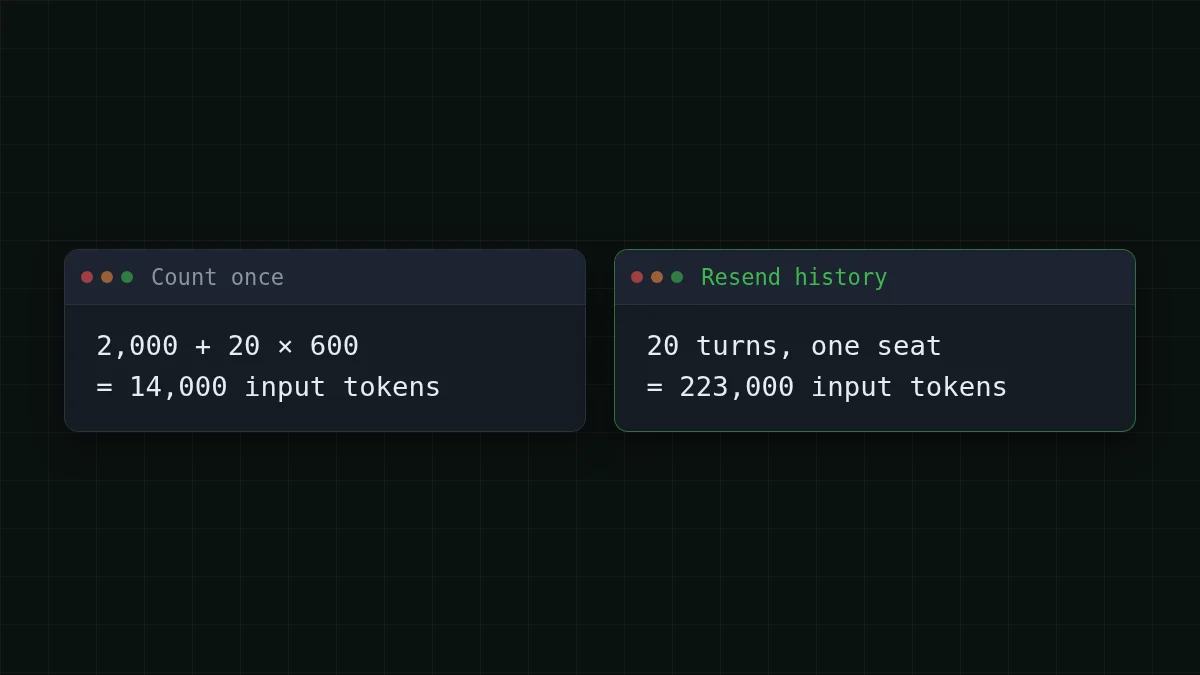
Выход почти не меняется. Деньги уходят на вход, и чем длиннее партии, тем сильнее.
От одного места к целому турниру#
Дальше три множителя.
- Места. 6 мест × 223 000 = 1 338 000 входных токенов и 6 × 6 000 = 36 000 выходных за партию.
- Обмен сторонами. Возьмём 3 модели по круговой системе: 3 пары. В каждой 10 раздач, и каждая играется дважды с обменом сторон: 3 × 10 × 2 = 60 партий.
- Партии. 60 × 1 338 000 = 80 280 000 входных и 60 × 36 000 = 2 160 000 выходных токенов на весь турнир.
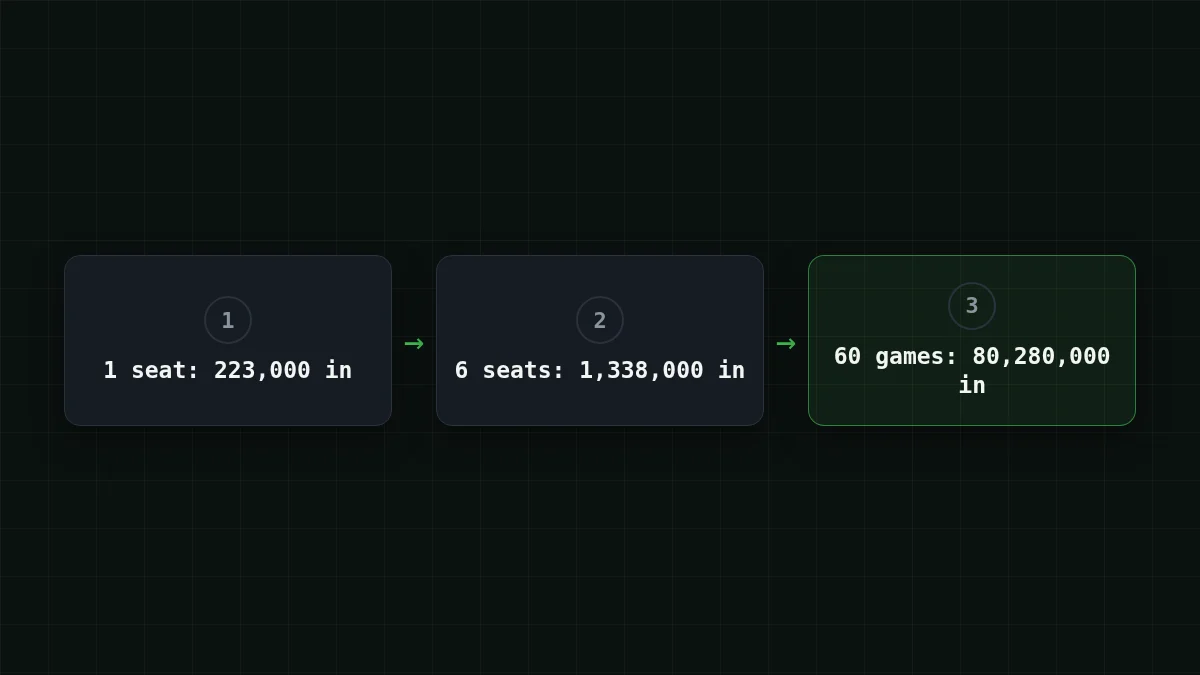
Одна партия на DeepSeek-V4-Flash обойдётся в $0.0237. Таблица ниже считает весь турнир из 60 партий так, будто эта модель играет за все места: так удобно сравнить три модели CheapTokens для задачи с длинными диалогами. В сумме, с учётом входа и выхода, каждая из них дешевле референса OpenRouter в последнем столбце.
| Модель | Вход $/1M | Выход $/1M | За запрос | 60 запросов | OpenRouter, 60 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
1 338 000 входных и 36 000 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В этом весь расчёт: чтобы понять, какая из трёх моделей лучше играет в переговорную игру, не нужна статья расходов на $20 000. Нужна оценка выше и настоящий пилот, который её проверит.
Быстрая проверка
Партия из 6 мест выросла с 20 до 40 ходов на место. Что станет со счётом за вход?
Показать ответ
Ответ: Вырастет примерно в 3,6 раза
Для 40 ходов та же формула даёт 2 000 × 40 + 600 × 820 + 300 × 780 = 806 000 входных токенов против 223 000 при 20 ходах. Слагаемое с историей растёт как квадрат числа ходов.
Две проверки, прежде чем верить любой такой цифре. Первая: самый большой запрос должен влезать в окно модели. При 20 ходах он равен 19 700 токенов, тут всё спокойно. А партия на несколько часов с 200 ходами на место доходит до 2 000 + 600 × 200 + 300 × 199 = 181 700, то есть около 182K, поэтому размер окна смотрите на странице модели до того, как проектировать игру. У DeepSeek-V4-Flash окно 380K и до 32 768 токенов в ответе, подробности на странице модели. Вторая: если модель выдаёт длинные рассуждения, ваши 300 выходных токенов превратятся в больше (токены рассуждений в массовой задаче).
Поставьте жёсткий лимит в код#
Флаг --budget из README — правильная идея, и в свой инструмент её переносят за десять строк. Скрипт ниже считает оценку до запуска, не отправляет запрос, который может вывести сумму за лимит, и пишет каждый вызов в журнал. Цены в нём — пример: подставьте текущие из таблицы цен.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) печатает (1338000, 36000) — те же числа на партию, что и выше, так что код и арифметика проверяют друг друга. usage. и usage. приходят в ответе, и именно по ним идёт списание; проверка до запроса опирается на осторожный подсчёт по символам, потому что точное число известно только после вызова. Про журнал расходов по проектам — в статье как отслеживать расход токенов агента на Python.
Безопасный порядок первого запуска#
Последовательность из самого репозитория хороша: сначала бесплатное, потом дешёвое, дорогое в конце. Расставьте шаги по порядку:
Расставьте по порядку
Расставьте шаги безопасного первого запуска по порядку
Перетащите элементы или используйте стрелки
- Пробный прогон со случайным игроком, без вызовов API
- Запустить
estimate()и сравнить с лимитом - Сыграть одну настоящую партию и прочитать журнал
- Поправить допущения по реальным токенам
- Запустить весь турнир с включённым лимитом
В README сказано, что демо-партия на дешёвых моделях стоит около $2–5. Это слова автора, модели там не названы, так что считайте это ориентиром для здравого смысла, а не ценой для вашей установки. Нужное число даст ваша собственная пробная партия: если в журнале 1 500 000 входных токенов вместо предполагаемых 1 338 000, вы узнали это за несколько центов, а не на сороковой партии.
Для более долгих экспериментов основные рычаги описаны в статье про обрезку истории чата: чем меньше каждое место перечитывает, тем меньше квадратичное слагаемое. Когда будете готовы запускать, документация подскажет адрес API и id моделей.


