Начало работыИнструкция
Первый запрос к CheapTokens на Python через requests, без SDK
Скрипт на Python только с requests: один запрос к чату, таймаут, обработка HTTP-ошибок и вывод ответа, finish_reason и usage.
Содержание
Чтобы работать с OpenAI-совместимым API, пакет openai не нужен. Хватит одного requests.post, ключа в заголовке и JSON в теле, а заодно вы увидите, что именно уходит по сети. Здесь мы соберём такой скрипт для CheapTokens (https:/), и он выведет ответ, finish_reason и расход токенов.
Подойдёт, если на машине стоит только requests, если небольшому cron-скрипту не нужен SDK, или если вы хотите понять, что SDK делает за вас. Первый запрос через SDK, curl и Node описан отдельно; это вариант на чистом Python.
Весь скрипт целиком#
Сначала положите ключ в переменную окружения (как это сделать безопасно — в статье как хранить API-ключ), затем сохраните файл ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Запустите python ask.py. Id модели — полный: deepseek-; если не уверены, что подставить, посмотрите список моделей через GET /v1/models. Чтобы попробовать другую модель, замените id на zai-, больше ничего менять не нужно: баланс один на все модели.
Что делает каждая строка#
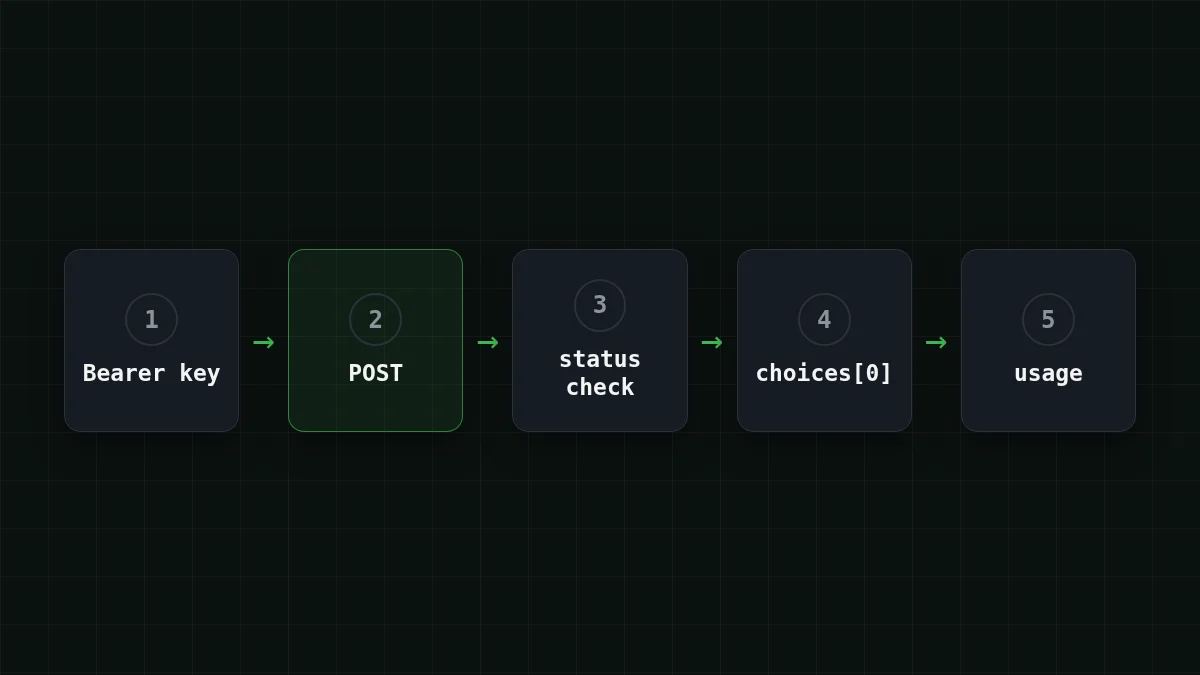
Разберём пять идей, на которых держится скрипт. Большинство из них объясняет Quickstart библиотеки requests (живая документация, сверено 2 ноября 2026), а поля ответа описаны в справочнике Chat Completions от OpenAI.
Карточки
Пять вещей в скрипте
Нажмите на карточку, чтобы перевернуть её
Третий пункт пропускают чаще всего. Скрипт, который навсегда завис в cron, хуже скрипта, который громко упал через 30 секунд.
Читаем ответ#
Успешный ответ — это JSON. Что в нём важно, по справочнику Chat Completions:
choices[0].— текст. Он может бытьmessage. content null, поэтому не вызывайте у него строковые методы вслепую.choices[0].— почему модель остановилась:finish_ reason stop(закончила),length(упёрлась вmax_tokens),tool_calls,content_filter.usage.,prompt_ tokens usage.иcompletion_ tokens usage.— то, за что вы платите: вход, выход и их сумма.total_ tokens
Форма ответа такая (числа здесь условные):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Попробуйте самиПопробуйте: поставьте max_tokens равным 5 и запустите скрипт снова. Что покажет finish_reason?Показать ответ
Он покажет length: модель остановил ваш лимит max_tokens, поэтому ответ обрывается на полуслове. Поднимите лимит, и снова будет stop. Подробно — в статье Ответ ИИ обрывается? finish_reason «length».
Если не работает#
Скрипт превращает большинство сбоев в одну строку вывода. Вот что они обычно значат:
Найдите пары
Сопоставьте сообщение и обычную причину
Нажмите на элемент слева, затем на его пару
- HTTP 401Ключ не передан, опечатка или отправлен не тот ключ
- HTTP 404Неверен путь в адресе или id модели
- requests.exceptions.TimeoutЗа время таймаута не пришло ни одного байта
- KeyError: 'CHEAPTOKENS_API_KEY'В этом терминале не задана переменная окружения
Реальные тела ошибок и проверку ключа, адреса и id модели по шагам ищите в статье Ошибка API 401 или 404: ключ, base URL или id модели. И ещё две мелочи: если видите KeyError: 'choices', вы разобрали тело ошибки как успешный ответ, значит, raise_ пропущен. А если на машине есть файл ~/.netrc, requests может взять учётные данные оттуда вместо вашего заголовка Authorization.
Сколько стоит один вызов#
По условным числам из ответа выше (около 18 токенов на входе и 52 на выходе) один вызов DeepSeek-V4-Flash стоит $0.0000055. Такую сумму не прочувствовать, так что умножим. Допустим, скрипт разбирает 1 000 обращений в поддержку в день, примерно по 800 токенов на входе и 300 на выходе:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 входных и 300 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Цена модели фиксирована и не зависит от времени суток, так что в три ночи скрипт обойдётся так же, как в полдень. Актуальные цены — на странице тарифов, эндпоинты — в документации.
Что дальше#
Когда это заработает, обычно идут дальше тремя путями: цикл по множеству входов, повтор при 429 (см. 429 Too Many Requests: повторы с паузой) или тот же вызов со стримингом. А если не хочется самому возиться с HTTP, переход на SDK — это одна замена base_url.


