Erste SchritteAnleitung
Erster Request an CheapTokens in Python mit requests, ohne SDK
Ein 20-zeiliges Python-Skript nur mit requests: eine Chat-Completion, ein Timeout, HTTP-Fehlerbehandlung und die ausgegebene Antwort, finish_reason und Nutzung.
Auf dieser Seite
Du brauchst das Paket openai nicht, um mit einer OpenAI-kompatiblen API zu sprechen. Ein requests.post-Aufruf, ein Bearer-Key und ein JSON-Body reichen aus, und du siehst genau, was über die Leitung geht. Diese Anleitung baut dieses Skript für CheapTokens (https:/) und endet damit, dass es die Antwort, finish_reason und die Token-Nutzung ausgibt.
Es passt gut, wenn du auf einer abgeschotteten Maschine arbeitest, auf der nur requests installiert ist, wenn ein kleiner Cron-Job kein SDK mitziehen soll oder wenn du einfach verstehen willst, was das SDK für dich tut. Die Anleitung zum ersten Request behandelt SDK, curl und Node; hier geht es um reines Python.
Das ganze Skript#
Lege deinen Key zuerst in einer Umgebungsvariable ab (siehe wie man einen API-Key sicher speichert) und speichere dann dies als ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
Führe python ask.py aus. Die Modell-ID ist die vollständige Gateway-ID, deepseek-; wenn du unsicher bist, was dort hingehört, liste die Modelle mit GET /v1/models. Um ein anderes Modell auszuprobieren, tausche zai- ein und ändere sonst nichts: ein Guthaben deckt alle Modelle ab.
Was jede Zeile tut#
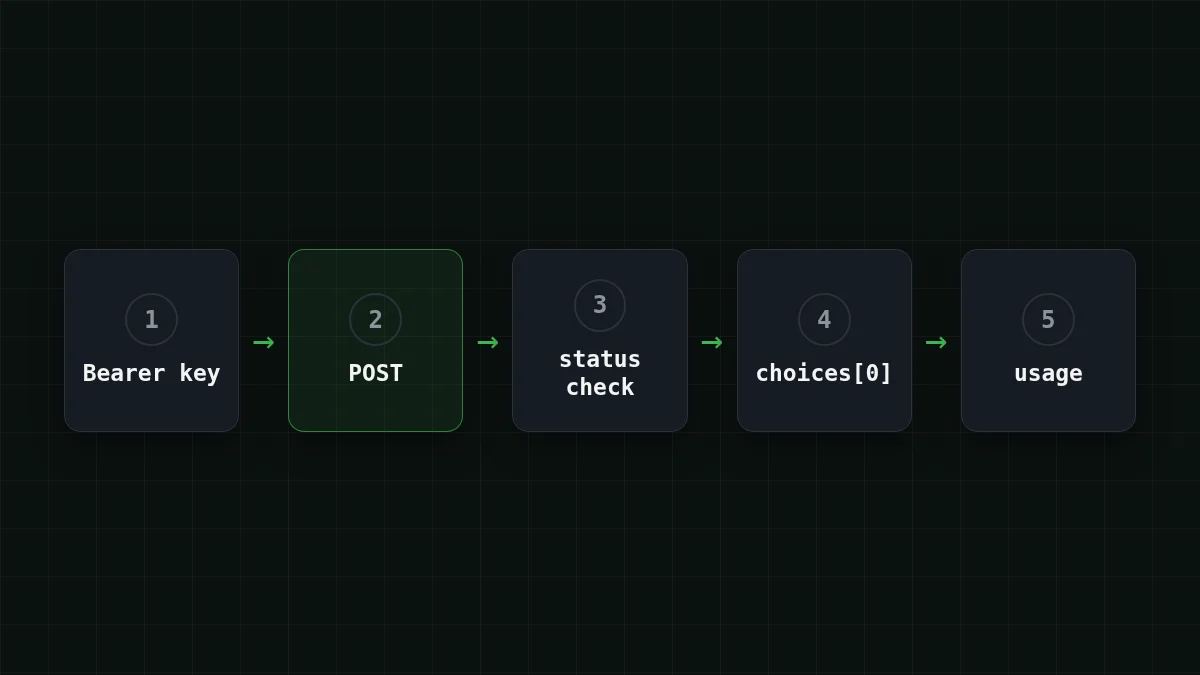
Hier sind die fünf Ideen, auf denen das Skript aufbaut. Der requests Quickstart (lebende Doku, geprüft am 2. November 2026) erklärt die meisten davon, und die Chat-Completions-Referenz von OpenAI definiert die Felder in der Antwort.
Lernkarten
Fünf Dinge im Skript
Tippe auf eine Karte, um sie umzudrehen
Der dritte Punkt ist der, den die Leute überspringen. Ein Skript, das in einem Cron-Job ewig hängt, ist viel schlimmer als eines, das nach 30 Sekunden laut scheitert.
Die Antwort lesen#
Eine erfolgreiche Antwort ist JSON. Die Teile, die dich interessieren, laut Chat-Completions-Referenz:
choices[0].ist der Text. Er kannmessage. content nullsein, also rufe nicht blind String-Methoden darauf auf.choices[0].sagt, warum das Modell gestoppt hat:finish_ reason stop(es ist fertig),length(das Limitmax_tokenshat es abgeschnitten),tool_calls,content_filter.usage.,prompt_ tokens usage.undcompletion_ tokens usage.sind das, wofür du bezahlst: Input, Output und deren Summe.total_ tokens
Die Antwort hat diese Form (die Zahlen sind Platzhalter):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
Probier es selbstProbier es aus: setze max_tokens auf 5 und führe das Skript erneut aus. Was sagt finish_reason?Antwort anzeigen
Es sagt length: das Modell wurde durch dein Limit max_tokens gestoppt, die Antwort endet also mitten im Satz. Erhöhe das Limit und du bekommst wieder stop. Die ganze Geschichte steht in KI-Antwort abgeschnitten? finish_reason "length" beheben.
Wenn es nicht funktioniert#
Das Skript verwandelt die meisten Fehler in eine Zeile Ausgabe. Hier ist, was jede davon meist bedeutet:
Paare zuordnen
Ordne jede Meldung ihrer üblichen Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- HTTP 401Der Key fehlt, ist falsch geschrieben oder nicht der, den du senden wolltest
- HTTP 404Der URL-Pfad oder die Modell-ID ist falsch
- requests.exceptions.TimeoutInnerhalb des Timeouts sind keine Bytes angekommen
- KeyError: 'CHEAPTOKENS_API_KEY'Die Umgebungsvariable ist in diesem Terminal nicht gesetzt
Für die tatsächlichen Fehler-Bodys und eine schrittweise Prüfung von Key, Basis-URL und Modell-ID nutze API 401- oder 404-Fehler: falscher Key, falsche Basis-URL oder Modell-ID. Zwei kleinere Stolperfallen: wenn du KeyError: 'choices' siehst, hast du einen Fehler-Body als Erfolg geparst, was bedeutet, dass raise_ übersprungen wurde. Und wenn deine Maschine eine ~/.netrc-Datei hat, kann requests deren Credentials statt des von dir gesetzten Authorization-Headers verwenden.
Was ein Aufruf kostet#
Mit den Platzhalterzahlen aus der Antwort oben (etwa 18 Tokens rein, 52 raus) kostet ein Aufruf von DeepSeek-V4-Flash $0.0000055. Das ist eine Zahl, die man nicht spürt, also rechne es hoch. Sagen wir, dein Skript fasst 1.000 Support-Tickets pro Tag zusammen, jeweils etwa 800 Tokens rein und 300 raus:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Preise sind pro Modell fest, ohne Stoßzeiten, also kostet dasselbe Skript um 3 Uhr nachts dasselbe wie mittags. Die aktuellen Preise pro Modell stehen auf der Preisseite, und die Doku listet die Endpunkte auf.
Wie es weitergeht#
Sobald das funktioniert, sind die üblichen nächsten Schritte eine Schleife über viele Eingaben, ein Retry bei 429 (siehe 429 Too Many Requests: Retries mit Backoff) oder derselbe Aufruf mit Streaming. Wenn du HTTP lieber nicht selbst verwalten möchtest, ist der SDK-Weg nur eine base_url-Änderung entfernt.


