เริ่มต้นใช้งานคู่มือ
คำขอแรกไปยัง CheapTokens ใน Python ด้วย requests โดยไม่ใช้ SDK
สคริปต์ Python 20 บรรทัดที่ใช้แค่ requests: chat completion หนึ่งครั้ง timeout การจัดการข้อผิดพลาด HTTP และพิมพ์คำตอบ finish_reason และ usage
ในหน้านี้
คุณไม่จำเป็นต้องใช้แพ็กเกจ openai เพื่อคุยกับ API ที่เข้ากันได้กับ OpenAI แค่การเรียก requests.post ครั้งเดียว คีย์ Bearer และ JSON body ก็เพียงพอ และคุณจะเห็นได้ชัดว่ามีอะไรส่งผ่านเครือข่ายไปบ้าง คู่มือนี้สร้างสคริปต์นั้นสำหรับ CheapTokens (https:/) และจบลงด้วยการพิมพ์คำตอบ finish_reason และการใช้โทเค็น
เหมาะอย่างยิ่งหากคุณอยู่บนเครื่องที่ถูกล็อกดาวน์ซึ่งติดตั้งไว้แค่ requests หาก cron job เล็กๆ ไม่ควรดึง SDK เข้ามา หรือหากคุณแค่อยากเข้าใจว่า SDK ทำให้คุณอย่างไร คู่มือคำขอแรก ครอบคลุมเส้นทาง SDK, curl และ Node; ส่วนนี่คือเส้นทางแบบ Python ล้วน
สคริปต์ทั้งหมด#
ใส่คีย์ของคุณในตัวแปรสภาพแวดล้อมก่อน (ดู วิธีเก็บ API key อย่างปลอดภัย) จากนั้นบันทึกเป็น ask.py:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
รัน python ask.py model id คือ gateway id แบบเต็ม deepseek-; หากไม่แน่ใจว่าจะใส่อะไร ให้ แสดงรายการโมเดลด้วย GET /v1/models หากต้องการลองโมเดลอื่น ให้สลับเป็น zai- และไม่ต้องแก้อะไรอีก: ยอดคงเหลือเดียวครอบคลุมทุกโมเดล
แต่ละบรรทัดทำอะไร#
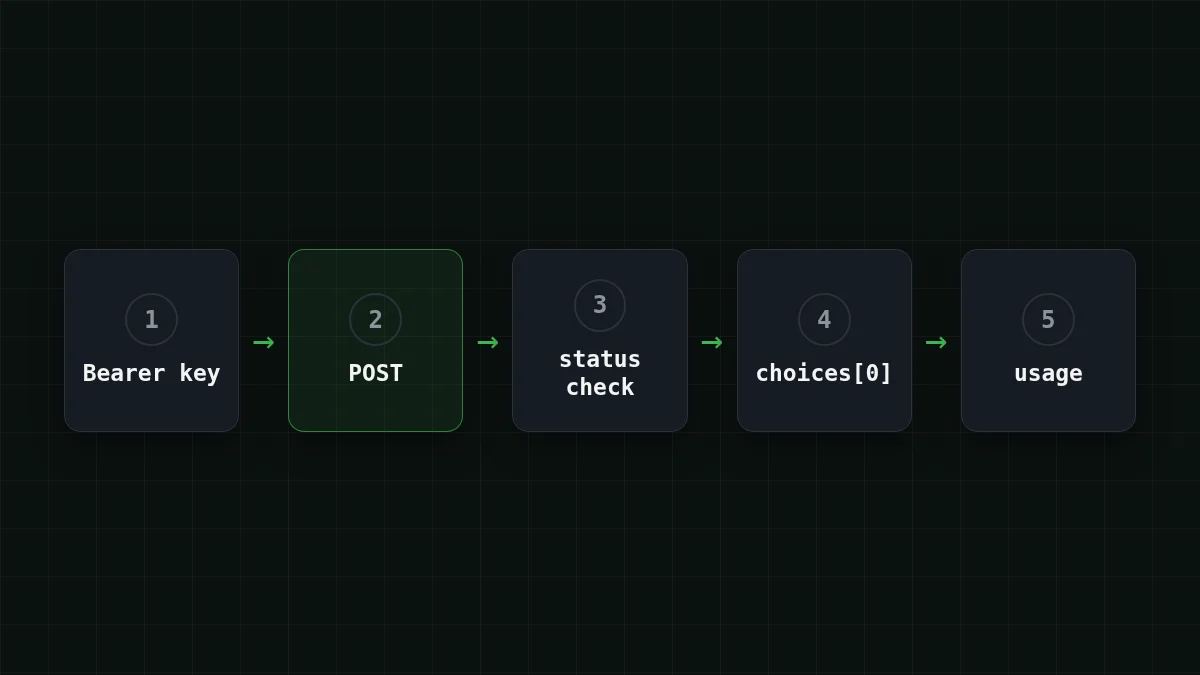
นี่คือห้าแนวคิดที่สคริปต์พึ่งพา Quickstart ของ requests (เอกสารสด ตรวจสอบเมื่อ 2 พฤศจิกายน 2026) อธิบายส่วนใหญ่ไว้ และเอกสารอ้างอิง Chat Completions จาก OpenAI กำหนดฟิลด์ในคำตอบ
แฟลชการ์ด
ห้าสิ่งในสคริปต์
แตะการ์ดเพื่อพลิก
ข้อที่สามคือข้อที่คนมักข้าม สคริปต์ที่ค้างตลอดไปใน cron job แย่กว่าสคริปต์ที่ล้มเหลวอย่างชัดเจนหลัง 30 วินาทีมาก
อ่านคำตอบ#
การตอบกลับที่สำเร็จเป็น JSON ส่วนที่คุณสนใจ ตามเอกสารอ้างอิง Chat Completions:
choices[0].คือข้อความ มันอาจเป็นmessage. content nullดังนั้นอย่าเรียกเมธอดสตริงกับมันแบบไม่ตรวจสอบchoices[0].บอกเหตุผลที่โมเดลหยุด:finish_ reason stop(จบแล้ว),length(ถูกจำกัดด้วยขีดจำกัดmax_tokens),tool_calls,content_filterusage.,prompt_ tokens usage.และcompletion_ tokens usage.คือสิ่งที่คุณถูกเรียกเก็บเงิน: อินพุต เอาต์พุต และผลรวมtotal_ tokens
คำตอบมีรูปแบบนี้ (ตัวเลขเป็นค่าตัวอย่าง):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}ลองด้วยตัวเองลองดู: ตั้ง max_tokens เป็น 5 แล้วรันสคริปต์อีกครั้ง finish_reason บอกว่าอะไร?แสดงคำตอบ
มันบอกว่า length: โมเดลถูกหยุดด้วยขีดจำกัด max_tokens ของคุณ คำตอบจึงจบกลางประโยค เพิ่มขีดจำกัดแล้วคุณจะได้ stop อีกครั้ง เรื่องเต็มอยู่ใน คำตอบ AI ถูกตัด? แก้ finish_reason "length"
เมื่อมันไม่ทำงาน#
สคริปต์เปลี่ยนความล้มเหลวส่วนใหญ่เป็นเอาต์พุตหนึ่งบรรทัด นี่คือสิ่งที่แต่ละอันมักหมายถึง:
จับคู่
จับคู่แต่ละข้อความกับสาเหตุปกติ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- HTTP 401คีย์หาย พิมพ์ผิด หรือไม่ใช่คีย์ที่คุณตั้งใจจะส่ง
- HTTP 404พาธ URL หรือ model id ผิด
- requests.exceptions.Timeoutไม่มีไบต์มาถึงภายใน timeout
- KeyError: 'CHEAPTOKENS_API_KEY'ตัวแปรสภาพแวดล้อมไม่ได้ตั้งค่าในเทอร์มินัลนี้
สำหรับ error body จริงและการตรวจสอบคีย์ base URL และ model id ทีละขั้นตอน ให้ใช้ ข้อผิดพลาด API 401 หรือ 404: คีย์, base URL หรือ model id ผิด กับดักเล็กๆ สองข้อ: หากคุณเห็น KeyError: 'choices' แสดงว่าคุณแยกวิเคราะห์ error body เป็นความสำเร็จ ซึ่งหมายความว่า raise_ ถูกข้ามไป และหากเครื่องของคุณมีไฟล์ ~/.netrc requests อาจใช้ข้อมูลรับรองของไฟล์นั้นแทน header Authorization ที่คุณตั้งไว้
การเรียกหนึ่งครั้งมีค่าใช้จ่ายเท่าไร#
ด้วยตัวเลขตัวอย่างจากคำตอบข้างต้น (ประมาณ 18 โทเค็นอินพุต 52 เอาต์พุต) การเรียก DeepSeek-V4-Flash หนึ่งครั้งมีค่าใช้จ่าย $0.0000055 นั่นเป็นตัวเลขที่คุณรู้สึกไม่ได้ ดังนั้นให้ขยายดู สมมติว่าสคริปต์ของคุณสรุปตั๋วสนับสนุน 1,000 ใบต่อวัน ประมาณ 800 โทเค็นอินพุตและ 300 เอาต์พุตต่อใบ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ราคาคงที่ต่อโมเดล ไม่มีช่วงเวลาเร่งด่วน สคริปต์เดียวกันจึงมีค่าใช้จ่ายเท่ากันตอนตี 3 และตอนเที่ยง ราคาต่อโมเดลปัจจุบันอยู่ในหน้าราคา และเอกสารแสดงรายการ endpoint
ไปต่อจากตรงนี้#
เมื่อสิ่งนี้ทำงานได้ ขั้นตอนถัดไปปกติคือลูปผ่านอินพุตจำนวนมาก การลองใหม่เมื่อ 429 (ดู 429 Too Many Requests: ลองใหม่ด้วย backoff) หรือการเรียกแบบเดียวกันด้วย streaming หากคุณไม่อยากจัดการ HTTP เอง เส้นทาง SDK อยู่ห่างแค่การเปลี่ยน base_url ครั้งเดียว


