API และ SDKคู่มือ
สร้างเครื่องมือ HTML จากพรอมป์เดียวด้วย API (Python)
สคริปต์ Python ที่เปลี่ยนพรอมป์เดียวเป็น tool.html ที่ใช้งานได้ จับคำตอบที่ถูกตัดด้วย finish_reason และพิมพ์โทเคนและค่าใช้จ่าย
ในหน้านี้
คุณสามารถสร้างเครื่องมือไฟล์เดียวที่ใช้งานได้จากการเรียก API เพียงครั้งเดียว: ส่งพรอมป์ที่มีโครงสร้างดี ตรวจสอบว่า max_tokens ใหญ่พอสำหรับทั้งหน้า ตรวจสอบว่า finish_reason เป็น stop และบันทึกคำตอบเป็น tool.html ด้านล่างคือสคริปต์ที่ทำสิ่งนั้น และเทมเพลตพรอมป์ที่คุณปรับใช้กับเครื่องมือของคุณเองได้
แนวคิดเรียบง่าย และ DeepSeek เพิ่งแสดงให้เห็น มันเผยแพร่ชุดพรอมป์ตัวอย่างเจ็ดรายการสำหรับ Creator Mode ใน DeepSeek Harness (หน้าเว็บ ตรวจสอบเมื่อ 3 พฤศจิกายน 2026): แกลเลอรีแลนด์มาร์ก 3D, เวิร์กเบนช์โปสเตอร์, เวิร์กเบนช์ตัดต่อวิดีโอ, ตัวอ่านเปเปอร์, บอร์ดสถิติการสนทนา และอีกสองสามรายการ Creator Mode อยู่ในแอป Harness หากคุณต้องการโฟลว์ "พรอมป์เข้า เครื่องมือออก" แบบเดียวกันในสคริปต์ของคุณเองและด้วยคีย์ของคุณเอง การเรียก chat completion ธรรมดาก็เพียงพอสำหรับกรณีไฟล์เดียว หากคุณใช้ Harness เอง การเชื่อมต่อกับ CheapTokens เป็นคู่มือสั้นแยกต่างหาก
พรอมป์ "สร้างเครื่องมือให้ฉัน" ต้องมีอะไรบ้าง#
อ่านพรอมป์ตัวอย่างเหล่านั้นสักสองสามอันแล้วจะเห็นรูปแบบ แต่ละอันบอกว่าเครื่องมือคืออะไร มีอะไรบนหน้าจอ ตัวควบคุมทำอะไร สถานะเริ่มต้นเป็นอย่างไร และห้ามทำอะไร หากข้ามส่วนใดส่วนหนึ่งไป โมเดลจะเติมช่องว่างด้วยการเดาของตัวเอง ซึ่งมักไม่ใช่สิ่งที่คุณต้องการ
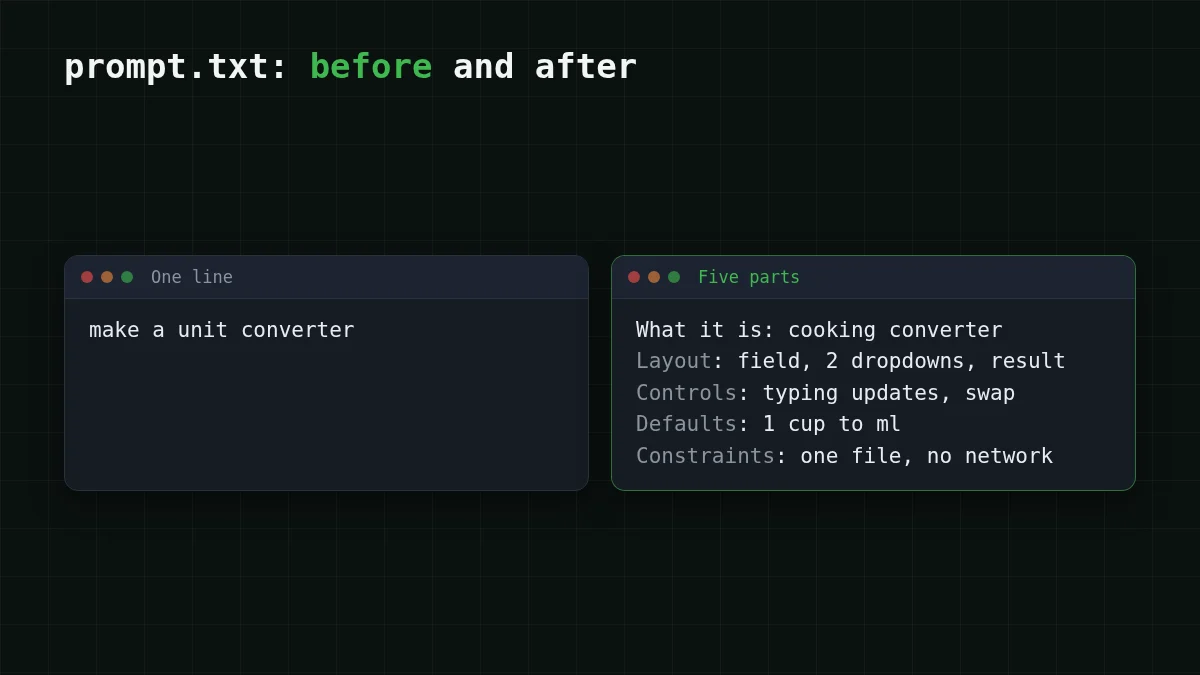
นี่คือเทมเพลต ห้าส่วน:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
และเวอร์ชันที่กรอกแล้ว สมมติว่าคุณแปลงหน่วยตวงอาหารบ่อยและเบื่อกับการค้นหาตัวแปลง:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
บันทึกเป็น prompt.txt ไว้ข้างสคริปต์ บรรทัด "Constraints" แบกน้ำหนักมากที่สุด: หากไม่มี "no external requests" โมเดลมักดึงไลบรารีจาก CDN และหน้าเว็บจะพังเมื่อออฟไลน์
สคริปต์: ส่ง ตรวจสอบ บันทึก#
API ของ CheapTokens เข้ากันได้กับ OpenAI Chat Completions ที่ https:/ ดังนั้นแพ็กเกจ openai ใช้งานได้โดยเปลี่ยนสองอย่าง: base URL และคีย์ สำหรับทั้งหน้าเราใช้ deepseek-: รองรับเอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ และมีหน้าต่างบริบท 380K รายละเอียด API ทั้งหมดอยู่ใน เอกสาร CheapTokens
ติดตั้งแพ็กเกจ ใส่คีย์ในตัวแปรสภาพแวดล้อม และตั้งราคาทั้งสองจาก ตารางราคา (สคริปต์ใช้เพื่อพิมพ์ค่าใช้จ่าย):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
จากนั้น make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
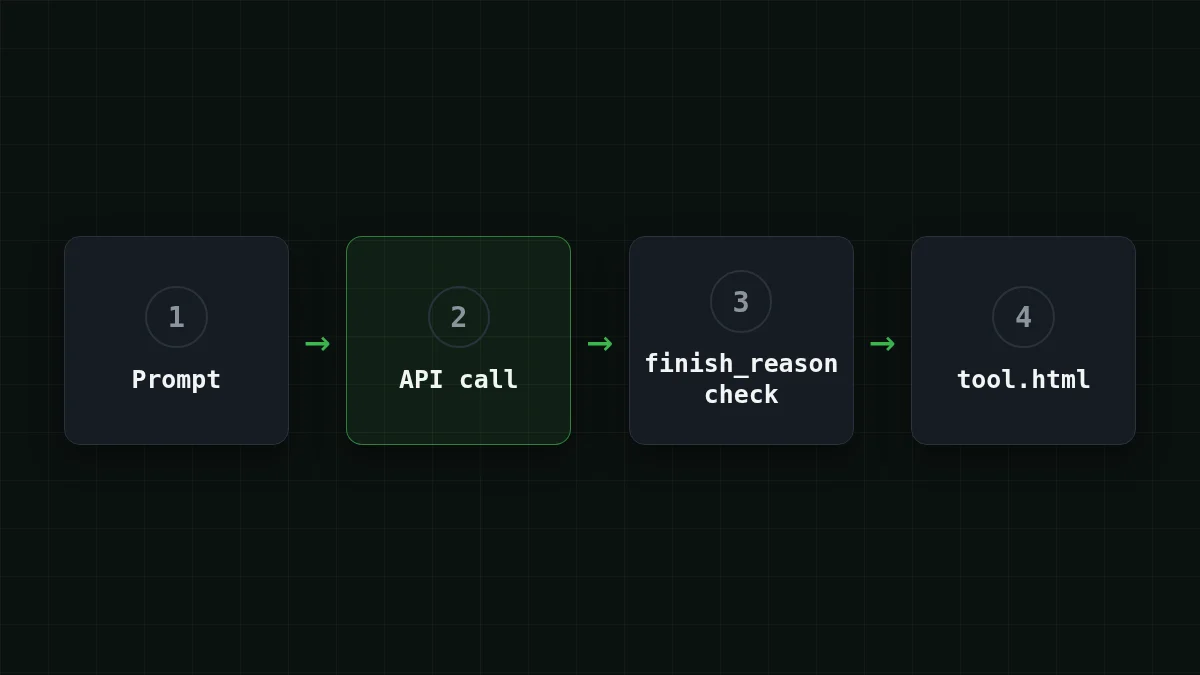
ลำดับขั้นตอนสำคัญ และผิดพลาดได้ง่าย:
เรียงลำดับ
เรียงขั้นตอนของสคริปต์ตามลำดับที่รัน
ลากรายการหรือใช้ลูกศร
- ส่งพรอมป์ด้วย max_tokens ที่เผื่อไว้มาก
- ตรวจสอบ finish_reason ก่อนแตะข้อความ
- ดึง HTML ออกจาก code fence หากมี
- ยืนยันว่ามี </html> ปิดอยู่
- บันทึก tool.html และพิมพ์การใช้งาน
ทำไม max_tokens จึงตัดสินว่าหน้าเว็บใช้งานได้หรือไม่#
หน้าเว็บแบบอินเทอร์แอกทีฟเต็มรูปแบบเป็นคำตอบที่ยาว HTML, CSS และ JavaScript รวมกันเร็ว และโมเดลเขียนตามลำดับนั้น: หากคำตอบถูกตัด คุณจะสูญเสียส่วนท้ายของสคริปต์ก่อน ซึ่งเป็นส่วนที่ทำให้ปุ่มทำงาน เบราว์เซอร์อาจยังเปิดหน้าได้ แต่ก็ไม่ทำอะไรเลย
นั่นคือเหตุผลที่สคริปต์ตรวจสอบ finish_reason ก่อนดูข้อความ stop หมายถึงโมเดลเขียนจบเอง length หมายถึงมันชนเพดาน max_tokens กลางไฟล์ ปัญหานี้ในภาพรวมอธิบายไว้ใน คำตอบ AI ถูกตัด? แก้ finish_reason length; กฎตรงนี้สั้น: อย่าบันทึกหน้าเว็บที่ finish_reason เป็น length
หากคุณเจอ:
- เพิ่ม
max_tokens(DeepSeek-V4-Flash รองรับสูงสุด 32,768 ต่อคำตอบ); - หรือขอให้น้อยลง: ตัวควบคุมน้อยลง หน้าจอเดียว ไม่มีแอนิเมชัน;
- บน GLM-5.3-Flash (
zai-) เพดานคือ 8,192 โทเคนเอาต์พุต ดังนั้นโมเดลนั้นเหมาะกับเครื่องมือเล็กๆ เช่นตัวแปลงข้างต้นorg/ GLM- 5. 3- Flash
การตรวจสอบที่สอง </html> ในข้อความ จับความล้มเหลวที่เงียบกว่า เมื่อโมเดลจบคำตอบอย่างสุภาพโดยไม่เขียนไฟล์ให้เสร็จ การตั้ง max_tokens ก็ไม่ได้ทำให้โมเดลเขียนมากขึ้น: มันเป็นเพียงเพดาน และคุณจ่ายตามโทเคนที่ผลิตจริง (เพิ่มเติมใน ลดโทเคนเอาต์พุต)
เช็กด่วน
สคริปต์พิมพ์ finish_reason = length คุณจะทำอย่างไร?
แสดงคำตอบ
คำตอบ: ไม่บันทึก เพิ่ม max_tokens หรือลดคำขอ
length หมายถึงคำตอบถูกตัดที่เพดาน ส่วนท้ายของสคริปต์จึงหายไป เพดานที่ต่ำลงทำให้ถูกตัดเร็วขึ้น
เปิดและดูหน้าเว็บ#
เปิด tool.html โดยดับเบิลคลิก หรือจากเทอร์มินัล: open tool.html บน macOS, xdg- บน Linux, start tool.html บน Windows
นี่คือโค้ดที่โมเดลเขียนให้คุณ ดังนั้นใช้เวลาสักครู่ก่อนเชื่อถือ เปิดเครื่องมือนักพัฒนาเบราว์เซอร์ (F12) ดูแท็บ Network แล้วโหลดใหม่: ด้วยข้อจำกัด "no external requests" มันควรว่างเปล่า จากนั้นคลิกตัวควบคุมทุกตัวจากส่วน "Controls" ในพรอมป์ของคุณหนึ่งครั้ง
หากมีอะไรผิด อย่าสร้างใหม่ทั้งหมด เพิ่มหนึ่งประโยคในพรอมป์เกี่ยวกับสิ่งนั้นโดยเฉพาะ ("ปุ่มสลับต้องสลับค่าทั้งสองด้วย") แล้วรันอีกครั้ง หน้าเว็บของ DeepSeek เองระบุว่าตัวอย่างบางส่วนถูกปรับแต่งหลายรอบการสนทนา ดังนั้นการทำรอบสองเป็นเรื่องปกติ
ลองด้วยตัวเองลองดู: คุณคาดว่าจะเห็นอะไรในแท็บ Network สำหรับตัวแปลง?แสดงคำตอบ
ไม่มีอะไร: หน้าเว็บเป็นไฟล์เดียวที่มี CSS และ JavaScript แบบอินไลน์ ดังนั้นหลังโหลดครั้งแรกจะไม่มีคำขอเพิ่มเติม หากเห็นคำขอไปยัง CDN แสดงว่าโมเดลเพิกเฉยต่อข้อจำกัด; เพิ่มมันในพรอมป์ด้วยตัวพิมพ์ใหญ่แล้วรันอีกครั้ง
การสร้างหนึ่งครั้งมีค่าใช้จ่ายเท่าไร#
สมมติพรอมป์มีอินพุตประมาณ 600 โทเคน และหน้าเว็บที่เสร็จแล้วมีเอาต์พุตประมาณ 6,000 โทเคน (สมมติฐานสำหรับเครื่องมือขนาดกลาง บรรทัด usage ของคุณจะแสดงตัวเลขจริง) หนึ่งรอบบน DeepSeek-V4-Flash คือ $0.00061 และบน GLM-5.3-Flash $0.00025 ทั้งคู่เป็นตัวเลขสดจากรายการราคาปัจจุบัน และโดยรวมเมื่อนับอินพุตและเอาต์พุตรวมกัน ทั้งคู่ถูกกว่า OpenRouter
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 โทเค็นอินพุตและ 6,000 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ในทางปฏิบัติคุณจะไม่ได้เครื่องมือถูกต้องในการลองครั้งแรก ดังนั้นคิดเป็นรอบ: ปรับพรอมป์สิบคืือสิบคูณบรรทัดนั้น ยังเป็นจำนวนเล็กน้อยสำหรับเครื่องมือที่คุณคงต้องเขียนเอง เกือบทั้งหมดเป็นฝั่งเอาต์พุต คือตัวหน้าเว็บเอง ซึ่งเป็นเหตุผลที่การลดคำขอ (ตัวควบคุมน้อยลง) ทำให้คำตอบและค่าใช้จ่ายสั้นลง
หากใช้งานไม่ได้#
เลื่อนตารางไปทางขวา →
| สิ่งที่เห็น | สาเหตุที่เป็นไปได้ | สิ่งที่ต้องทำ |
|---|---|---|
401 หรือ 404 จาก API |
คีย์, base URL หรือ model id ผิด | ตรวจสอบทั้งสาม ดู ข้อผิดพลาด API 401 หรือ 404 |
Cut off at max_ |
หน้ายาวเกินเพดาน | เพิ่ม max_tokens หรือขอให้น้อยลง |
The reply has no closing </ |
โมเดลหยุดเร็วหรือเพิ่มข้อความ | รันอีกครั้ง; เพิ่ม "end with </html>" ในพรอมป์ |
| หน้าเว็บเปิดแต่ปุ่มไม่ทำงาน | ข้อผิดพลาด JavaScript | เปิดคอนโซล (F12) วางข้อผิดพลาดสีแดงในพรอมป์ติดตาม |
หากคุณต้องการแยกวิเคราะห์คำตอบของโมเดลเป็นข้อมูลแทนหน้าเว็บ เคล็ดลับการดึงข้อมูลเหมือนกับใน json.JSONDecodeError ในคำตอบ LLM เพิ่งเริ่มใช้ API? เริ่มที่ คำขอ API ครั้งแรกของคุณ


