การลดต้นทุนคู่มือ
ลดเอาต์พุตโทเคน: ความยาวคำตอบ, max_tokens, stop sequences
ย่อคำตอบ AI ตั้งแต่การออกแบบ: ขอรูปแบบที่มีขอบเขต เก็บ max_tokens เป็นเพดาน ใช้ stop sequences แล้วดูค่าใช้จ่ายของ 1,000 คำขอ
ในหน้านี้
บอทของคุณตอบด้วย 400 โทเคนทั้งที่ 100 ก็เพียงพอ และคุณจ่ายสำหรับทุกโทเคน วิธีแก้ส่วนใหญ่อยู่ที่พรอมต์: ขอรูปแบบที่มีขอบเขต เก็บ max_tokens ไว้เป็นเพดานความปลอดภัยแทนที่จะเป็นปุ่มปรับความยาว และตรวจสอบ usage. เพื่อดูว่าจริง ๆ แล้วได้อะไรกลับมา
เรื่องนี้สำคัญเพราะเอาต์พุตเป็นฝั่งที่แพงกว่าสำหรับทุกโมเดลที่เราให้บริการ ดูราคาแบบเรียลไทม์ได้ที่ หน้าราคา คำถามเดิม คำตอบสั้นลง บิลเล็กลง
เริ่มที่พรอมต์ ไม่ใช่ที่ลิมิต#
สมมติคุณดูแลบอทซัพพอร์ตที่มีตั๋ว 2,000 ใบต่อวัน แต่ละตั๋วต้องมีหมวดหมู่และเหตุผลหนึ่งประโยค ถ้าปล่อยให้โมเดลเขียนเอง มันจะเขียนย่อหน้าอบอุ่น รายการข้อควรระวัง และข้อเสนอที่จะช่วยเพิ่มเติม นั่นคือที่ที่ 400 โทเคนหายไป
เปรียบเทียบ
ตั๋วเดียวกัน สองพรอมต์
แบบเปิดกว้าง
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: ย่อหน้าที่มีคำทักทาย คำอธิบาย และข้อเสนอที่จะช่วย (ประมาณ 400 โทเคน)
แบบมีขอบเขต
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: ตั๋วเดิม
Answer: billing และเหตุผลสั้น ๆ (ประมาณ 100 โทเคนหรือน้อยกว่า)
เคล็ดลับคือคุณอธิบายรูปร่างของคำตอบ: จำนวนบรรทัด รายการป้ายกำกับแบบปิด ขีดจำกัดคำ "เขียนสั้น ๆ" ได้ผลแย่กว่า "สองบรรทัด 15 คำ" เพราะโมเดลมีอะไรที่ konkret ให้ นับ ถ้าคุณต้องการแค่ป้ายกำกับ ก็ขอแค่ป้ายกำกับและอย่างอื่นไม่ต้อง ตัวจำแนกที่ต้องคืนค่า billing ไม่ควรได้รับอนุญาตให้อธิบายตัวเอง
เช่นเดียวกันกับการสกัด JSON เมื่อโมเดลห่อ JSON ของคุณด้วยข้อความ ข้อความนั้นคือเอาต์พุตที่คุณจ่ายแล้วก็ทิ้งไป ใส่ "Return only the JSON object, no text before or after it" ไว้ในข้อความระบบ สำหรับการแยกวิเคราะห์สิ่งที่ได้กลับมา ดู วิธีสกัด JSON จากคำตอบ LLM
max_tokens คือเข็มขัดนิรภัย#
มันน่าล่อใจที่จะตั้ง max_tokens: 100 แล้วบอกว่าจบ อย่าคาดหวังคำตอบสั้นจากมัน เอกสารอ้างอิง API ของ DeepSeek (ตรวจสอบเมื่อ 2 พฤศจิกายน 2026) อธิบาย max_tokens ว่าเป็นจำนวนโทเคนสูงสุดที่สามารถสร้างได้ในคอมพลีชัน โดยอินพุตบวกเอาต์พุตถูกจำกัดด้วยความยาวคอนเท็กซ์ของโมเดล มันหยุดการสร้าง ไม่ได้ทำให้โมเดลวางแผนคำตอบที่สั้นลง
ดังนั้นโมเดลที่อยากเขียน 400 โทเคนแต่ได้ 100 จะส่งประโยคที่จบกลางคันมาให้คุณ finish_reason ถูกตั้งเป็น length และบิลสำหรับทั้ง 100 โทเคน คุณจ่ายสำหรับคำตอบที่ใช้ไม่ได้ สาเหตุที่เกิดขึ้นและวิธีซ่อมแซมอยู่ใน ทำไมคำตอบ AI หยุดกลางประโยค และ วิธีแก้ finish_reason "length" ผมจะไม่พูดซ้ำที่นี่
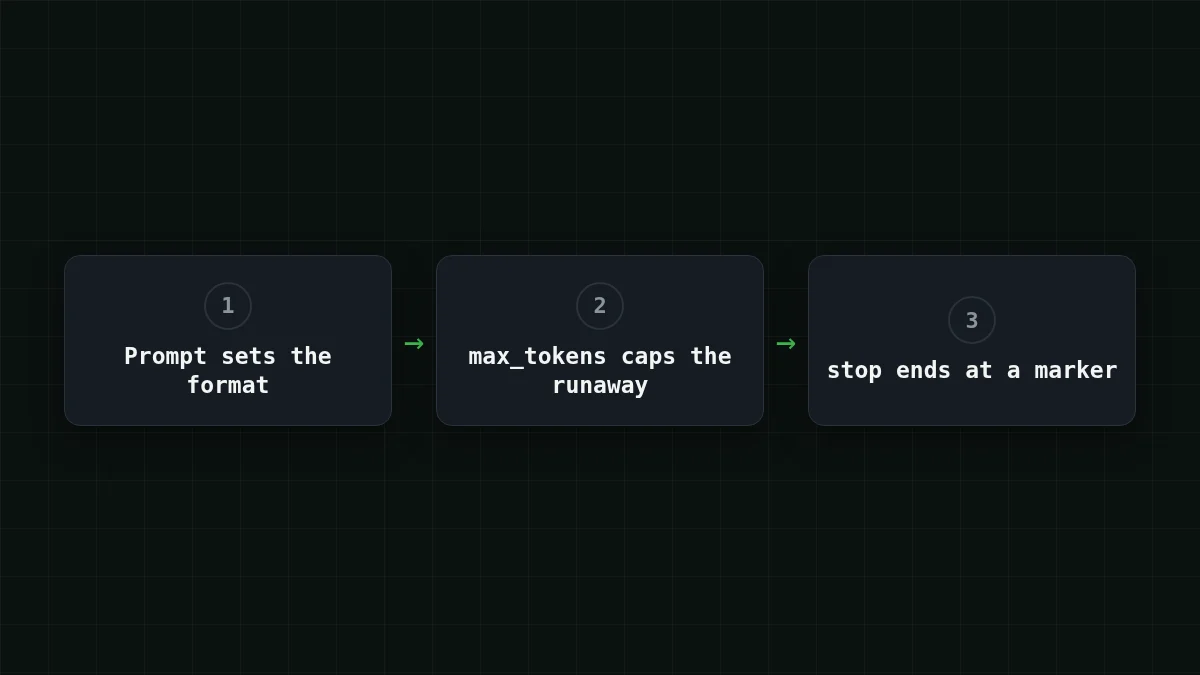
การแบ่งงานที่ได้ผลนั้นง่าย:
- พรอมต์กำหนดว่าคำตอบที่ดีควรยาวแค่ไหน;
max_tokensอยู่สูงกว่าคำตอบที่ดีที่ยาวที่สุดเล็กน้อย เพื่อให้คำตอบที่หลุดการควบคุมถูกตัดแทนที่จะโตไปถึงขีดจำกัดเอาต์พุตของโมเดล (สูงสุด 32,768 โทเคนบน DeepSeek-V4-Flash)
สำหรับคำตอบตั๋วสองบรรทัด 150 ก็เพียงพอ สำหรับป้ายกำกับคำเดียว 20
Stop sequences ยุติคำตอบที่เครื่องหมาย#
ในเอกสารอ้างอิงของ DeepSeek stop รับได้สูงสุด 16 ลำดับ และการสร้างจะหยุดเมื่อโมเดลกำลังจะสร้างลำดับใดลำดับหนึ่ง เมื่อเกิดขึ้น finish_reason จะเป็น stop เหมือนกับการจบตามธรรมชาติ สิ่งนี้มีประโยชน์เมื่อรูปแบบของคุณมีเครื่องหมายสิ้นสุด ขอคำตอบ แล้วตามด้วยบรรทัดที่มี END และใส่ END ใน stop ทดสอบสักครั้งบนเซ็ตอัปของคุณเอง: เรียกหนึ่งครั้งและตรวจสอบว่า finish_reason เป็น stop และข้อความจบก่อนเครื่องหมาย
กฎข้อหนึ่ง: ข้อความ stop ต้องเป็นสิ่งที่ไม่มีทางปรากฏในคำตอบที่ดี การ stop ที่ \n\n จะตัดคำตอบสองย่อหน้าหลังย่อหน้าแรก
คำขอที่คุณรันและวัดได้#
นี่คือการเรียกตั๋วแบบมีขอบเขต รหัสโมเดลคือ gateway_id แบบเต็มจากเอกสาร CheapTokens และ base URL คือ https:/ เอกสาร แสดงวิธีสร้างคีย์ ใส่ไว้ในตัวแปรสภาพแวดล้อม
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
ในคำตอบ มีสองสิ่งสำคัญ: choices[0]. และออบเจกต์ usage ที่มี prompt_tokens และ completion_ ใน Python ด้วยแพ็กเกจ openai จะมีลักษณะดังนี้:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
รันกับตั๋วจริงสิบบันทึกก่อนที่คุณจะเชื่อรูปแบบ ถ้า completion_ ยังเล็กและ finish_reason เป็น stop เสมอ แสดงว่าพรอมต์ทำงาน ถ้าคุณเห็น length แสดงว่าเพดานของคุณต่ำกว่าที่คำตอบที่ดีต้องการ: เพิ่มมันหรือกระชับพรอมต์ ไม่ใช่ทั้งสองอย่างแบบสุ่มสี่สุ่มห้า
จับคู่
ฟิลด์บอกอะไรคุณ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- lengthถึงขีดจำกัด max_tokens แล้ว
- stopจุดหยุดตามธรรมชาติหรือ stop sequence
- usage.completion_tokensโทเคนในคำตอบ ฝั่งเอาต์พุตของบิลคุณ
ถ้า finish_reason ไม่ใช่ stop ให้ดูลิมิตก่อน
ประหยัดได้เท่าไรกับ 1,000 คำขอ#
ตอนนี้มาดูบิล สมมติว่าตั๋วบวกคำแนะนำคือ 300 อินพุตโทเคน คำตอบแบบเปิดกว้างคือ 400 เอาต์พุตโทเคน และแบบมีขอบเขตคือ 100 นี่คือสมมติฐานสำหรับตัวอย่าง เปลี่ยนเป็นตัวเลขจาก usage ของคุณเอง ใน 1,000 คำขอ นั่นคือ 300 × 1,000 = 300,000 อินพุตโทเคนในทั้งสองกรณี และ 400 × 1,000 = 400,000 เอาต์พุตโทเคนเทียบกับ 100 × 1,000 = 100,000
คำตอบแบบเปิดกว้าง 1,000 คำขอ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 โทเค็นอินพุตและ 400 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
คำตอบแบบมีขอบเขต 1,000 คำขอ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 โทเค็นอินพุตและ 100 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ฝั่งอินพุตไม่ขยับ และนั่นคือประเด็น: เฉพาะส่วนที่คุณย่อให้สั้นลงเท่านั้นที่ถูกลง และมันคือส่วนที่มีราคาสูงกว่า ต่อโมเดล ตั๋ว 1,000 ใบเดียวกันมีค่าใช้จ่าย $0.0445 แบบเปิดกว้างและ $0.0145 แบบมีขอบเขตบน DeepSeek-V4-Flash โดยรวมเมื่อนับอินพุตและเอาต์พุตรวมกัน ทั้งสามโมเดลในตารางออกมาถูกกว่าราคาอ้างอิงของ OpenRouter สำหรับคำตอบสั้น เลือกโมเดลจากตารางด้านบน: เปรียบเทียบแถวสำหรับอินพุตและเอาต์พุตของคุณเอง GLM-5.3-Flash ($0.04 ต่อ 1M เอาต์พุตโทเคน) เหมาะกับที่ที่คำตอบยาวกว่า สูงสุด 8,192 โทเคน หน้า DeepSeek มีส่วนที่เหลือ
ลำดับที่ผมจะใช้สิ่งนี้#
เรียงลำดับ
เรียงขั้นตอนให้สมเหตุสมผล
ลากรายการหรือใช้ลูกศร
- เขียนรูปแบบคำตอบลงในพรอมต์
- ตั้ง max_tokens สูงกว่าคำตอบที่ดีที่ยาวที่สุดเล็กน้อย
- ถ้า API รองรับ stop และรูปแบบมีเครื่องหมายสิ้นสุด ให้เพิ่ม stop sequence
- บันทึก completion_tokens และ finish_reason สำหรับทุกการเรียก
- เปรียบเทียบค่าใช้จ่ายของแบตช์ 1,000 คำขอก่อนและหลัง
ขั้นตอนที่ 4 คือขั้นตอนที่คนข้าม โดยไม่มีมันคุณไม่รู้ว่าการเปลี่ยนพรอมต์ได้ผลหรือมีคำตอบยาว ๆ สองสามอันดึงค่าเฉลี่ยขึ้น ถ้าคุณติดตามค่าใช้จ่ายอยู่แล้ว วิธีนับโทเคนใน Python และ อินพุตเทียบกับเอาต์พุตโทเคน เป็นจุดที่ดีในการไปต่อ


