KostenoptimierungAnleitung
Ausgabe-Tokens kürzen: Antwortlänge, max_tokens, Stop-Sequenzen
KI-Antworten by design verkürzen: Verlange ein begrenztes Format, behandle max_tokens als Grenze, nutze Stop-Sequenzen und sieh dir dann die Kosten von 1.000 Anfragen an.
Auf dieser Seite
Dein Bot antwortet mit 400 Tokens, wo 100 reichen würden, und du zahlst für jeden einzelnen davon. Die Lösung liegt größtenteils im Prompt: Verlange ein begrenztes Format, behandle max_tokens als Sicherheitsgrenze statt als Längenregler, und prüfe usage., um zu sehen, was tatsächlich zurückkam.
Das ist wichtig, weil die Ausgabe bei jedem Modell, das wir anbieten, die teurere Seite ist: Sieh dir die aktuellen Preise auf der Preisseite an. Gleiche Frage, kürzere Antwort, kleinere Rechnung.
Fang mit dem Prompt an, nicht mit dem Limit#
Angenommen, du betreibst einen Support-Bot mit 2.000 Tickets pro Tag. Jedes Ticket braucht eine Kategorie und einen Satz Begründung. Das Modell schreibt, sich selbst überlassen, einen freundlichen Absatz, eine Liste von Einschränkungen und ein Angebot, weiterzuhelfen. Dort gehen die 400 Tokens hin.
Vergleichen
Gleiches Ticket, zwei Prompts
Offen
System: Du bist ein hilfreicher Support-Assistent. User: Sag mir, um welche Art von Ticket es sich handelt: "Meine Karte wurde für Bestellung 1182 doppelt belastet." Antwort: ein Absatz mit Begrüßung, Erklärung und einem Angebot zu helfen (etwa 400 Tokens).
Begrenzt
System: Antworte mit genau zwei Zeilen. Zeile 1: die Kategorie, eine von billing, bug, other. Zeile 2: eine Begründung in höchstens 15 Wörtern. Keine Begrüßung.
User: dasselbe Ticket.
Antwort: billing und eine kurze Begründung (etwa 100 Tokens oder weniger).
Der Trick ist, dass du die Form der Antwort beschreibst: Anzahl der Zeilen, eine geschlossene Liste von Labels, ein Wortlimit. "Sei kurz" funktioniert schlechter als "zwei Zeilen, 15 Wörter", weil das Modell etwas Konkretes zum Zählen hat. Wenn du nur ein Label brauchst, verlange das Label und sonst nichts. Ein Klassifikator, der billing zurückgeben muss, sollte sich nicht erklären dürfen.
Dasselbe gilt für die JSON-Extraktion. Wenn das Modell dein JSON in Prosa einwickelt, ist die Prosa Ausgabe, die du bezahlst und dann wegwirfst. Setze "Gib nur das JSON-Objekt zurück, kein Text davor oder danach" in die Systemnachricht. Zum Parsen dessen, was zurückkommt, siehe wie man JSON aus einer LLM-Antwort extrahiert.
max_tokens ist ein Sicherheitsgurt#
Es ist verlockend, max_tokens: 100 zu setzen und die Sache als erledigt zu betrachten. Erwarte davon keine kurzen Antworten. Die API-Referenz von DeepSeek (geprüft am 2. November 2026) beschreibt max_tokens als die maximale Anzahl von Tokens, die in der Completion generiert werden können, wobei Eingabe plus Ausgabe durch die Kontextlänge des Modells begrenzt sind. Es stoppt die Generierung. Es bringt das Modell nicht dazu, eine kürzere Antwort zu planen.
Ein Modell, das 400 Tokens schreiben wollte und 100 bekommt, liefert dir also einen Satz, der mittendrin endet, finish_reason auf length gesetzt, und eine Rechnung für alle 100 Tokens. Du hast für eine Antwort bezahlt, die du nicht verwenden kannst. Warum das passiert und wie man es repariert, steht in warum eine KI-Antwort mitten im Satz aufhört und dem Fix für finish_reason "length". Ich wiederhole es hier nicht.
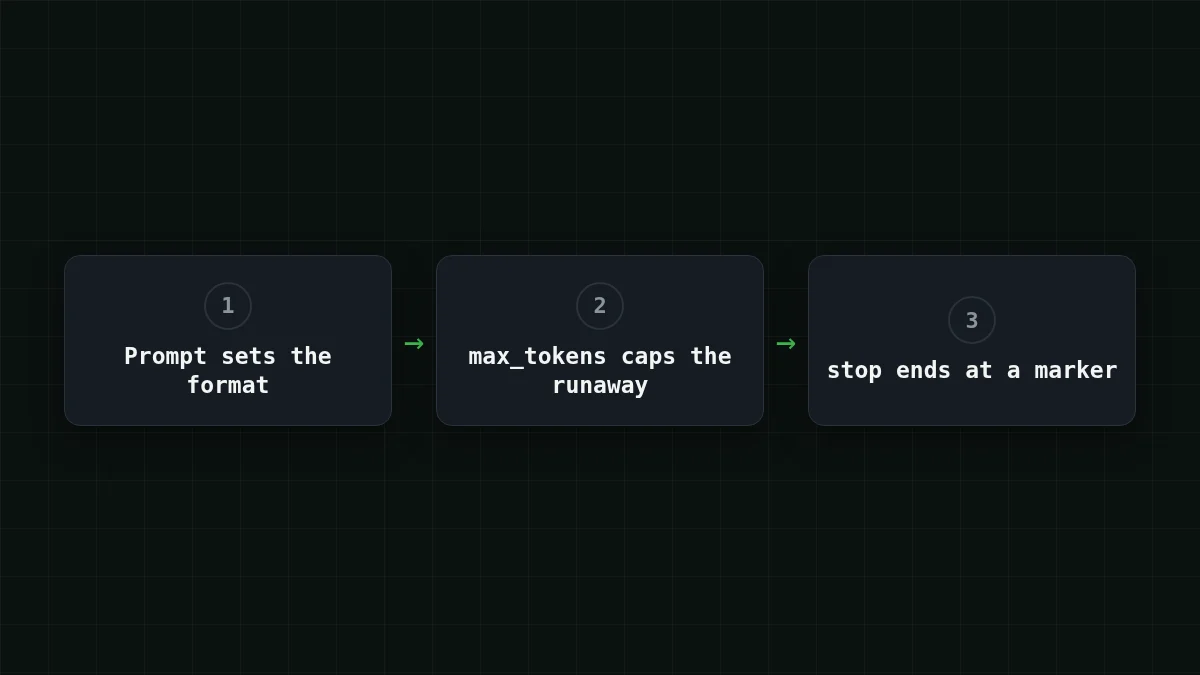
Die funktionierende Aufteilung ist einfach:
- der Prompt entscheidet, wie lang eine gute Antwort ist;
max_tokensliegt etwas über der längsten guten Antwort, damit eine ausufernde Antwort abgeschnitten wird, statt bis zum Ausgabelimit des Modells zu wachsen (bis zu 32.768 Tokens bei DeepSeek-V4-Flash).
Für die zweizeilige Ticket-Antwort reichen 150. Für ein Ein-Wort-Label 20.
Stop-Sequenzen beenden eine Antwort an einem Marker#
In der Referenz von DeepSeek nimmt stop bis zu 16 Sequenzen, und die Generierung hält an, wenn das Modell eine davon produzieren würde. Wenn das passiert, ist finish_reason gleich stop, genau wie bei einem natürlichen Ende. Das ist praktisch, wenn dein Format einen Endmarker hat. Verlange die Antwort, dann eine Zeile mit END, und setze END in stop. Teste es einmal mit deinem eigenen Setup: Mach einen Aufruf und prüfe, dass finish_reason gleich stop ist und der Text vor dem Marker endet.
Eine Regel: Der Stop-Text muss etwas sein, das nicht innerhalb einer guten Antwort vorkommen kann. Ein Stop auf \n\n schneidet eine zweiphasige Antwort nach dem ersten Absatz ab.
Eine Anfrage, die du ausführen und messen kannst#
Hier ist der begrenzte Ticket-Aufruf. Die Modell-ID ist die vollständige gateway_id aus der CheapTokens-Doku, und die Basis-URL ist https:/. Die Doku zeigt, wie man einen Schlüssel erstellt; lege ihn in eine Umgebungsvariable.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
In der Antwort zählen zwei Dinge: choices[0]. und das usage-Objekt mit prompt_tokens und completion_. In Python mit dem openai-Paket sieht das so aus:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Führe es mit zehn echten Tickets aus, bevor du dem Format vertraust. Wenn completion_ klein bleibt und finish_reason immer stop ist, erledigt der Prompt die Arbeit. Wenn du length siehst, liegt deine Grenze unter dem, was eine gute Antwort braucht: Erhöhe sie oder verschärfe den Prompt, nicht beides blind.
Paare zuordnen
Was die Felder dir sagen
Tippe auf ein Element links, dann auf sein Paar
- lengthDas max_tokens-Limit wurde erreicht
- stopEin natürlicher Stopppunkt oder eine Stop-Sequenz
- usage.completion_tokensDie Tokens in der Antwort, die Ausgabeseite deiner Rechnung
Wenn finish_reason nicht stop ist, schau zuerst auf das Limit.
Was es bei 1.000 Anfragen spart#
Jetzt die Rechnung. Angenommen, ein Ticket plus Anweisungen sind 300 Eingabe-Tokens, die offene Antwort ist 400 Ausgabe-Tokens und die begrenzte 100. Das sind Annahmen für das Beispiel; setze die Zahlen aus deinem eigenen usage ein. Über 1.000 Anfragen sind das in beiden Fällen 300 × 1.000 = 300.000 Eingabe-Tokens und 400 × 1.000 = 400.000 Ausgabe-Tokens gegenüber 100 × 1.000 = 100.000.
Offene Antworten, 1.000 Anfragen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 Input- und 400 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Begrenzte Antworten, 1.000 Anfragen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 Input- und 100 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Eingabeseite bewegt sich nicht, und das ist der Punkt: Nur der Teil, den du verkürzt hast, wird günstiger, und das ist der Teil mit dem höheren Preis. Pro Modell kosten dieselben 1.000 Tickets $0.0445 offen und $0.0145 begrenzt bei DeepSeek-V4-Flash. Insgesamt, mit Eingabe und Ausgabe zusammen gerechnet, sind alle drei Modelle in den Tabellen günstiger als der Referenzpreis von OpenRouter. Für kurze Antworten wähle das Modell aus den Tabellen oben: Vergleiche die Zeilen für deine eigene Eingabe und Ausgabe. GLM-5.3-Flash ($0.04 pro 1M Ausgabe-Tokens) passt, wo Antworten länger bleiben, bis zu 8.192 Tokens; die DeepSeek-Seite hat den Rest.
Die Reihenfolge, in der ich das anwenden würde#
In die richtige Reihenfolge bringen
Bringe die Schritte in eine sinnvolle Reihenfolge
Ziehe die Elemente oder benutze die Pfeile
- Schreibe das Antwortformat in den Prompt
- Setze max_tokens etwas über die längste gute Antwort
- Wenn die API stop akzeptiert und das Format einen Endmarker hat, füge eine Stop-Sequenz hinzu
- Logge completion_tokens und finish_reason für jeden Aufruf
- Vergleiche die Kosten eines Batches von 1.000 Anfragen vorher und nachher
Schritt 4 ist der, den die Leute überspringen. Ohne ihn weißt du nicht, ob die Prompt-Änderung funktioniert hat oder ob ein paar lange Antworten den Durchschnitt nach oben ziehen. Wenn du deine Ausgaben bereits verfolgst, sind der Token-Zähl-Ansatz in Python und Eingabe- vs. Ausgabe-Tokens ein guter Ort zum Weitermachen.


