খরচ অপ্টিমাইজেশনগাইড
আউটপুট টোকেন কমান: উত্তরের দৈর্ঘ্য, max_tokens, স্টপ সিকোয়েন্স
ডিজাইন অনুযায়ী AI উত্তর সংক্ষিপ্ত করুন: একটি সীমাবদ্ধ ফরম্যাট চান, max_tokens সীমা হিসেবে রাখুন, স্টপ সিকোয়েন্স ব্যবহার করুন, তারপর ১,০০০ অনুরোধের খরচ দেখুন।
এই পৃষ্ঠায়
আপনার বট ৪০০ টোকেনে উত্তর দেয় যখন ১০০ টোকেনেই যথেষ্ট, আর আপনি প্রতিটির জন্য অর্থ দেন। সমাধান মূলত প্রম্পটেই: একটি সীমাবদ্ধ ফরম্যাট চান, max_tokens-কে দৈর্ঘ্য নিয়ন্ত্রণের বদলে নিরাপত্তা সীমা হিসেবে রাখুন, এবং আসলে কী ফিরে এসেছে তা দেখতে usage. পরীক্ষা করুন।
এটি গুরুত্বপূর্ণ কারণ আমরা যে সব মডেল অফার করি, প্রতিটিতেই আউটপুট বেশি দামি: প্রাইসিং পেজে লাইভ দাম দেখুন। একই প্রশ্ন, ছোট উত্তর, কম বিল।
সীমা দিয়ে নয়, প্রম্পট দিয়ে শুরু করুন#
ধরুন আপনি একটি সাপোর্ট বট চালান যেখানে দিনে ২,০০০ টিকিট আসে। প্রতিটি টিকিটের জন্য একটি ক্যাটাগরি এবং এক বাক্যের কারণ দরকার। মডেলকে একা ছেড়ে দিলে সে একটি বন্ধুত্বপূর্ণ প্যারাগ্রাফ, সতর্কতার তালিকা এবং আরও সাহায্যের প্রস্তাব লেখে। এখানেই ৪০০ টোকেন খরচ হয়।
তুলনা করুন
একই টিকিট, দুটি প্রম্পট
খোলা-প্রান্ত
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: a paragraph with a greeting, an explanation and an offer to help (around 400 tokens).
সীমাবদ্ধ
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: the same ticket.
Answer: billing এবং একটি সংক্ষিপ্ত কারণ (প্রায় ১০০ টোকেন বা কম)।
কৌশলটি হলো আপনি উত্তরের আকৃতি বর্ণনা করেন: লাইনের সংখ্যা, লেবেলের একটি বদ্ধ তালিকা, শব্দের সীমা। "সংক্ষিপ্ত হোন"-এর চেয়ে "দুই লাইন, ১৫ শব্দ" ভালো কাজ করে, কারণ মডেলের কাছে গণনা করার মতো নির্দিষ্ট কিছু থাকে। যদি আপনার শুধু একটি লেবেল দরকার হয়, তাহলে লেবেলটিই চান, আর কিছু নয়। যে ক্লাসিফায়ারকে billing ফেরত দিতে হবে, তাকে নিজের ব্যাখ্যা দেওয়ার সুযোগ দেওয়া উচিত নয়।
একই কথা JSON এক্সট্র্যাকশনের ক্ষেত্রেও প্রযোজ্য। যখন মডেল আপনার JSON-কে গদ্যের ভেতরে মুড়ে দেয়, সেই গদ্য হলো আউটপুট যার জন্য আপনি অর্থ দেন এবং তারপর ফেলে দেন। সিস্টেম মেসেজে লিখুন "Return only the JSON object, no text before or after it"। ফিরে আসা জিনিস পার্স করার জন্য দেখুন কীভাবে একটি LLM উত্তরের থেকে JSON বের করবেন।
max_tokens হলো সিটবেল্ট#
max_tokens: 100 সেট করে কাজ শেষ বলে ভাবা সহজ। এটি থেকে সংক্ষিপ্ত উত্তর আশা করবেন না। DeepSeek-এর API রেফারেন্স (২ নভেম্বর ২০২৬-এ যাচাইকৃত) max_tokens-কে কমপ্লিশনে উৎপন্ন হতে পারে এমন সর্বোচ্চ টোকেন সংখ্যা হিসেবে বর্ণনা করে, যেখানে ইনপুট ও আউটপুট মিলে মডেলের কনটেক্সট দৈর্ঘ্য দ্বারা সীমাবদ্ধ। এটি জেনারেশন থামায়। এটি মডেলকে ছোট উত্তর পরিকল্পনা করতে বাধ্য করে না।
তাই যে মডেল ৪০০ টোকেন লিখতে চেয়েছিল এবং ১০০ পেয়েছে, সে আপনাকে একটি বাক্য দেয় যা মাঝখানে শেষ হয়, finish_reason-কে length-এ সেট করা থাকে, এবং সব ১০০ টোকেনের বিল দেয়। আপনি এমন উত্তরের জন্য অর্থ দিলেন যা ব্যবহার করতে পারবেন না। কেন এটি ঘটে এবং কীভাবে ঠিক করবেন তা কেন একটি AI উত্তর মাঝবাক্যে থেমে যায় এবং finish_reason "length" সমাধান-এ আলোচনা করা হয়েছে। আমি এখানে পুনরাবৃত্তি করব না।
কার্যকর বিভাজনটি সহজ:
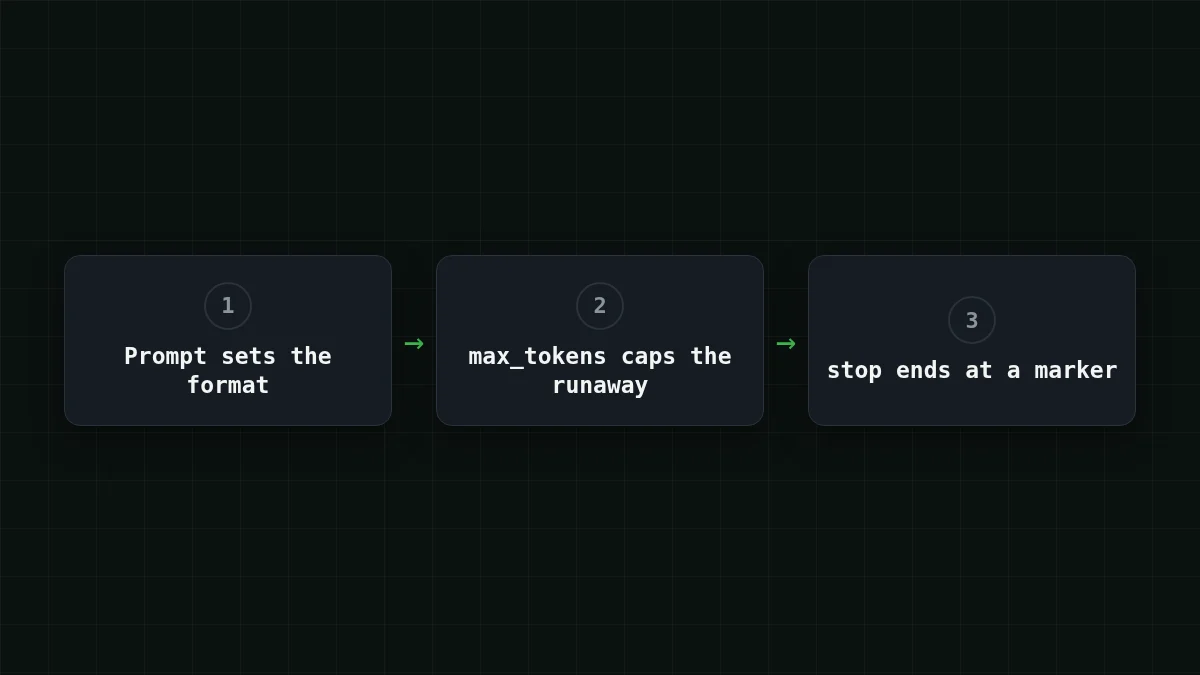
- প্রম্পট নির্ধারণ করে একটি ভালো উত্তর কত দীর্ঘ হবে;
max_tokensদীর্ঘতম ভালো উত্তরের কিছুটা উপরে থাকে, যাতে একটি অনিয়ন্ত্রিত উত্তর মডেলের আউটপুট সীমা (DeepSeek-V4-Flash-এ ৩২,৭৬৮ টোকেন পর্যন্ত) পর্যন্ত বাড়ার বদলে কেটে যায়।
দুই লাইনের টিকিট উত্তরের জন্য ১৫০ যথেষ্ট। এক শব্দের লেবেলের জন্য ২০।
স্টপ সিকোয়েন্স একটি মার্কারে উত্তর শেষ করে#
DeepSeek-এর রেফারেন্সে, stop সর্বোচ্চ ১৬টি সিকোয়েন্স নেয়, এবং মডেল যখন একটি উৎপন্ন করতে যাবে তখনই জেনারেশন থেমে যায়। যখন তা ঘটে, finish_reason হয় stop, স্বাভাবিক সমাপ্তির মতোই। এটি সুবিধাজনক যখন আপনার ফরম্যাটে একটি শেষ মার্কার থাকে। উত্তর চান, তারপর END সহ একটি লাইন, এবং stop-এ END রাখুন। আপনার নিজের সেটআপে একবার পরীক্ষা করুন: একটি কল করুন এবং যাচাই করুন যে finish_reason হলো stop এবং টেক্সট মার্কারের আগে শেষ হয়।
একটি নিয়ম: স্টপ টেক্সট এমন কিছু হতে হবে যা একটি ভালো উত্তরের ভেতরে আসতে পারে না। \n\n-এ স্টপ দিলে দুই-প্যারাগ্রাফের উত্তর প্রথম প্যারাগ্রাফের পরেই কেটে যায়।
একটি অনুরোধ যা আপনি চালাতে ও পরিমাপ করতে পারেন#
এখানে সীমাবদ্ধ টিকিট কলটি। মডেল আইডি হলো CheapTokens ডকস থেকে সম্পূর্ণ gateway_id, এবং বেস URL হলো https:/। ডকস দেখায় কীভাবে একটি কী তৈরি করতে হয়; এটি একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখুন।
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
প্রতিক্রিয়ায় দুটি জিনিস গুরুত্বপূর্ণ: choices[0]. এবং usage অবজেক্ট যাতে prompt_tokens ও completion_ আছে। Python-এ openai প্যাকেজ দিয়ে এটি এমন দেখায়:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
ফরম্যাটে আস্থা রাখার আগে দশটি বাস্তব টিকিটে এটি চালান। যদি completion_ ছোট থাকে এবং finish_reason সর্বদা stop হয়, তাহলে প্রম্পটই কাজ করছে। যদি আপনি length দেখেন, আপনার সীমা একটি ভালো উত্তরের প্রয়োজনের চেয়ে কম: এটি বাড়ান বা প্রম্পট কঠোর করুন, দুটোই অন্ধভাবে নয়।
জোড়া মেলান
ফিল্ডগুলো আপনাকে যা বলে
বাম দিকের একটি আইটেমে ট্যাপ করুন, তারপর তার জোড়ায়
- lengthmax_tokens সীমায় পৌঁছানো হয়েছে
- stopএকটি স্বাভাবিক স্টপ পয়েন্ট বা একটি স্টপ সিকোয়েন্স
- usage.completion_tokensউত্তরের টোকেন, আপনার বিলের আউটপুট দিক
যদি finish_reason stop না হয়, প্রথমে সীমাটি দেখুন।
১,০০০ অনুরোধে এটি কী সাশ্রয় করে#
এখন বিল। ধরুন একটি টিকিট প্লাস নির্দেশনা ৩০০ ইনপুট টোকেন, খোলা-প্রান্ত উত্তর ৪০০ আউটপুট টোকেন এবং সীমাবদ্ধটি ১০০। এগুলো উদাহরণের জন্য অনুমান; আপনার নিজের usage থেকে সংখ্যাগুলো বসান। ১,০০০ অনুরোধে, উভয় ক্ষেত্রেই ৩০০ × ১,০০০ = ৩০০,০০০ ইনপুট টোকেন, এবং ৪০০ × ১,০০০ = ৪০০,০০০ আউটপুট টোকেন বনাম ১০০ × ১,০০০ = ১০০,০০০।
খোলা-প্রান্ত উত্তর, ১,০০০ অনুরোধ:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
প্রতি অনুরোধে ৩০০ ইনপুট এবং ৪০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
সীমাবদ্ধ উত্তর, ১,০০০ অনুরোধ:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
প্রতি অনুরোধে ৩০০ ইনপুট এবং ১০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
ইনপুট দিক বদলায় না, এবং এটাই মূল কথা: শুধু যে অংশটি আপনি সংক্ষিপ্ত করেছেন সেটিই সস্তা হয়, আর সেটিই বেশি দামের অংশ। প্রতি মডেলে, একই ১,০০০ টিকিটের খরচ DeepSeek-V4-Flash-এ খোলা-প্রান্তে $0.0445 এবং সীমাবদ্ধে $0.0145। সামগ্রিকভাবে, ইনপুট ও আউটপুট একসাথে গণনা করলে, টেবিলের তিনটি মডেলই OpenRouter-এর রেফারেন্স দামের চেয়ে সস্তা হয়। সংক্ষিপ্ত উত্তরের জন্য, উপরের টেবিলগুলো থেকে মডেল বাছুন: আপনার নিজের ইনপুট ও আউটপুটের সারিগুলো তুলনা করুন। GLM-5.3-Flash (প্রতি ১M আউটপুট টোকেনে $0.04) সেখানে মানানসই যেখানে উত্তর দীর্ঘতর থাকে, ৮,১৯২ টোকেন পর্যন্ত; বাকিটা DeepSeek পেজে আছে।
আমি যে ক্রমে এটি প্রয়োগ করব#
ক্রমে সাজান
ধাপগুলো একটি যুক্তিসঙ্গত ক্রমে সাজান
আইটেমগুলো ড্র্যাগ করুন বা তীর ব্যবহার করুন
- প্রম্পটে উত্তর ফরম্যাট লিখুন
- দীর্ঘতম ভালো উত্তরের কিছুটা উপরে max_tokens সেট করুন
- যদি API stop গ্রহণ করে এবং ফরম্যাটে একটি শেষ মার্কার থাকে, একটি স্টপ সিকোয়েন্স যোগ করুন
- প্রতিটি কলে completion_tokens এবং finish_reason লগ করুন
- আগে ও পরে ১,০০০-অনুরোধ ব্যাচের খরচ তুলনা করুন
ধাপ ৪ হলো যা মানুষ এড়িয়ে যায়। এটি ছাড়া আপনি জানবেন না প্রম্পট পরিবর্তন কাজ করেছে কি না বা কয়েকটি দীর্ঘ উত্তর গড়কে উপরে টানছে কি না। যদি আপনি ইতিমধ্যে খরচ ট্র্যাক করেন, Python-এ টোকেন গণনার পদ্ধতি এবং ইনপুট বনাম আউটপুট টোকেন চালিয়ে যাওয়ার জন্য ভালো জায়গা।


