تحسين التكلفةدليل
قلّل توكنات الإخراج: طول الإجابة، max_tokens، تسلسلات الإيقاف
قصّر إجابات AI بالتصميم: اطلب صيغة محدودة، أبقِ max_tokens كسقف، استخدم تسلسلات الإيقاف، ثم راجع تكلفة 1,000 طلب.
في هذه الصفحة
روبوتك يرد بـ 400 توكن بينما يكفي 100، وأنت تدفع ثمن كل واحد منها. الحل يكمن أساسًا في الـ prompt: اطلب صيغة محدودة، وأبقِ max_tokens كسقف أمان لا كمقبض للطول، وتحقق من usage. لترى ما عاد فعليًا.
هذا مهم لأن المخرجات هي الجانب الأغلى في كل نموذج نقدمه: راجع الأسعار الحية على صفحة الأسعار. السؤال نفسه، إجابة أقصر، فاتورة أصغر.
ابدأ بالـ prompt، لا بالحد#
لنفترض أنك تشغّل روبوت دعم بـ 2,000 تذكرة يوميًا. كل تذكرة تحتاج فئة وجملة واحدة للسبب. النموذج، إذا تُرك وحده، يكتب فقرة ودودة وقائمة تحفظات وعرضًا للمساعدة الإضافية. هنا تذهب الـ 400 توكن.
قارن
التذكرة نفسها، برومبتان
مفتوح
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: فقرة فيها تحية وشرح وعرض للمساعدة (نحو 400 توكن).
محدود
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: التذكرة نفسها.
Answer: billing وسبب قصير واحد (نحو 100 توكن أو أقل).
الحيلة أنك تصف شكل الإجابة: عدد الأسطر، قائمة مغلقة من التصنيفات، حد للكلمات. عبارة "كن موجزًا" تعمل أسوأ من "سطران، 15 كلمة"، لأن النموذج لديه شيء ملموس يعده. إذا كنت تحتاج تصنيفًا فقط، اطلب التصنيف ولا شيء غيره. المصنّف الذي يجب أن يعيد billing لا ينبغي السماح له بشرح نفسه.
الأمر نفسه ينطبق على استخراج JSON. عندما يلف النموذج الـ JSON الخاص بك في نص، فذلك النص مخرجات تدفع ثمنها ثم ترميها. ضع "Return only the JSON object, no text before or after it" في رسالة النظام. لتحليل ما يعود، راجع كيفية استخراج JSON من رد LLM.
max_tokens حزام أمان#
من المغري أن تضبط max_tokens: 100 وتعتبرها انتهت. لا تتوقع منها إجابات قصيرة. يصف مرجع واجهة DeepSeek (تم التحقق في 2 نوفمبر 2026) max_tokens بأنه الحد الأقصى لعدد التوكنات التي يمكن توليدها في الإكمال، مع تحديد الإدخال والإخراج بطول سياق النموذج. إنه يوقف التوليد. لكنه لا يجعل النموذج يخطط لإجابة أقصر.
لذا نموذج أراد كتابة 400 توكن وحصل على 100 يسلمك جملة تنتهي في المنتصف، مع finish_reason مضبوطًا على length، وفاتورة عن كل الـ 100 توكن. دفعت ثمن إجابة لا يمكنك استخدامها. سبب حدوث ذلك وكيفية إصلاحه مغطى في لماذا تتوقف إجابة AI في منتصف الجملة وإصلاح finish_reason "length". لن أكرره هنا.
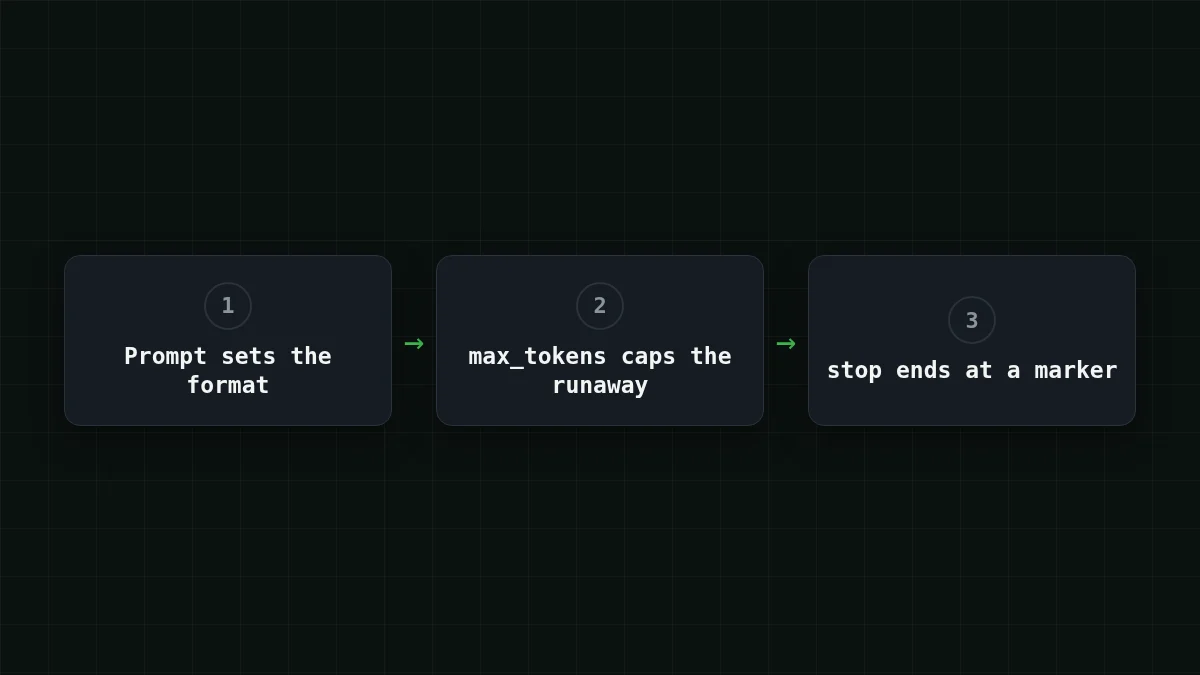
التقسيم العملي بسيط:
- الـ prompt يحدد طول الإجابة الجيدة؛
max_tokensيجلس أعلى قليلًا من أطول إجابة جيدة، فيُقطع الرد الجامح بدلًا من أن ينمو إلى حد مخرجات النموذج (حتى 32,768 توكن على DeepSeek-V4-Flash).
لإجابة التذكرة المكونة من سطرين، 150 كافية. لتصنيف من كلمة واحدة، 20.
تسلسلات الإيقاف تنهي الإجابة عند علامة#
في مرجع DeepSeek، يأخذ stop حتى 16 تسلسلًا، ويتوقف التوليد عندما يوشك النموذج على إنتاج أحدها. وعندما يحدث ذلك، يكون finish_reason هو stop، مثل النهاية الطبيعية. هذا مفيد عندما تكون لصيغتك علامة نهاية. اطلب الإجابة، ثم سطرًا فيه END، وضع END في stop. اختبره مرة واحدة على إعدادك: نفّذ استدعاءً واحدًا وتحقق من أن finish_reason هو stop وأن النص ينتهي قبل العلامة.
قاعدة واحدة: نص الإيقاف يجب ألا يكون شيئًا يمكن أن يظهر داخل إجابة جيدة. الإيقاف على \n\n يقطع إجابة من فقرتين بعد الفقرة الأولى.
طلب يمكنك تشغيله وقياسه#
هذا هو استدعاء التذكرة المحدود. معرّف النموذج هو gateway_id الكامل من وثائق CheapTokens، وعنوان URL الأساسي هو https:/. توضح الوثائق كيفية إنشاء مفتاح؛ ضعه في متغير بيئة.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
في الاستجابة، أمران مهمان: choices[0]. وكائن usage مع prompt_tokens وcompletion_. في Python مع حزمة openai يبدو هكذا:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
شغّله على عشر تذاكر حقيقية قبل أن تثق بالصيغة. إذا بقي completion_ صغيرًا وكان finish_reason دائمًا stop، فالـ prompt يقوم بالعمل. إذا رأيت length، فسقفك أقل مما تحتاجه إجابة جيدة: ارفعه أو شدّد الـ prompt، لا كليهما بشكل أعمى.
طابق الأزواج
ماذا تخبرك الحقول
اضغط على عنصر من اليسار، ثم على زوجه
- lengthتم الوصول إلى حد max_tokens
- stopنقطة توقف طبيعية أو تسلسل إيقاف
- usage.completion_tokensالتوكنات في الإجابة، جانب المخرجات من فاتورتك
إذا لم يكن finish_reason هو stop، فانظر إلى الحد أولًا.
ماذا يوفر على 1,000 طلب#
الآن الفاتورة. افترض أن التذكرة مع التعليمات تساوي 300 توكن إدخال، والإجابة المفتوحة 400 توكن إخراج والمحدودة 100. هذه افتراضات للمثال؛ استبدلها بالأرقام من usage الخاص بك. على 1,000 طلب، هذا 300 × 1,000 = 300,000 توكن إدخال في الحالتين، و400 × 1,000 = 400,000 توكن إخراج مقابل 100 × 1,000 = 100,000.
إجابات مفتوحة، 1,000 طلب:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 1,000 طلبات | OpenRouter، 1,000 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 رمز إدخال و400 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
إجابات محدودة، 1,000 طلب:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 1,000 طلبات | OpenRouter، 1,000 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 رمز إدخال و100 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
جانب الإدخال لا يتغير، وهذا هو المقصود: فقط الجزء الذي قصرته يصبح أرخص، وهو الجزء ذو السعر الأعلى. لكل نموذج، تكلف نفس الـ 1,000 تذكرة $0.0445 مفتوحة و$0.0145 محدودة على DeepSeek-V4-Flash. إجمالًا، مع احتساب الإدخال والإخراج معًا، تخرج النماذج الثلاثة في الجداول أرخص من سعر OpenRouter المرجعي. للإجابات القصيرة، اختر النموذج من الجداول أعلاه: قارن الصفوف الخاصة بإدخالك وإخراجك. GLM-5.3-Flash ($0.04 لكل 1M توكن إخراج) يناسب حيث تبقى الإجابات أطول، حتى 8,192 توكن؛ صفحة DeepSeek فيها الباقي.
الترتيب الذي سأطبّق به هذا#
رتّب بالترتيب
رتّب الخطوات بترتيب منطقي
اسحب العناصر أو استخدم الأسهم
- اكتب صيغة الإجابة في الـ prompt
- اضبط max_tokens أعلى قليلًا من أطول إجابة جيدة
- إذا كانت الواجهة تقبل stop وللصيغة علامة نهاية، أضف تسلسل إيقاف
- سجّل completion_tokens وfinish_reason لكل استدعاء
- قارن تكلفة دفعة من 1,000 طلب قبل وبعد
الخطوة 4 هي التي يتخطاها الناس. بدونها لا تعرف إن كان تغيير الـ prompt قد نجح أم أن بعض الإجابات الطويلة تسحب المتوسط لأعلى. إذا كنت تتبع الإنفاق بالفعل، فإن نهج عد التوكنات في Python وتوكنات الإدخال مقابل الإخراج نقطة جيدة للمتابعة.


