Recorta tokens de salida: longitud de respuesta, max_tokens, secuencias de parada
Acorta las respuestas de IA por diseño: pide un formato acotado, mantén max_tokens como tope, usa secuencias de parada y luego mira el coste de 1.000 peticiones.
En esta página
Tu bot responde con 400 tokens cuando 100 bastarían, y pagas por cada uno de ellos. La solución está mayormente en el prompt: pide un formato acotado, mantén max_tokens como tope de seguridad en lugar de como perilla de longitud, y revisa usage. para ver qué llegó realmente.
Esto importa porque la salida es el lado más caro en todos los modelos que ofrecemos: consulta los precios en vivo en la página de precios. Misma pregunta, respuesta más corta, factura más pequeña.
Empieza por el prompt, no por el límite#
Supón que tienes un bot de soporte con 2.000 tickets al día. Cada ticket necesita una categoría y una frase de motivo. El modelo, si lo dejas solo, escribe un párrafo amable, una lista de advertencias y una oferta de ayuda adicional. Ahí se van los 400 tokens.
Comparar
Mismo ticket, dos prompts
Abierto
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: un párrafo con un saludo, una explicación y una oferta de ayuda (alrededor de 400 tokens).
Acotado
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: el mismo ticket.
Answer: billing y un motivo corto (alrededor de 100 tokens o menos).
El truco es que describes la forma de la respuesta: número de líneas, una lista cerrada de etiquetas, un límite de palabras. "Sé breve" funciona peor que "dos líneas, 15 palabras", porque el modelo tiene algo concreto que contar. Si solo necesitas una etiqueta, pide la etiqueta y nada más. Un clasificador que debe devolver billing no debería poder explicarse.
Lo mismo vale para la extracción de JSON. Cuando el modelo envuelve tu JSON en prosa, esa prosa es salida que pagas y luego tiras. Pon "Return only the JSON object, no text before or after it" en el mensaje de sistema. Para analizar lo que llega, consulta cómo extraer JSON de una respuesta de un LLM.
max_tokens es un cinturón de seguridad#
Es tentador fijar max_tokens: 100 y darlo por hecho. No esperes respuestas cortas por ello. La referencia de la API de DeepSeek (consultada el 2 de noviembre de 2026) describe max_tokens como el número máximo de tokens que se pueden generar en la completación, con la entrada más la salida limitadas por la longitud de contexto del modelo. Detiene la generación. No hace que el modelo planifique una respuesta más corta.
Así que un modelo que quería escribir 400 tokens y recibió 100 te entrega una frase que termina a medias, finish_reason con valor length, y una factura por los 100 tokens. Pagaste por una respuesta que no puedes usar. Por qué ocurre y cómo repararlo se cubre en por qué una respuesta de IA se corta a mitad de frase y la solución al finish_reason "length". No lo repito aquí.
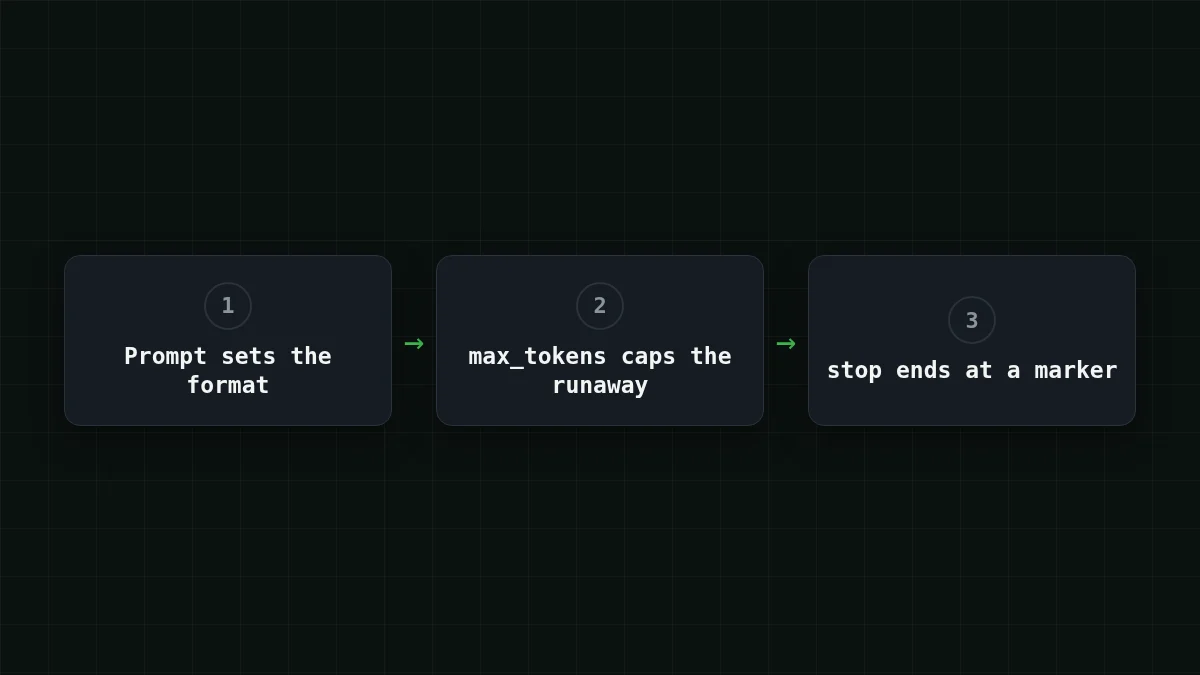
La división que funciona es simple:
- el prompt decide qué tan larga es una buena respuesta;
max_tokensse sitúa un poco por encima de la respuesta buena más larga, para que una respuesta desbocada se corte en lugar de crecer hasta el límite de salida del modelo (hasta 32.768 tokens en DeepSeek-V4-Flash).
Para la respuesta de ticket en dos líneas, 150 es de sobra. Para una etiqueta de una palabra, 20.
Las secuencias de parada terminan una respuesta en un marcador#
En la referencia de DeepSeek, stop admite hasta 16 secuencias, y la generación se detiene cuando el modelo produciría una. Cuando lo hace, finish_reason es stop, igual que un final natural. Esto es útil cuando tu formato tiene un marcador de fin. Pide la respuesta, luego una línea con END, y pon END en stop. Pruébalo una vez en tu propia configuración: haz una llamada y comprueba que finish_reason es stop y que el texto termina antes del marcador.
Una regla: el texto de parada debe ser algo que no pueda aparecer dentro de una buena respuesta. Una parada en \n\n corta una respuesta de dos párrafos después del primero.
Una petición que puedes ejecutar y medir#
Aquí está la llamada acotada del ticket. El id del modelo es el gateway_id completo de la documentación de CheapTokens, y la URL base es https:/. La documentación muestra cómo crear una clave; ponla en una variable de entorno.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
En la respuesta, importan dos cosas: choices[0]. y el objeto usage con prompt_tokens y completion_. En Python con el paquete openai se ve así:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Ejecútalo con diez tickets reales antes de confiar en el formato. Si completion_ se mantiene pequeño y finish_reason siempre es stop, el prompt hace el trabajo. Si ves length, tu tope está por debajo de lo que necesita una buena respuesta: súbelo o ajusta el prompt, no ambos a ciegas.
Emparejar los pares
Qué te dicen los campos
Toca un elemento de la izquierda, luego su par
- lengthSe alcanzó el límite de max_tokens
- stopUn punto de parada natural o una secuencia de parada
- usage.completion_tokensLos tokens de la respuesta, el lado de salida de tu factura
Si finish_reason no es stop, mira primero el límite.
Qué ahorra en 1.000 peticiones#
Ahora la factura. Supón que un ticket más las instrucciones son 300 tokens de entrada, la respuesta abierta es de 400 tokens de salida y la acotada de 100. Son supuestos para el ejemplo; sustituye los números de tu propio usage. En 1.000 peticiones, eso es 300 × 1.000 = 300.000 tokens de entrada en ambos casos, y 400 × 1.000 = 400.000 tokens de salida frente a 100 × 1.000 = 100.000.
Respuestas abiertas, 1.000 peticiones:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 tokens de entrada y 400 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Respuestas acotadas, 1.000 peticiones:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 tokens de entrada y 100 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
El lado de entrada no se mueve, y esa es la cuestión: solo se abarata la parte que acortaste, y es la parte con el precio más alto. Por modelo, los mismos 1.000 tickets cuestan $0.0445 en abierto y $0.0145 acotado en DeepSeek-V4-Flash. En total, contando entrada y salida juntas, los tres modelos de las tablas salen más baratos que el precio de referencia de OpenRouter. Para respuestas cortas, elige el modelo de las tablas anteriores: compara las filas para tu propia entrada y salida. GLM-5.3-Flash ($0.04 por 1M de tokens de salida) encaja donde las respuestas son más largas, hasta 8.192 tokens; la página de DeepSeek tiene el resto.
El orden en que aplicaría esto#
Poner en orden
Pon los pasos en un orden sensato
Arrastra los elementos o usa las flechas
- Escribe el formato de respuesta en el prompt
- Fija max_tokens un poco por encima de la respuesta buena más larga
- Si la API acepta stop y el formato tiene un marcador de fin, añade una secuencia de parada
- Registra completion_tokens y finish_reason en cada llamada
- Compara el coste de un lote de 1.000 peticiones antes y después
El paso 4 es el que la gente se salta. Sin él no sabes si el cambio de prompt funcionó o si unas pocas respuestas largas están subiendo la media. Si ya haces seguimiento del gasto, el enfoque de conteo de tokens en Python y tokens de entrada vs salida son un buen lugar para continuar.


