Corte tokens de saída: comprimento da resposta, max_tokens, sequências de parada
Encurte respostas de IA por design: peça um formato delimitado, mantenha max_tokens como limite, use sequências de parada e veja o custo de 1.000 requisições.
Nesta página
Seu bot responde em 400 tokens quando 100 bastariam, e você paga por cada um deles. A correção está principalmente no prompt: peça um formato delimitado, mantenha max_tokens como limite de segurança em vez de controle de comprimento, e verifique usage. para ver o que realmente voltou.
Isso importa porque a saída é o lado mais caro em todo modelo que oferecemos: veja os preços ao vivo na página de preços. Mesma pergunta, resposta mais curta, conta menor.
Comece pelo prompt, não pelo limite#
Digamos que você opere um bot de suporte com 2.000 tickets por dia. Cada ticket precisa de uma categoria e uma frase de justificativa. O modelo, deixado por conta própria, escreve um parágrafo amigável, uma lista de ressalvas e uma oferta de ajuda adicional. É aí que vão os 400 tokens.
Comparar
Mesmo ticket, dois prompts
Aberto
System: You are a helpful support assistant. User: Tell me what kind of ticket this is: "My card was charged twice for order 1182." Answer: um parágrafo com saudação, explicação e oferta de ajuda (cerca de 400 tokens).
Delimitado
System: Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting.
User: o mesmo ticket.
Answer: billing e uma justificativa curta (cerca de 100 tokens ou menos).
O truque é descrever a forma da resposta: número de linhas, uma lista fechada de rótulos, um limite de palavras. "Seja breve" funciona pior que "duas linhas, 15 palavras", porque o modelo tem algo concreto para contar. Se você só precisa de um rótulo, peça o rótulo e nada mais. Um classificador que deve retornar billing não deveria poder se explicar.
O mesmo vale para extração de JSON. Quando o modelo envolve seu JSON em prosa, a prosa é saída que você paga e depois descarta. Coloque "Return only the JSON object, no text before or after it" na mensagem de sistema. Para fazer o parsing do que volta, veja como extrair JSON de uma resposta de LLM.
max_tokens é um cinto de segurança#
É tentador definir max_tokens: 100 e considerar resolvido. Não espere respostas curtas por causa disso. A referência da API do DeepSeek (verificada em 2 de novembro de 2026) descreve max_tokens como o número máximo de tokens que podem ser gerados na completion, com entrada mais saída limitadas pelo comprimento de contexto do modelo. Ele interrompe a geração. Não faz o modelo planejar uma resposta mais curta.
Então um modelo que queria escrever 400 tokens e recebeu 100 te entrega uma frase que termina no meio, finish_reason definido como length, e uma conta por todos os 100 tokens. Você pagou por uma resposta que não pode usar. Por que isso acontece e como corrigir está coberto em por que uma resposta de IA para no meio da frase e a correção do finish_reason "length". Não vou repetir aqui.
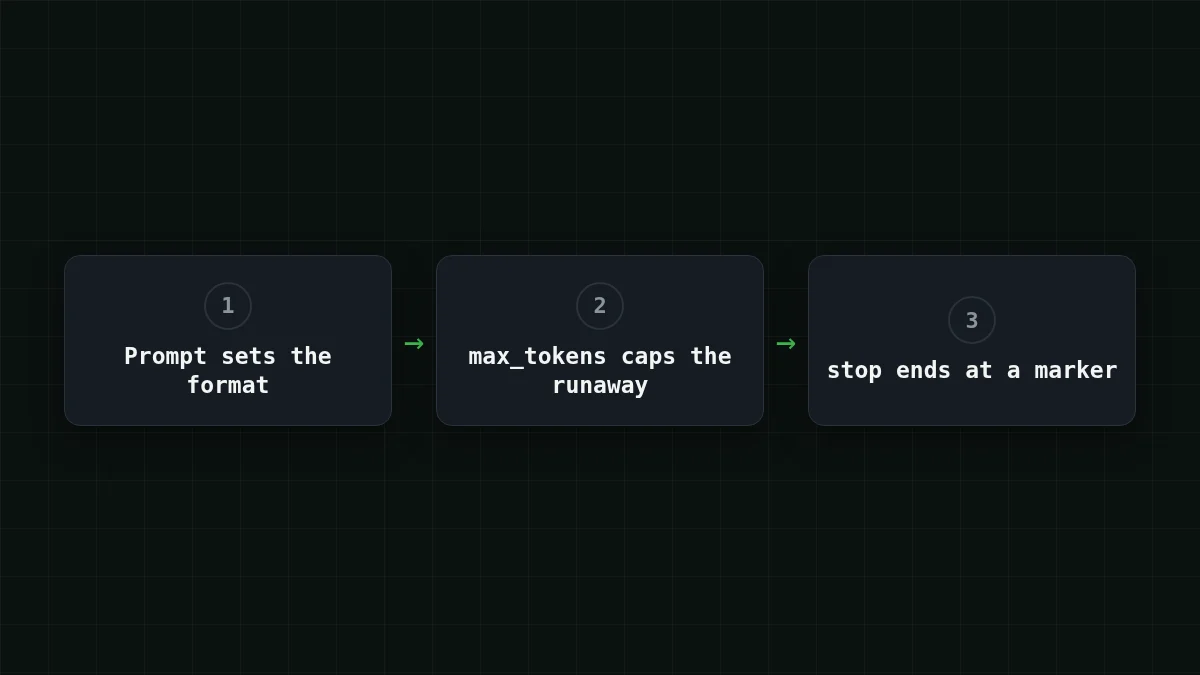
A divisão que funciona é simples:
- o prompt decide qual é o comprimento de uma boa resposta;
max_tokensfica um pouco acima da resposta boa mais longa, para que uma resposta descontrolada seja cortada em vez de crescer até o limite de saída do modelo (até 32.768 tokens no DeepSeek-V4-Flash).
Para a resposta de ticket em duas linhas, 150 é suficiente. Para um rótulo de uma palavra, 20.
Sequências de parada encerram uma resposta em um marcador#
Na referência do DeepSeek, stop aceita até 16 sequências, e a geração para quando o modelo produziria uma delas. Quando isso acontece, finish_reason é stop, o mesmo que um encerramento natural. Isso é útil quando seu formato tem um marcador de fim. Peça a resposta, depois uma linha com END, e coloque END em stop. Teste uma vez na sua própria configuração: faça uma chamada e verifique que finish_reason é stop e que o texto termina antes do marcador.
Uma regra: o texto de parada deve ser algo que não possa aparecer dentro de uma boa resposta. Uma parada em \n\n corta uma resposta de dois parágrafos após o primeiro parágrafo.
Uma requisição que você pode executar e medir#
Aqui está a chamada de ticket delimitada. O id do modelo é o gateway_id completo da documentação do CheapTokens, e a URL base é https:/. A documentação mostra como criar uma chave; coloque-a em uma variável de ambiente.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 150,
    "messages": [
      {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
      {"role": "user", "content": "My card was charged twice for order 1182."}
    ]
  }'
Na resposta, duas coisas importam: choices[0]. e o objeto usage com prompt_tokens e completion_. Em Python com o pacote openai fica assim:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    max_tokens=150,
    messages=[
        {"role": "system", "content": "Reply with exactly two lines. Line 1: the category, one of billing, bug, other. Line 2: a reason in at most 15 words. No greeting."},
        {"role": "user", "content": "My card was charged twice for order 1182."},
    ],
)

print(r.choices[0].message.content)
print(r.choices[0].finish_reason, r.usage.completion_tokens)
Execute em dez tickets reais antes de confiar no formato. Se completion_ permanecer pequeno e finish_reason for sempre stop, o prompt está fazendo o trabalho. Se você vir length, seu limite está abaixo do que uma boa resposta precisa: aumente-o ou reforce o prompt, não os dois às cegas.
Emparelhar os pares
O que os campos te dizem
Toque num item à esquerda, depois no seu par
- lengthO limite de max_tokens foi atingido
- stopUm ponto de parada natural ou uma sequência de parada
- usage.completion_tokensOs tokens na resposta, o lado de saída da sua conta
Se finish_reason não for stop, olhe o limite primeiro.
O que isso economiza em 1.000 requisições#
Agora a conta. Suponha que um ticket mais instruções seja 300 tokens de entrada, a resposta aberta seja 400 tokens de saída e a delimitada seja 100. Essas são suposições para o exemplo; troque pelos números do seu próprio usage. Em 1.000 requisições, isso é 300 × 1.000 = 300.000 tokens de entrada nos dois casos, e 400 × 1.000 = 400.000 tokens de saída contra 100 × 1.000 = 100.000.
Respostas abertas, 1.000 requisições:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0433 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000045 | $0.0445 | $0.077 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000075 | $0.075 | $0.90 |
300 tokens de entrada e 400 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Respostas delimitadas, 1.000 requisições:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.01 | $0.0184 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0145 | $0.035 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00003 | $0.03 | $0.36 |
300 tokens de entrada e 100 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
O lado da entrada não muda, e esse é o ponto: só a parte que você encurtou fica mais barata, e é a parte com o preço mais alto. Por modelo, os mesmos 1.000 tickets custam $0.0445 no formato aberto e $0.0145 no delimitado no DeepSeek-V4-Flash. No total, com entrada e saída contabilizadas juntas, todos os três modelos das tabelas saem mais baratos que o preço de referência do OpenRouter. Para respostas curtas, escolha o modelo nas tabelas acima: compare as linhas para sua própria entrada e saída. GLM-5.3-Flash ($0.04 por 1M tokens de saída) se encaixa onde as respostas ficam mais longas, até 8.192 tokens; a página do DeepSeek tem o resto.
A ordem em que eu aplicaria isso#
Colocar em ordem
Coloque os passos em uma ordem sensata
Arraste os itens ou use as setas
- Escreva o formato da resposta no prompt
- Defina max_tokens um pouco acima da resposta boa mais longa
- Se a API aceitar stop e o formato tiver um marcador de fim, adicione uma sequência de parada
- Registre completion_tokens e finish_reason em cada chamada
- Compare o custo de um lote de 1.000 requisições antes e depois
O passo 4 é o que as pessoas pulam. Sem ele, você não sabe se a mudança no prompt funcionou ou se algumas respostas longas estão puxando a média para cima. Se você já acompanha gastos, a abordagem de contagem de tokens em Python e tokens de entrada vs saída são um bom lugar para continuar.


