Limite o custo de um lote de LLM em Python: um registro e um orçamento rígido
Registre tokens e custo de cada chamada à API em um arquivo JSONL, pare o lote em um orçamento e estime a conta antes de executá-lo. Código Python incluído.
Nesta página
Seu script percorre 200 prompts, você fecha a tampa do notebook e, de manhã, descobre quanto custou a noite. Dois pequenos hábitos resolvem isso. Depois de cada chamada à API, acrescente uma linha com tokens e custo a um arquivo de registro. Antes de cada chamada, compare o total acumulado com um orçamento e pare se ele for atingido. São menos de 50 linhas de Python, e uma execução de teste com 5 prompts informa a conta antes de a execução real começar.
O que a execução do Clocktower faz que você pode copiar#
Dwarkesh Patel, apresentador do Dwarkesh Podcast, colocou 11 modelos uns contra os outros em Blood on the Clocktower, 386 partidas segundo o README, e publicou o código, os logs e as classificações (github.com/dwarkeshsp/clocktower, verificado em 8 de novembro de 2026). Dois detalhes do repositório valem a pena ser copiados. Cada diretório de partida mantém um log por chamada com tokens e custo, e os gastos vão para games/. Uma flag --budget limita o gasto total; o padrão é US$ 1.000. O site do benchmark adiciona uma terceira proteção: cada modelo recebe o mesmo teto de 8.000 tokens por turno (clocktowerbench.com).
Então: um teto em cada chamada, um log de cada chamada, um limite no total. Um torneio precisa dos três, e sua execução noturna também, só que em menor escala.
Pense no registro como o rolo de recibos da caixa registradora de uma loja. Cada venda imprime uma linha; o gerente pode somar o rolo a qualquer momento e sabe quando o fundo de troco do dia acabou.
O registro: um arquivo, uma linha por chamada#
Aqui está tudo. Usa o pacote openai apontado para a CheapTokens (https:/, veja a documentação para a chave e os ids dos modelos).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
Cada chamada passa pelas mesmas quatro etapas:
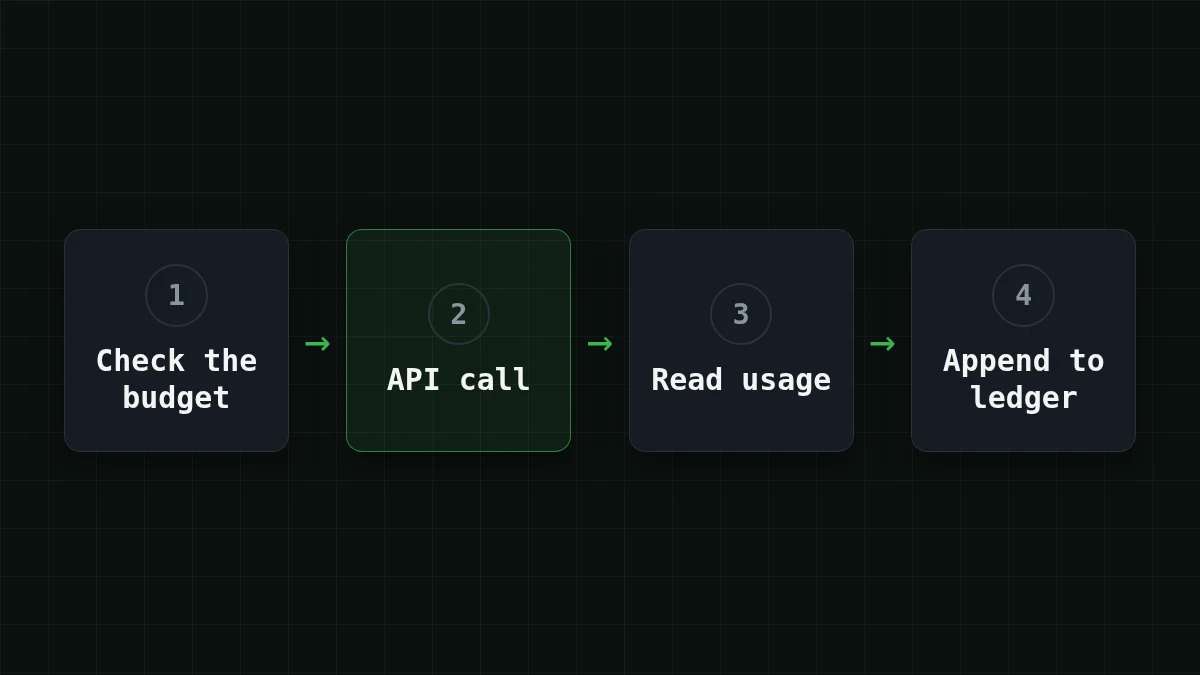
Três escolhas ali são deliberadas.
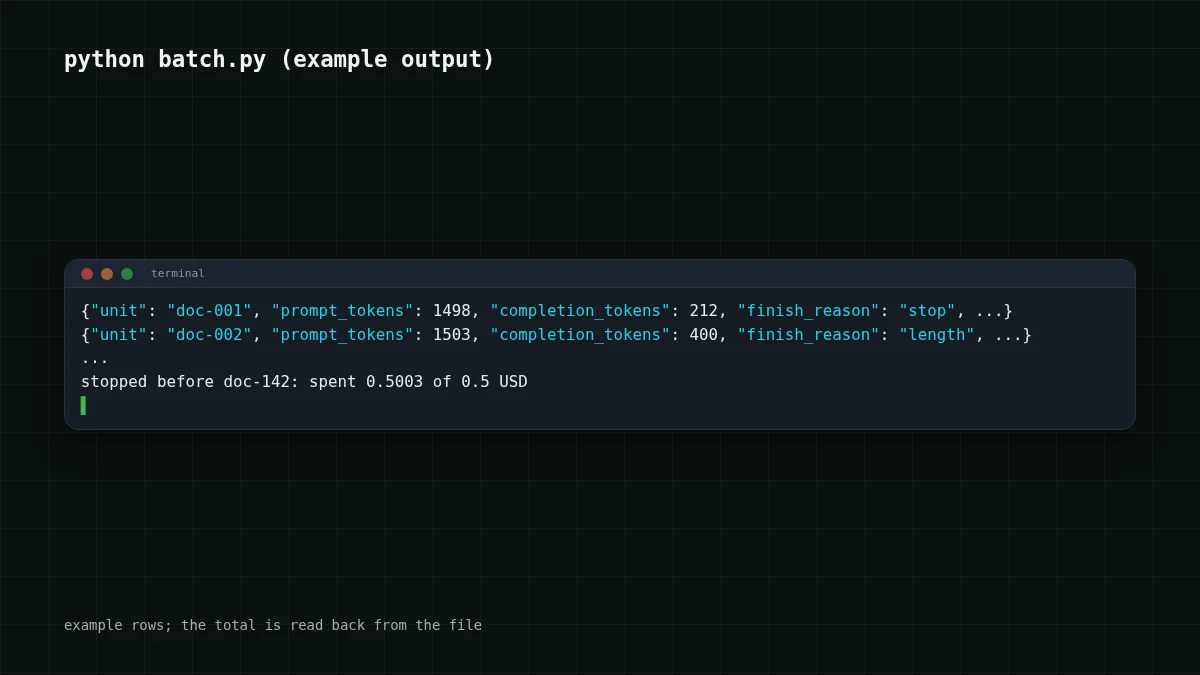
- Um objeto JSON por linha (JSONL), aberto em modo de acréscimo. Se o script travar na chamada 130, as chamadas de 1 a 129 já estão no disco.
- O total vem do arquivo, não de uma variável. Reinicie o script e o limite continua valendo, porque o registro lembra quanto a execução anterior gastou.
finish_reasoné registrado ao lado dos tokens. Uma linha que dizlengthsignifica que a resposta atingiu seumax_tokense foi cortada. Você vai querer saber disso depois.
As duas constantes PRICE_ são placeholders. Pegue os números atuais na tabela de preços. Para o DeepSeek-V4-Flash no momento em que você lê isto, são $0.015 por 1M de tokens de entrada e $0.10 por 1M de tokens de saída. Troque MODEL por zai- ou MiniMaxAI/ e as duas constantes, e o mesmo registro funciona para eles.
O loop em lote: pule o que já foi feito, pare no limite#
O loop é curto. Digamos que seus prompts estejam em um dict com chave por id de unidade, o nome de uma peça de trabalho, como doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
Execute, aperte Ctrl+C no meio, execute de novo: as unidades concluídas são puladas, então o registro também serve como seu arquivo de progresso. Deixe o orçamento acabar e você recebe uma linha em vez de uma surpresa, algo como stopped before doc-.
Observe a palavra antes. A verificação acontece antes de cada chamada, então a última chamada pode empurrar o total um pouco acima do orçamento. O quanto acima é limitado: uma chamada não pode custar mais que seu prompt mais longo mais max_tokens. Para um prompt de 1.500 tokens e max_tokens=400, isso é no máximo $0.000063. É por isso que cada chamada no wrapper tem um max_tokens: transforma um risco aberto em um número com o qual você pode planejar.
Estime a conta antes de apertar executar#
Agora a outra metade: saber o custo antes do lançamento. Rode os primeiros cinco prompts por ask() com um orçamento pequeno e leia o registro. Digamos que as cinco linhas tenham em média 1.500 tokens de entrada e 400 de saída. Esses são seus números para o lote inteiro.
Para 200 prompts, isso é 200 × 1.500 = 300.000 tokens de entrada e 200 × 400 = 80.000 tokens de saída. Aqui está essa carga com preços atuais:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 200 solicitações | OpenRouter, 200 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1.500 tokens de entrada e 400 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A tabela também tem uma coluna do OpenRouter. Com entrada e saída somadas, o DeepSeek-V4-Flash sai mais barato que o OpenRouter para essa carga, e essa soma é o que o lote realmente paga.
Os prompts variam de tamanho, então cinco amostras são um palpite, não uma promessa. Use o mais longo dos cinco quando quiser um limite superior seguro, e deixe o teto do orçamento pegar o resto. Quer comparar dois modelos nos mesmos 200 prompts? Dê a cada modelo seu próprio arquivo de registro, por exemplo Ledger(f'ledger-, e os dois totais ficam lado a lado depois.
Teste seu próprio lote aqui: defina os tokens por requisição a partir da sua amostra e quantas requisições você planeja.
Calculadora de custos
Seu lote: tokens da sua amostra de 5 prompts
Tokens de entrada por solicitação: 1.500 · Tokens de saída por solicitação: 400 · Solicitações por dia: 200
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Para saber mais sobre contagem de tokens antes do envio, veja contagem de tokens com tiktoken.
Quando a conta é maior que o esperado: leia o registro#
O terceiro cenário de leitura é o pior. Uma execução de agente dá errado e entra em loop, e o painel mostra apenas um total. O registro mostra onde foi. Ordene as linhas por custo:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Para um agente, nomeie a unidade conforme a etapa (step-17) para que você veja o formato da execução. Alguns padrões aparecem repetidamente; associe cada um à sua causa habitual:
Emparelhar os pares
Associe cada padrão do registro à sua causa habitual
Toque num item à esquerda, depois no seu par
- prompt_tokens cresce um pouco em cada linhaO loop reenvia todo o histórico a cada etapa
- completion_tokens é igual a max_tokens e finish_reason é lengthAs respostas são cortadas no seu limite, e você paga pelo texto cortado
- A mesma unidade aparece muitas vezes seguidasUm loop de retentativa, ou um agente repetindo uma etapa
- Uma linha custa muito mais que todas as outrasUma entrada grande demais, como um arquivo inteiro colado no prompt
Cada padrão é visível no registro muito antes da fatura. O primeiro é abordado em por que um agente relê seu histórico.
Se você também quiser gasto por projeto e alertas fora do script, este guia de alertas de orçamento por projeto cobre esse lado. O registro aqui é a parte que vive no seu código e pode dizer pare.
Antes de lançar#
Lista de verificação
Antes da primeira execução real
O tamanho de contexto e o limite de resposta do DeepSeek-V4-Flash, úteis quando você escolhe max_tokens, estão na página dele: DeepSeek-V4-Flash na CheapTokens.


