Acompanhe o gasto de API por projeto e receba alertas de orçamento em Python
Um pequeno script Python transforma seu log de uso em um relatório de custo por projeto e avisa em 50, 75, 95 e 100% de um orçamento mensal.
Nesta página
Adicione uma linha JSON a um arquivo após cada chamada de API, marque-a com um nome de projeto e deixe um script Python de 30 linhas transformar esse arquivo em um relatório de custo por projeto e um aviso em 50, 75, 95 e 100% do seu orçamento mensal. É a mesma visão que a Anthropic acabou de oferecer às equipes do Claude Enterprise, construída a partir do seu próprio log.
Digamos que um saldo alimente um agente, um script de rascunho de blog e um pequeno bot de suporte. O fim do mês chega, o saldo está menor do que você esperava e nada te diz qual dos três foi o responsável. É essa lacuna que isto fecha.
O que a Anthropic lançou, e o que você pode copiar#
O anúncio da Anthropic (28 de outubro de 2026) cobre relatórios inteligentes, pesquisas no app e orçamentos de grupo compartilhados, disponíveis apenas nos planos Claude Enterprise (fonte). Duas partes importam aqui. Um relatório agrupa o trabalho de uma equipe em frentes de trabalho e mostra o gasto de cada uma. Um orçamento compartilhado é um único número mensal compartilhado, e os administradores de cobrança recebem um e-mail em 50%, 75%, 95% e 100% dele. A Anthropic acrescenta que os relatórios servem para planejar investimento, não para julgar pessoas individualmente.
Você não precisa de um plano enterprise para a mesma estrutura. Uma frente de trabalho é apenas um rótulo que você escolhe, e os quatro limites são uma lista no código. Agrupe por projeto, não por pessoa, pelo motivo que a Anthropic dá.
Verificação rápida
Seu saldo pré-pago já interrompe as requisições em zero. Por que adicionar avisos em 50% e 75%?
Mostrar resposta
Resposta: Porque zero é tarde demais: você quer perceber um loop descontrolado enquanto ainda há dinheiro para investigar
O saldo é uma parada rígida, não um alarme. Limites antecipados transformam uma surpresa em 100% em uma pergunta no nono dia.
O log: uma linha por requisição#
Toda resposta de chat completion carrega um objeto usage com prompt_tokens e completion_. É tudo o que o relatório precisa, mais um rótulo de projeto que você mesmo adiciona. Este wrapper envia a requisição e acrescenta uma linha a um arquivo mensal (o nome do arquivo muda a cada mês, então um novo mês começa do zero):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Use o id completo do modelo da documentação do CheapTokens (deepseek-, zai-); os nomes curtos das tabelas de preços não são aceitos pela API. A chave vem de uma variável de ambiente, nunca do arquivo.
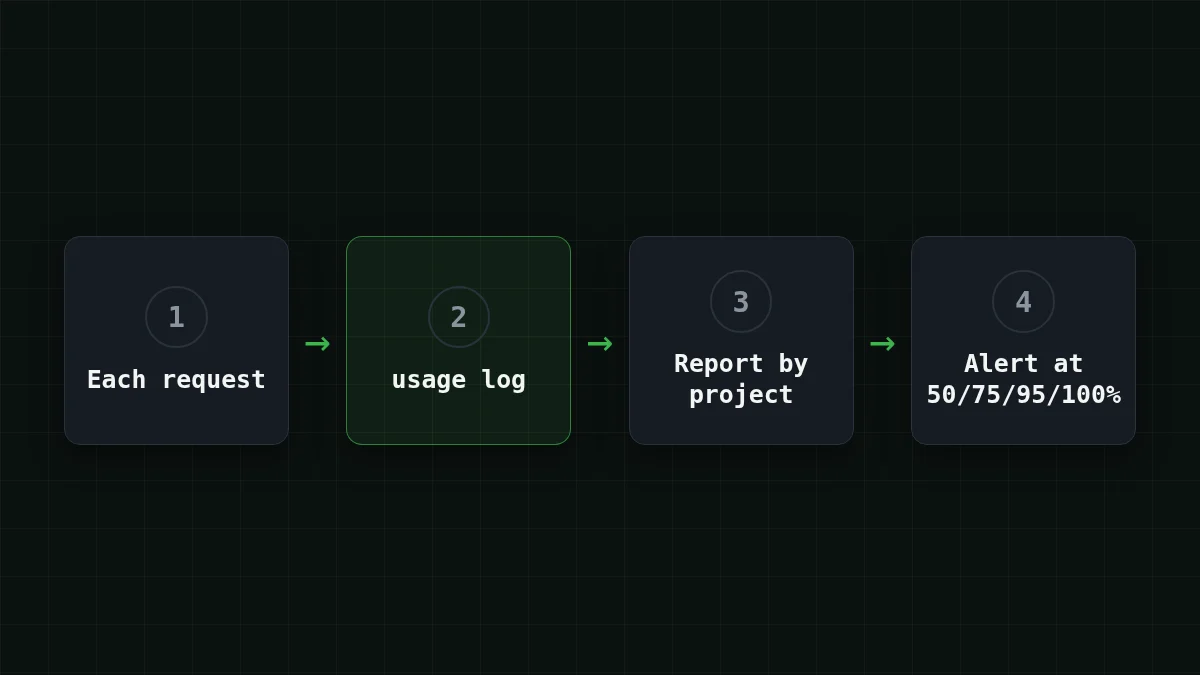
O script: custo por projeto e alertas de limite#
Salve isto como report.py. Os preços são placeholders: copie os atuais da tabela de preços (ambos os modelos compartilham um preço de exemplo aqui apenas para manter a aritmética legível).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
As últimas quatro linhas são a parte que as pessoas esquecem. Sem o pequeno arquivo de estado, o script gritaria "passou de 50%" em toda execução pelo resto do mês. Com ele, cada nível dispara uma vez.
Execute e leia o resultado#
Pegue um log de brinquedo de quatro linhas (um real tem uma linha por requisição, ou seja, milhares):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
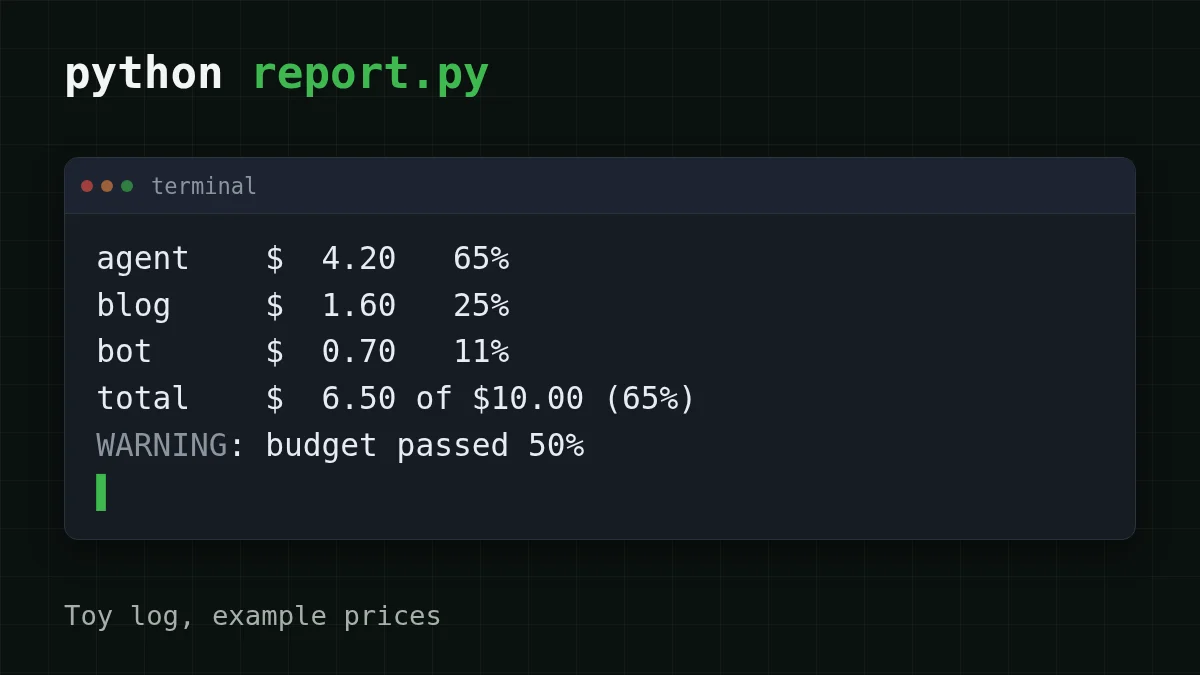
Com os preços de exemplo e um orçamento de 10, python report.py imprime:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
O agente é quase dois terços da conta, e o aviso veio em 50%, não no final. Execute novamente e o aviso fica quieto até o total atingir 75%.
Para fazer isto funcionar todo mês, você precisa de três passos:
Passo a passo
Configure em três passos
Registre cada chamada
Encaminhe todas as suas chamadas por ask(project, model, messages) e escolha um rótulo de projeto curto e estável. Renomear rótulos no meio do mês divide um projeto em duas linhas.
Defina preços e orçamento
Coloque os preços atuais da tabela de preços em PRICES e exporte seu limite: export BUDGET_.
Execute em um agendamento
Uma linha de cron horária é suficiente: 0 * * * * cd ~/. Envie a saída para um comando de e-mail ou chat se quiser o aviso enviado a você.
Como é um mês em modelos baratos#
Os números ficam úteis quando são os seus números. Suponha que o agente do log de brinquedo tenha em média 30.000 tokens de entrada e 2.000 de saída por passo, 20 passos por tarefa, duas tarefas por dia. Um passo no DeepSeek-V4-Flash custa $0.00065; no GLM-5.3-Flash, $0.00068. Um dia são 40 passos, um mês 1.200. Ajuste os controles para corresponder ao seu próprio agente:
Calculadora de custos
Um dia do agente: passos por tarefa vezes tarefas por dia
Tokens de entrada por solicitação: 30.000 · Tokens de saída por solicitação: 2.000 · Solicitações por dia: 40
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
E o mês com 1.200 passos, com entrada e saída contadas juntas:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.200 solicitações | OpenRouter, 1.200 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30.000 tokens de entrada e 2.000 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, ambos os modelos saem mais baratos que os preços de referência do OpenRouter naquela tabela, com um preço a qualquer hora e sem sobretaxa de pico. O DeepSeek-V4-Flash também permite até 32.768 tokens de saída por resposta e um contexto de 380K; o GLM-5.3-Flash tem um contexto de 390K. Depois que o relatório mostrar qual projeto é o pesado, trocar apenas a string model desse projeto é uma mudança de uma linha, e um saldo cobre todos os modelos. Para saber quantos tokens uma única requisição realmente usa, veja quantos tokens uma requisição de API usa; para interromper uma execução de agente no meio, veja rastreamento do custo de tokens de agentes de IA. Preços e modelos estão na página de modelos do CheapTokens.
Onde isto dá errado#
- Um modelo está faltando em
PRICES. O script para com umKeyErrorque nomeia o modelo. Adicione-o; não use zero como padrão, ou o projeto parecerá gratuito. - Chamadas em streaming. O chunk final carrega o uso apenas se você pedir (
stream_no SDK da OpenAI). Caso contrário, seu log tem lacunas.options={"include_ usage": True} - Requisições com falha. Registre apenas respostas que tenham um objeto
usage; uma requisição que deu erro não tem nada a contar. - Relatórios por pessoa. Mantenha o rótulo como um nome de projeto ou agente. Um relatório sobre pessoas convida a conclusões erradas.


