Controla el gasto de la API por proyecto y recibe alertas de presupuesto en Python
Un breve script de Python convierte tu registro de uso en un informe de coste por proyecto y avisa al 50, 75, 95 y 100 % de un presupuesto mensual.
En esta página
Añade una línea JSON a un archivo después de cada llamada a la API, etiquétala con el nombre de un proyecto y deja que un script de Python de 30 líneas convierta ese archivo en un informe de coste por proyecto y en una advertencia al 50, 75, 95 y 100 % de tu presupuesto mensual. Es la misma vista que Anthropic acaba de dar a los equipos de Claude Enterprise, construida a partir de tu propio registro.
Digamos que un saldo alimenta un agente, un script de redacción de borradores para el blog y un pequeño bot de soporte. Llega el fin de mes, el saldo es más bajo de lo que esperabas y nada te dice cuál de los tres ha sido. Ese es el hueco que esto cierra.
Qué ha lanzado Anthropic y qué puedes copiar#
El anuncio de Anthropic (28 de octubre de 2026) cubre informes inteligentes, encuestas dentro de la aplicación y presupuestos de grupo mancomunados, disponibles de forma general solo en los planes Claude Enterprise (fuente). Aquí importan dos partes. Un informe agrupa el trabajo de un equipo en flujos de trabajo y muestra el gasto de cada uno. Un presupuesto mancomunado es una única cifra mensual compartida, y los administradores de facturación reciben un correo al 50 %, 75 %, 95 % y 100 % de ella. Anthropic añade que los informes sirven para planificar la inversión, no para juzgar a personas concretas.
No necesitas un plan enterprise para la misma forma. Un flujo de trabajo no es más que una etiqueta que eliges, y los cuatro umbrales son una lista en el código. Agrupa por proyecto, no por persona, por la razón que da Anthropic.
Verificación rápida
Tu saldo de prepago ya detiene las peticiones al llegar a cero. ¿Por qué añadir advertencias al 50 % y al 75 %?
Mostrar respuesta
Respuesta: Porque cero es demasiado tarde: quieres darte cuenta de un bucle descontrolado mientras aún queda dinero para investigarlo
El saldo es una parada en seco, no una alarma. Los umbrales tempranos convierten una sorpresa al 100 % en una pregunta el noveno día.
El registro: una línea por petición#
Cada respuesta de chat completion lleva un objeto usage con prompt_tokens y completion_. Eso es todo lo que necesita el informe, más una etiqueta de proyecto que añades tú. Este wrapper envía la petición y añade una línea a un archivo mensual (el nombre del archivo cambia cada mes, así que un mes nuevo empieza desde cero):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Usa el id de modelo completo de la documentación de CheapTokens (deepseek-, zai-); la API no acepta los nombres cortos de las tablas de precios. La clave viene de una variable de entorno, nunca del archivo.
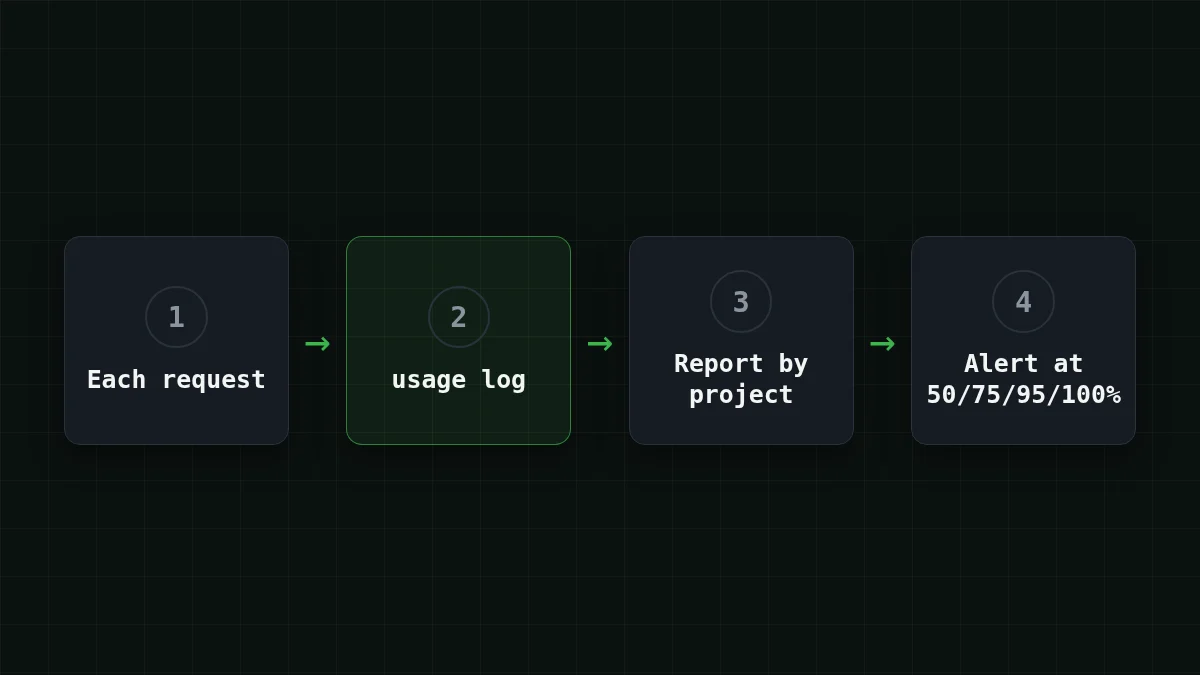
El script: coste por proyecto y alertas por umbral#
Guarda esto como report.py. Los precios son marcadores de posición: copia los actuales de la tabla de precios (aquí ambos modelos comparten un precio de ejemplo solo para que la aritmética sea legible).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
Las cuatro últimas líneas son la parte que la gente olvida. Sin el pequeño archivo de estado, el script gritaría "superado el 50 %" en cada ejecución durante el resto del mes. Con él, cada nivel se dispara una sola vez.
Ejecútalo y lee el resultado#
Toma un registro de juguete de cuatro líneas (uno real tiene una línea por petición, es decir, miles):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
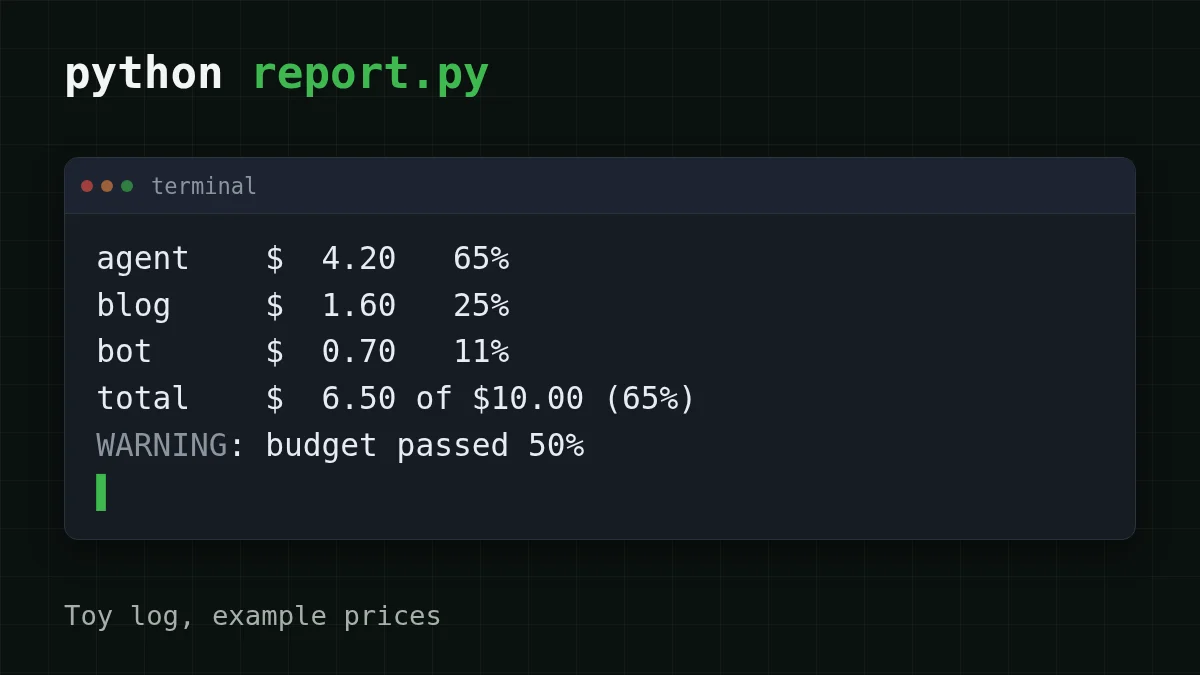
Con los precios de ejemplo y un presupuesto de 10, python report.py imprime:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
El agente es casi dos tercios de la factura, y la advertencia llegó al 50 %, no al final. Ejecútalo otra vez y la advertencia se queda callada hasta que el total alcanza el 75 %.
Para que esto funcione cada mes, necesitas tres pasos:
Paso a paso
Conéctalo en tres pasos
Registra cada llamada
Pasa todas tus llamadas por ask(project, model, messages) y elige una etiqueta de proyecto corta y estable. Cambiar las etiquetas a mitad de mes divide un proyecto en dos filas.
Define precios y presupuesto
Pon los precios actuales de la tabla de precios en PRICES y exporta tu límite: export BUDGET_.
Ejecútalo con una programación
Basta con una línea de cron cada hora: 0 * * * * cd ~/. Envía la salida a un comando de correo o de chat si quieres que la advertencia te llegue.
Cómo se ve un mes con modelos baratos#
Los números se vuelven útiles cuando son tus números. Supón que el agente del registro de juguete promedia 30.000 tokens de entrada y 2.000 de salida por paso, 20 pasos por tarea y dos tareas al día. Un paso con DeepSeek-V4-Flash cuesta $0.00065; con GLM-5.3-Flash, $0.00068. Un día son 40 pasos, un mes 1.200. Mueve los controles para que coincidan con tu propio agente:
Calculadora de costos
Un día del agente: pasos por tarea multiplicado por tareas al día
Tokens de entrada por solicitud: 30.000 · Tokens de salida por solicitud: 2000 · Solicitudes por día: 40
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
Y el mes con 1.200 pasos, contando entrada y salida juntas:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1200 solicitudes | OpenRouter, 1200 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30.000 tokens de entrada y 2000 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En total, contando entrada y salida juntas, ambos modelos salen más baratos que los precios de referencia de OpenRouter de esa tabla, con un único precio a cualquier hora y sin recargo en horas punta. DeepSeek-V4-Flash también permite hasta 32.768 tokens de salida por respuesta y un contexto de 380K; GLM-5.3-Flash tiene un contexto de 390K. Una vez que el informe muestra qué proyecto es el que pesa, cambiar solo la cadena model de ese proyecto es un cambio de una línea, y un saldo cubre todos los modelos. Para saber cuántos tokens usa realmente una sola petición, consulta cuántos tokens usa una petición a la API; para detener a mitad una ejecución de un agente, consulta seguimiento del coste de tokens de agentes de IA. Los precios y los modelos están en la página de modelos de CheapTokens.
Dónde falla esto#
- Falta un modelo en
PRICES. El script se detiene con unKeyErrorque nombra el modelo. Añádelo; no uses cero por defecto, o el proyecto parecerá gratis. - Llamadas en streaming. El fragmento final lleva el uso solo si lo pides (
stream_en el SDK de OpenAI). Si no, tu registro tendrá huecos.options={"include_ usage": True} - Peticiones fallidas. Registra solo las respuestas que tengan un objeto
usage; una petición que dio error no tiene nada que contar. - Informes por persona. Mantén la etiqueta como nombre de proyecto o de agente. Un informe sobre personas invita a conclusiones equivocadas.


