Suivez la dépense API par projet et recevez des alertes de budget en Python
Un court script Python transforme votre journal d'utilisation en rapport de coût par projet et avertit à 50, 75, 95 et 100 % d'un budget mensuel.
Sur cette page
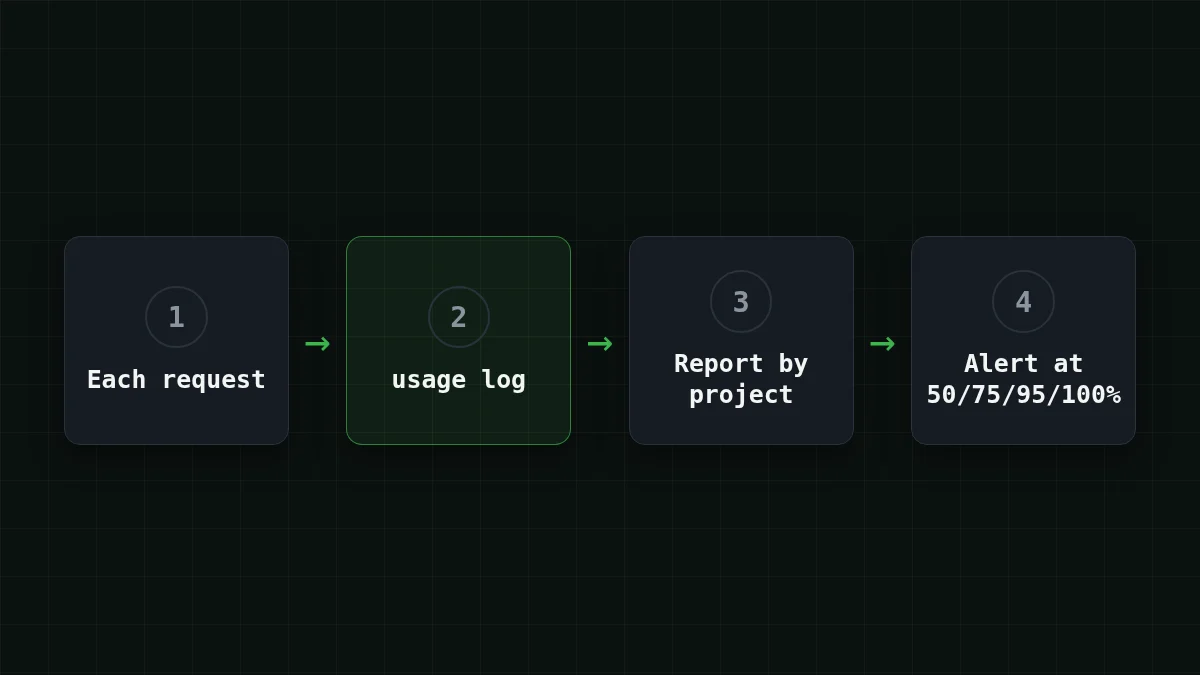
Ajoutez une ligne JSON à un fichier après chaque appel API, marquez-la avec un nom de projet, et laissez un script Python de 30 lignes transformer ce fichier en rapport de coût par projet et en alerte à 50, 75, 95 et 100 % de votre budget mensuel. C'est la même vue qu'Anthropic vient d'offrir aux équipes Claude Enterprise, construite à partir de votre propre journal.
Disons qu'un solde alimente un agent, un script de rédaction d'articles et un petit bot de support. La fin du mois arrive, le solde est plus bas que prévu, et rien ne vous dit lequel des trois en est responsable. C'est ce manque que ceci comble.
Ce qu'Anthropic a livré, et ce que vous pouvez copier#
L'annonce d'Anthropic (28 octobre 2026) couvre des rapports intelligents, des enquêtes intégrées et des budgets de groupe mutualisés, disponibles uniquement sur les offres Claude Enterprise (source). Deux parties comptent ici. Un rapport regroupe le travail d'une équipe en flux de travail et affiche la dépense de chacun. Un budget mutualisé est un nombre mensuel partagé, et les administrateurs de facturation reçoivent un e-mail à 50 %, 75 %, 95 % et 100 % de celui-ci. Anthropic ajoute que les rapports servent à planifier les investissements, pas à juger des personnes.
Vous n'avez pas besoin d'une offre entreprise pour la même forme. Un flux de travail n'est qu'un libellé que vous choisissez, et les quatre seuils sont une liste dans le code. Regroupez par projet, pas par personne, pour la raison qu'Anthropic donne.
Vérification rapide
Votre solde prépayé arrête déjà les requêtes à zéro. Pourquoi ajouter des alertes à 50 % et 75 % ?
Afficher la réponse
Réponse: Parce que zéro est trop tard : vous voulez remarquer une boucle emballée tant qu'il reste de l'argent pour enquêter
Le solde est un arrêt net, pas une alarme. Des seuils précoces transforment une surprise à 100 % en une question au neuvième jour.
Le journal : une ligne par requête#
Chaque réponse de complétion de chat porte un objet usage avec prompt_tokens et completion_. C'est tout ce dont le rapport a besoin, plus un libellé de projet que vous ajoutez vous-même. Ce wrapper envoie la requête et ajoute une ligne à un fichier mensuel (le nom du fichier change chaque mois, donc un nouveau mois repart de zéro) :
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Utilisez l'identifiant de modèle complet de la documentation CheapTokens (deepseek-, zai-) ; les noms courts des tableaux de prix ne sont pas acceptés par l'API. La clé provient d'une variable d'environnement, jamais du fichier.
Le script : coût par projet et alertes de seuil#
Enregistrez ceci sous report.py. Les prix sont des espaces réservés : copiez les prix actuels depuis le tableau des tarifs (les deux modèles partagent un seul prix d'exemple ici uniquement pour garder l'arithmétique lisible).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
Les quatre dernières lignes sont la partie que les gens oublient. Sans le petit fichier d'état, le script crierait « 50 % dépassé » à chaque exécution pour le reste du mois. Avec lui, chaque niveau se déclenche une fois.
Lancez-le et lisez le résultat#
Prenez un journal jouet de quatre lignes (un vrai a une ligne par requête, donc des milliers) :
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
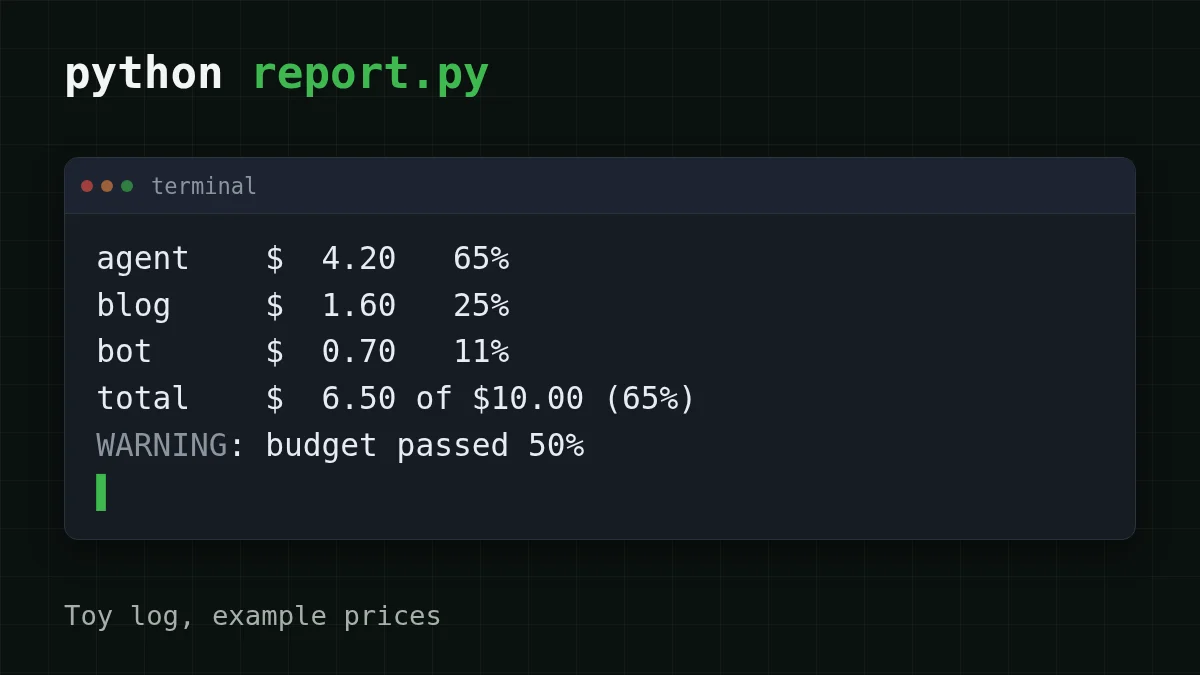
Avec les prix d'exemple et un budget de 10, python report.py affiche :
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
L'agent représente près des deux tiers de la facture, et l'alerte est arrivée à 50 %, pas à la fin. Relancez-le et l'alerte reste silencieuse jusqu'à ce que le total atteigne 75 %.
Pour que cela fonctionne chaque mois, il vous faut trois étapes :
Étape par étape
Mettez-le en place en trois étapes
Journalisez chaque appel
Faites passer tous vos appels par ask(project, model, messages) et choisissez un libellé de projet court et stable. Renommer les libellés en cours de mois divise un projet en deux lignes.
Définissez les prix et le budget
Placez les prix actuels du tableau des tarifs dans PRICES, et exportez votre limite : export BUDGET_.
Exécutez-le selon un planning
Une ligne cron horaire suffit : 0 * * * * cd ~/. Envoyez la sortie vers une commande de mail ou de chat si vous voulez que l'alerte vous soit poussée.
À quoi ressemble un mois sur des modèles bon marché#
Les chiffres deviennent utiles une fois qu'ils sont les vôtres. Supposez que l'agent du journal jouet consomme en moyenne 30 000 tokens d'entrée et 2 000 tokens de sortie par étape, 20 étapes par tâche, deux tâches par jour. Une étape sur DeepSeek-V4-Flash coûte $0.00065 ; sur GLM-5.3-Flash, $0.00068. Un jour fait 40 étapes, un mois 1 200. Déplacez les curseurs pour correspondre à votre propre agent :
Calculateur de coût
Une journée de l'agent : étapes par tâche fois tâches par jour
Tokens d'entrée par requête: 30 000 · Tokens de sortie par requête: 2 000 · Requêtes par jour: 40
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
Et le mois à 1 200 étapes, entrée et sortie comptées ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 200 requêtes | OpenRouter, 1 200 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30 000 tokens d'entrée et 2 000 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, entrée et sortie comptées ensemble, les deux modèles reviennent moins cher que les prix de référence d'OpenRouter dans ce tableau, avec un prix à toute heure et sans surcoût de pointe. DeepSeek-V4-Flash autorise aussi jusqu'à 32 768 tokens de sortie par réponse et un contexte de 380K ; GLM-5.3-Flash a un contexte de 390K. Une fois que le rapport montre quel projet est le plus lourd, changer uniquement la chaîne model de ce projet est une modification d'une ligne, et un seul solde couvre tous les modèles. Pour savoir combien de tokens une seule requête utilise réellement, voir combien de tokens une requête API utilise ; pour arrêter une exécution d'agent en cours de route, voir suivi du coût en tokens d'un agent IA. Les prix et les modèles sont sur la page des modèles CheapTokens.
Où cela se passe mal#
- Un modèle manque dans
PRICES. Le script s'arrête avec unKeyErrorqui nomme le modèle. Ajoutez-le ; ne mettez pas zéro par défaut, sinon le projet semble gratuit. - Appels en streaming. Le dernier chunk ne porte l'utilisation que si vous la demandez (
stream_dans le SDK OpenAI). Sinon, votre journal a des trous.options={"include_ usage": True} - Requêtes échouées. Ne journalisez que les réponses qui ont un objet
usage; une requête qui a échoué n'a rien à compter. - Rapports par personne. Gardez le libellé sur un nom de projet ou d'agent. Un rapport sur des personnes invite à de mauvaises conclusions.


