การลดต้นทุนคู่มือ
ติดตามค่าใช้จ่าย API ต่อโปรเจกต์และรับการแจ้งเตือนงบประมาณใน Python
สคริปต์ Python สั้นๆ เปลี่ยนบันทึกการใช้งานของคุณเป็นรายงานค่าใช้จ่ายต่อโปรเจกต์และเตือนที่ 50, 75, 95 และ 100% ของงบประมาณรายเดือน
ในหน้านี้
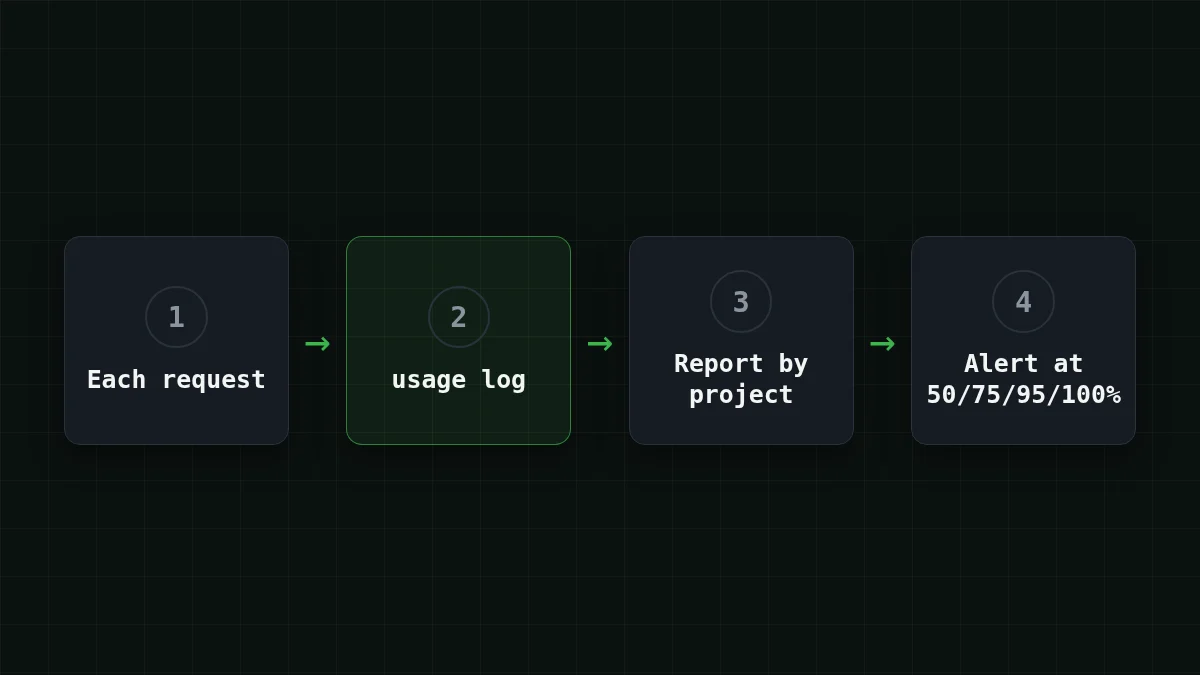
เพิ่มบรรทัด JSON หนึ่งบรรทัดลงในไฟล์หลังทุกการเรียก API ติดแท็กด้วยชื่อโปรเจกต์ แล้วให้สคริปต์ Python 30 บรรทัดเปลี่ยนไฟล์นั้นเป็นรายงานค่าใช้จ่ายต่อโปรเจกต์และคำเตือนที่ 50, 75, 95 และ 100% ของงบประมาณรายเดือนของคุณ นี่คือมุมมองเดียวกับที่ Anthropic เพิ่งมอบให้ทีม Claude Enterprise สร้างจากบันทึกของคุณเอง
สมมติว่ายอดเงินหนึ่งยอดเลี้ยงเอเจนต์ สคริปต์ร่างบล็อก และบอทซัพพอร์ตเล็กๆ ปลายเดือนมาถึง ยอดเงินต่ำกว่าที่หวัง และไม่มีอะไรบอกคุณว่าหนึ่งในสามตัวนั้นทำอะไร นี่คือช่องว่างที่ปิดได้
Anthropic ปล่อยอะไร และคุณคัดลอกอะไรได้#
ประกาศของ Anthropic (28 ตุลาคม 2026) ครอบคลุมรายงานอัจฉริยะ แบบสำรวจในแอป และงบประมาณกลุ่มแบบรวม ซึ่งพร้อมใช้งานทั่วไปเฉพาะในแผน Claude Enterprise (แหล่งที่มา) มีสองส่วนที่สำคัญตรงนี้ รายงานจัดกลุ่มงานของทีมเป็นเวิร์กสตรีมและแสดงค่าใช้จ่ายของแต่ละอัน งบประมาณแบบรวมคือตัวเลขรายเดือนที่แชร์กันหนึ่งตัว และผู้ดูแลการเรียกเก็บเงินจะได้รับอีเมลที่ 50%, 75%, 95% และ 100% ของงบ Anthropic เสริมว่ารายงานมีไว้เพื่อวางแผนการลงทุน ไม่ใช่เพื่อตัดสินรายบุคคล
คุณไม่จำเป็นต้องมีแผน enterprise เพื่อรูปร่างแบบเดียวกัน เวิร์กสตรีมเป็นเพียงป้ายกำกับที่คุณเลือก และสี่เกณฑ์คือลิสต์เดียวในโค้ด จัดกลุ่มตามโปรเจกต์ ไม่ใช่ตามบุคคล ด้วยเหตุผลที่ Anthropic ให้ไว้
เช็กด่วน
ยอดเงินเติมล่วงหน้าของคุณหยุดคำขอที่ศูนย์อยู่แล้ว ทำไมต้องเพิ่มคำเตือนที่ 50% และ 75%?
แสดงคำตอบ
คำตอบ: เพราะศูนย์สายเกินไป: คุณอยากสังเกตลูปที่หลุดควบคุมขณะที่ยังมีเงินให้ตรวจสอบ
ยอดเงินคือจุดหยุดแข็ง ไม่ใช่สัญญาณเตือน เกณฑ์เริ่มต้นเปลี่ยนความประหลาดใจที่ 100% เป็นคำถามในวันที่เก้า
บันทึก: หนึ่งบรรทัดต่อคำขอ#
ทุกการตอบกลับแชทคอมพลีชันมีออบเจกต์ usage พร้อม prompt_tokens และ completion_ นั่นคือทั้งหมดที่รายงานต้องการ บวกป้ายกำกับโปรเจกต์ที่คุณเพิ่มเอง ตัวห่อนี้ส่งคำขอและต่อท้ายหนึ่งบรรทัดลงในไฟล์รายเดือน (ชื่อไฟล์เปลี่ยนทุกเดือน เดือนใหม่จึงเริ่มจากศูนย์):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
ใช้ id โมเดลแบบเต็มจาก เอกสาร CheapTokens (deepseek-, zai-); ชื่อสั้นจากตารางราคาไม่ได้รับการยอมรับจาก API คีย์มาจากตัวแปรสภาพแวดล้อม ไม่ใช่จากไฟล์
สคริปต์: ค่าใช้จ่ายต่อโปรเจกต์และการแจ้งเตือนตามเกณฑ์#
บันทึกเป็น report.py ราคาเป็นตัวยึดตำแหน่ง: คัดลอกราคาปัจจุบันจากตารางราคา (ทั้งสองโมเดลใช้ราคาตัวอย่างเดียวกันที่นี่เพียงเพื่อให้การคำนวณอ่านง่าย)
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
สี่บรรทัดสุดท้ายคือส่วนที่คนลืม หากไม่มีไฟล์สถานะเล็กๆ สคริปต์จะตะโกน "ผ่าน 50%" ทุกครั้งที่รันตลอดเดือนที่เหลือ ด้วยไฟล์นี้ แต่ละระดับจะทำงานครั้งเดียว
รันและอ่านผลลัพธ์#
ใช้บันทึกตัวอย่างสี่บรรทัด (ของจริงมีหนึ่งบรรทัดต่อคำขอ ดังนั้นเป็นพันๆ):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
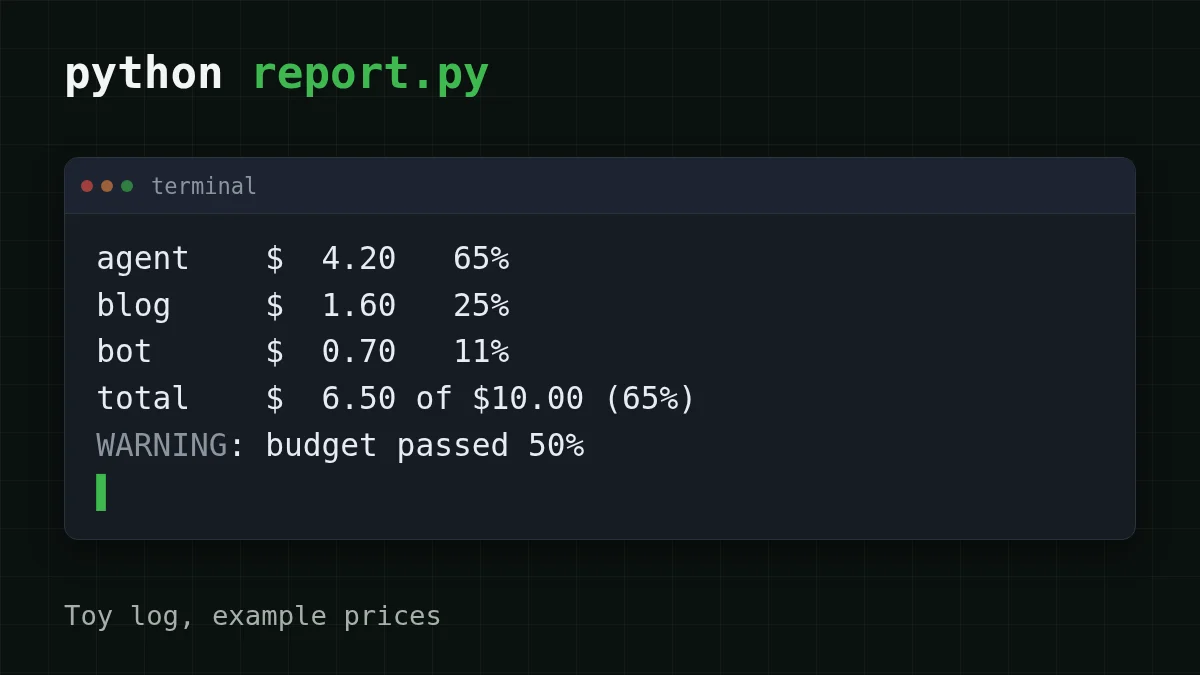
ด้วยราคาตัวอย่างและงบประมาณ 10, python report.py พิมพ์:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
เอเจนต์คิดเกือบสองในสามของบิล และคำเตือนมาเมื่อ 50% ไม่ใช่ตอนจบ รันอีกครั้งคำเตือนจะเงียบจนกว่ายอดรวมจะถึง 75%
เพื่อให้สิ่งนี้ทำงานทุกเดือน คุณต้องมีสามขั้นตอน:
ทีละขั้นตอน
เชื่อมต่อในสามขั้นตอน
บันทึกทุกการเรียก
ส่งทุกการเรียกผ่าน ask(project, model, messages) และเลือกป้ายกำกับโปรเจกต์ที่สั้นและคงที่ การเปลี่ยนชื่อป้ายกลางเดือนจะแยกโปรเจกต์หนึ่งเป็นสองแถว
ตั้งราคาและงบประมาณ
ใส่ราคาปัจจุบันจากตารางราคาลงใน PRICES และส่งออกขีดจำกัดของคุณ: export BUDGET_
รันตามกำหนดการ
บรรทัด cron รายชั่วโมงก็เพียงพอ: 0 * * * * cd ~/ ส่งเอาต์พุตไปยังคำสั่งเมลหรือแชทหากต้องการให้คำเตือนถูกส่งถึงคุณ
หนึ่งเดือนบนโมเดลราคาถูกเป็นอย่างไร#
ตัวเลขจะมีประโยชน์เมื่อเป็นตัวเลขของคุณ สมมติว่าเอเจนต์จากบันทึกตัวอย่างใช้เฉลี่ย 30,000 โทเค็นอินพุตและ 2,000 โทเค็นเอาต์พุตต่อขั้น 20 ขั้นต่องาน สองงานต่อวัน หนึ่งขั้นบน DeepSeek-V4-Flash ราคา $0.00065; บน GLM-5.3-Flash, $0.00068 หนึ่งวันคือ 40 ขั้น หนึ่งเดือน 1,200 เลื่อนสไลเดอร์ให้ตรงกับเอเจนต์ของคุณเอง:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของเอเจนต์: ขั้นต่องานคูณงานต่อวัน
โทเค็นอินพุตต่อคำขอ: 30,000 · โทเค็นเอาต์พุตต่อคำขอ: 2,000 · คำขอต่อวัน: 40
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
และหนึ่งเดือนที่ 1,200 ขั้น โดยนับอินพุตและเอาต์พุตรวมกัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,200 คำขอ | OpenRouter, 1,200 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30,000 โทเค็นอินพุตและ 2,000 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน ทั้งสองโมเดลออกมาถูกกว่าราคาอ้างอิงของ OpenRouter ในตารางนั้น ด้วยราคาเดียวทุกชั่วโมงและไม่มีค่าธรรมเนียมช่วงพีค DeepSeek-V4-Flash ยังอนุญาตเอาต์พุตสูงสุด 32,768 โทเค็นต่อคำตอบและบริบท 380K; GLM-5.3-Flash มีบริบท 390K เมื่อรายงานแสดงว่าโปรเจกต์ใดหนัก การเปลี่ยนสตริง model ของโปรเจกต์นั้นเพียงอย่างเดียวคือการแก้ไขหนึ่งบรรทัด และยอดเงินหนึ่งยอดครอบคลุมทุกโมเดล สำหรับจำนวนโทเค็นที่คำขอเดียวใช้จริง ดูจำนวนโทเค็นที่คำขอ API ใช้; สำหรับการหยุดการรันเอเจนต์กลางคัน ดูการติดตามค่าใช้จ่ายโทเค็นของเอเจนต์ AI ราคาและโมเดลอยู่ที่หน้าโมเดล CheapTokens
จุดที่ผิดพลาด#
- โมเดลหายไปจาก
PRICESสคริปต์หยุดด้วยKeyErrorที่ระบุชื่อโมเดล เพิ่มมัน; อย่าตั้งค่าเริ่มต้นเป็นศูนย์ ไม่งั้นโปรเจกต์ดูเหมือนฟรี - การเรียกแบบสตรีมมิ่ง ชังก์สุดท้ายมีข้อมูลการใช้งานเฉพาะเมื่อคุณขอ (
stream_ใน OpenAI SDK) มิฉะนั้นบันทึกของคุณมีช่องว่างoptions={"include_ usage": True} - คำขอที่ล้มเหลว บันทึกเฉพาะการตอบกลับที่มีออบเจกต์
usage; คำขอที่เกิดข้อผิดพลาดไม่มีอะไรให้นับ - รายงานรายบุคคล เก็บป้ายกำกับเป็นชื่อโปรเจกต์หรือเอเจนต์ รายงานเกี่ยวกับบุคคลนำไปสู่ข้อสรุปที่ผิด


