لاگت کی بہتریگائیڈ
Python میں فی پروجیکٹ API خرچ ٹریک کریں اور بجٹ الرٹس حاصل کریں
ایک مختصر Python اسکرپٹ آپ کے یوزیج لاگ کو فی پروجیکٹ لاگت کی رپورٹ میں بدل دیتی ہے اور ماہانہ بجٹ کے 50، 75، 95 اور 100% پر وارننگ دیتی ہے۔
اس صفحہ پر
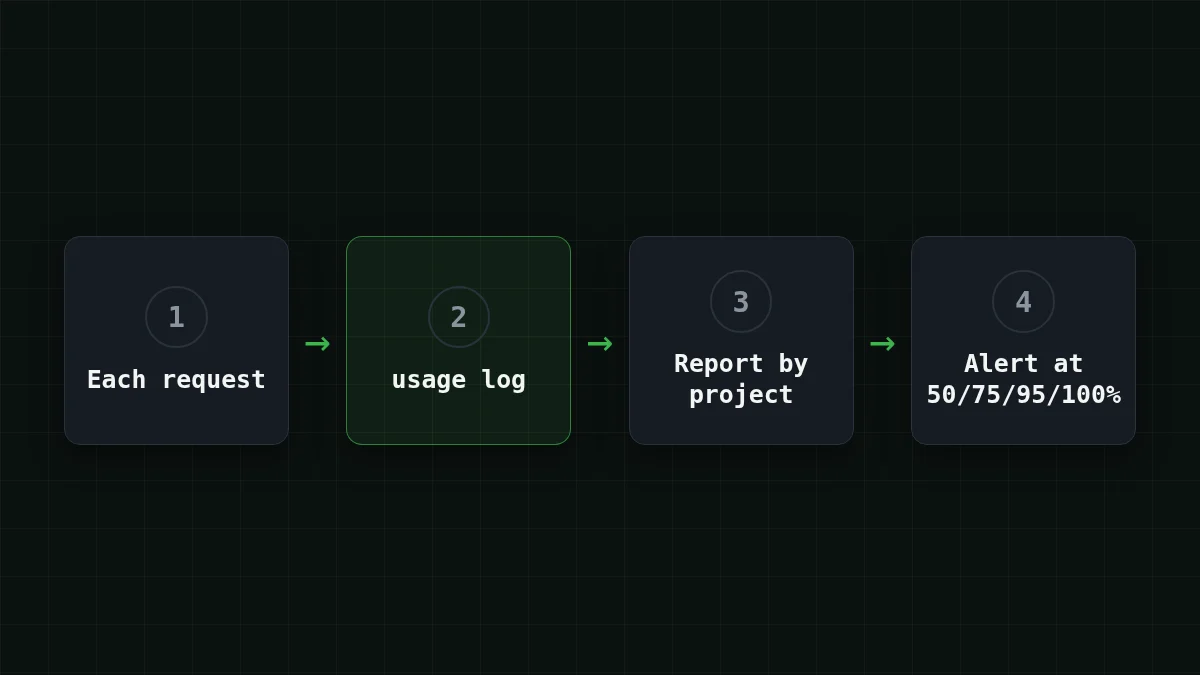
ہر API کال کے بعد فائل میں ایک JSON لائن شامل کریں، اسے پروجیکٹ کے نام سے ٹیگ کریں، اور ایک 30 لائنوں کی Python اسکرپٹ کو اس فائل سے فی پروجیکٹ لاگت کی رپورٹ اور آپ کے ماہانہ بجٹ کے 50، 75، 95 اور 100% پر وارننگ بنانے دیں۔ یہ وہی ویو ہے جو Anthropic نے ابھی Claude Enterprise ٹیموں کو دیا، آپ کے اپنے لاگ سے بنایا گیا۔
فرض کریں ایک بیلنس ایک ایجنٹ، ایک بلاگ ڈرافٹنگ اسکرپٹ اور ایک چھوٹے سپورٹ بوٹ کو فیڈ کرتا ہے۔ مہینے کا اختتام آتا ہے، بیلنس آپ کی توقع سے کم ہے، اور کوئی چیز نہیں بتاتی کہ تینوں میں سے کس نے یہ کیا۔ یہی وہ خلا ہے جو یہ بند کرتا ہے۔
Anthropic نے کیا جاری کیا، اور آپ کیا کاپی کر سکتے ہیں#
Anthropic کا اعلان (28 اکتوبر 2026) سمارٹ رپورٹس، ایپ میں سرویز اور پول شدہ گروپ بجٹس کا احاطہ کرتا ہے، جو عام طور پر صرف Claude Enterprise پلانز پر دستیاب ہیں (source)۔ یہاں دو حصے اہم ہیں۔ ایک رپورٹ ٹیم کے کام کو ورک اسٹریمز میں گروپ کرتی ہے اور ہر ایک کا خرچ دکھاتی ہے۔ پول شدہ بجٹ ایک مشترکہ ماہانہ نمبر ہے، اور بلنگ ایڈمنز کو اس کے 50%، 75%، 95% اور 100% پر ای میل ملتی ہے۔ Anthropic مزید کہتا ہے کہ رپورٹس سرمایہ کاری کی منصوبہ بندی کے لیے ہیں، افراد کا فیصلہ کرنے کے لیے نہیں۔
اسی شکل کے لیے آپ کو انٹرپرائز پلان کی ضرورت نہیں۔ ورک اسٹریم صرف ایک لیبل ہے جو آپ منتخب کرتے ہیں، اور چار تھریشولڈز کوڈ میں ایک فہرست ہیں۔ Anthropic کی دی گئی وجہ سے، شخص کے بجائے پروجیکٹ کے لحاظ سے گروپ کریں۔
فوری جانچ
آپ کا پری پیڈ بیلنس پہلے ہی صفر پر درخواستیں روک دیتا ہے۔ 50% اور 75% پر وارننگ کیوں شامل کریں؟
جواب دکھائیں
جواب: کیونکہ صفر بہت دیر ہے: آپ بھاگتے ہوئے لوپ کو تب نوٹس کرنا چاہتے ہیں جب ابھی پیسے موجود ہوں
بیلنس ایک سخت رکاوٹ ہے، الارم نہیں۔ ابتدائی تھریشولڈز 100% پر حیرت کو نویں دن کے سوال میں بدل دیتے ہیں۔
لاگ: فی درخواست ایک لائن#
ہر چیٹ کمپلیشن رسپانس میں usage آبجیکٹ ہوتا ہے جس میں prompt_tokens اور completion_ ہوتے ہیں۔ رپورٹ کو بس اتنا ہی چاہیے، اور ایک پروجیکٹ لیبل جو آپ خود شامل کرتے ہیں۔ یہ ریپر درخواست بھیجتا ہے اور ماہانہ فائل میں ایک لائن شامل کرتا ہے (فائل کا نام ہر مہینے بدلتا ہے، تاکہ نیا مہینہ صفر سے شروع ہو):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
CheapTokens docs سے مکمل ماڈل آئی ڈی استعمال کریں (deepseek-، zai-)؛ قیمت کی جدولوں کے مختصر نام API قبول نہیں کرتا۔ کلید ماحول کے متغیر سے آتی ہے، کبھی فائل سے نہیں۔
اسکرپٹ: فی پروجیکٹ لاگت اور تھریشولڈ الرٹس#
اسے report.py کے طور پر محفوظ کریں۔ قیمتیں پلیس ہولڈر ہیں: موجودہ قیمتیں pricing table سے کاپی کریں (دونوں ماڈلز یہاں صرف ایک مثال قیمت شیئر کرتے ہیں تاکہ حساب پڑھنے میں آسان رہے)۔
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
آخری چار لائنیں وہ حصہ ہیں جو لوگ بھول جاتے ہیں۔ چھوٹی اسٹیٹ فائل کے بغیر، اسکرپٹ مہینے کے باقی حصے میں ہر رن پر "50% پار ہو گیا" چلاتا رہے گا۔ اس کے ساتھ، ہر سطح ایک بار فائر ہوتی ہے۔
اسے چلائیں اور نتیجہ پڑھیں#
چار لائنوں کا ایک کھلونا لاگ لیں (اصل میں فی درخواست ایک لائن ہوتی ہے، یعنی ہزاروں):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
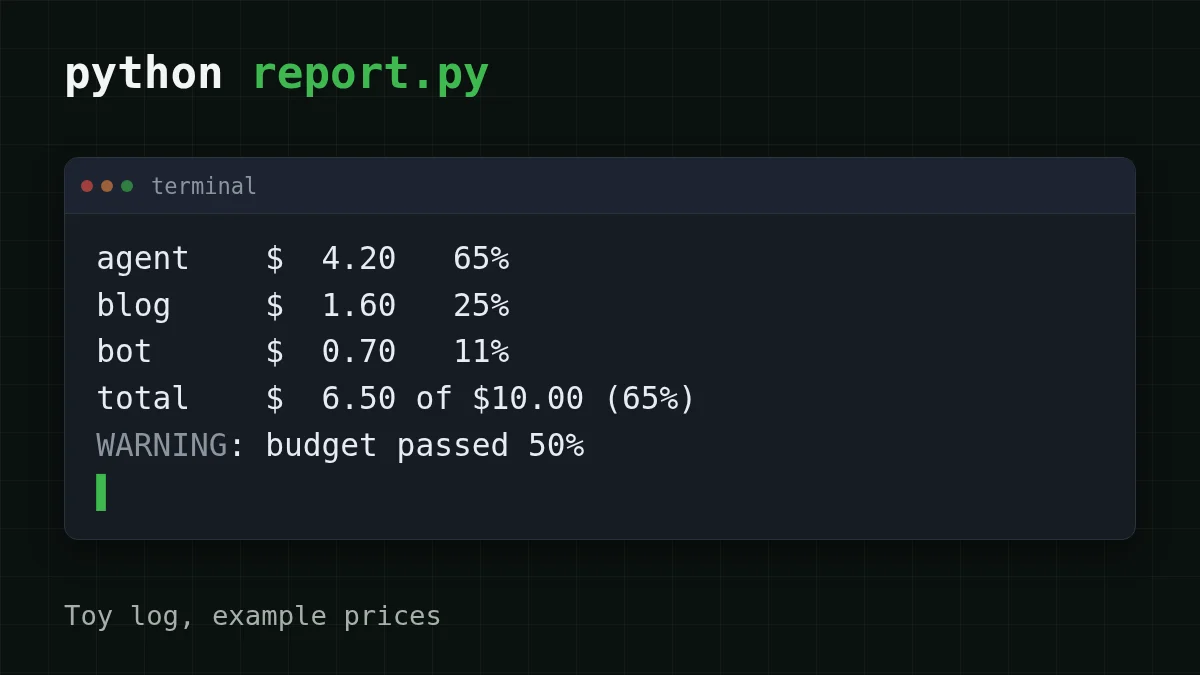
مثال کی قیمتوں اور 10 کے بجٹ کے ساتھ، python report.py یہ پرنٹ کرتا ہے:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
ایجنٹ بل کا تقریباً دو تہائی ہے، اور وارننگ 50% پر آئی، آخر میں نہیں۔ دوبارہ چلائیں اور وارننگ خاموش رہتی ہے جب تک کل 75% تک نہ پہنچ جائے۔
اسے ہر مہینے کام کرنے کے لیے، آپ کو تین مراحل چاہیے:
قدم بہ قدم
اسے تین مراحل میں وائر کریں
ہر کال لاگ کریں
اپنی تمام کالز ask(project, model, messages) کے ذریعے روٹ کریں اور ایک مختصر، مستحکم پروجیکٹ لیبل منتخب کریں۔ مہینے کے وسط میں لیبل کا نام بدلنا ایک پروجیکٹ کو دو قطاروں میں تقسیم کر دیتا ہے۔
قیمتیں اور بجٹ مقرر کریں
pricing table سے موجودہ قیمتیں PRICES میں ڈالیں، اور اپنی حد ایکسپورٹ کریں: export BUDGET_۔
اسے شیڈول پر چلائیں
ایک گھنٹہ وار cron لائن کافی ہے: 0 * * * * cd ~/۔ اگر آپ وارننگ خود تک پہنچانا چاہتے ہیں تو آؤٹ پٹ کو میل یا چیٹ کمانڈ پر بھیجیں۔
سستے ماڈلز پر ایک مہینہ کیسا لگتا ہے#
نمبر اس وقت کارآمد ہوتے ہیں جب وہ آپ کے نمبر ہوں۔ فرض کریں کھلونا لاگ کا ایجنٹ فی قدم اوسطاً 30,000 ان پٹ اور 2,000 آؤٹ پٹ ٹوکن، فی ٹاسک 20 قدم، دن میں دو ٹاسک استعمال کرتا ہے۔ DeepSeek-V4-Flash پر ایک قدم کی لاگت $0.00065 ہے؛ GLM-5.3-Flash پر، $0.00068۔ ایک دن 40 قدم، ایک مہینہ 1,200۔ سلائیڈرز کو اپنے ایجنٹ کے مطابق حرکت دیں:
لاگت کیلکولیٹر
ایجنٹ کا ایک دن: فی ٹاسک قدم ضرب فی دن ٹاسک
فی درخواست ان پٹ ٹوکنز: 30,000 · فی درخواست آؤٹ پٹ ٹوکنز: 2,000 · فی دن درخواستیں: 40
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
اور 1,200 قدموں پر مہینہ، ان پٹ اور آؤٹ پٹ ملا کر:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,200 درخواستیں | OpenRouter، 1,200 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
فی درخواست 30,000 ان پٹ اور 2,000 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
مجموعی طور پر، ان پٹ اور آؤٹ پٹ ملا کر، دونوں ماڈلز اس جدول میں OpenRouter کی حوالہ قیمتوں سے سستے نکلتے ہیں، کسی بھی وقت ایک قیمت اور کوئی پیک سرچارج نہیں۔ DeepSeek-V4-Flash فی جواب 32,768 آؤٹ پٹ ٹوکن اور 380K کانٹیکسٹ بھی اجازت دیتا ہے؛ GLM-5.3-Flash کا کانٹیکسٹ 390K ہے۔ جب رپورٹ دکھا دے کہ کون سا پروجیکٹ بھاری ہے، صرف اس پروجیکٹ کی model سٹرنگ بدلنا ایک لائن کی تبدیلی ہے، اور ایک بیلنس ہر ماڈل کو کور کرتا ہے۔ ایک درخواست واقعی کتنے ٹوکن استعمال کرتی ہے، how many tokens an API request uses دیکھیں؛ ایک ایجنٹ رن کو درمیان میں روکنے کے لیے، tracking AI agent token cost دیکھیں۔ قیمتیں اور ماڈلز CheapTokens models page پر ہیں۔
یہ کہاں غلط ہوتا ہے#
PRICESمیں ایک ماڈل غائب ہے۔ اسکرپٹKeyErrorکے ساتھ رک جاتا ہے جو ماڈل کا نام بتاتا ہے۔ اسے شامل کریں؛ صفر پر ڈیفالٹ نہ کریں، ورنہ پروجیکٹ مفت لگے گا۔- اسٹریمنگ کالز۔ آخری چنک صرف تب یوزیج لے کر آتا ہے جب آپ اس کی درخواست کریں (OpenAI SDK میں
stream_)۔ ورنہ آپ کے لاگ میں خلا رہے گا۔options={"include_ usage": True} - ناکام درخواستیں۔ صرف وہ رسپانس لاگ کریں جن میں
usageآبجیکٹ ہو؛ ایرر والی درخواست میں گننے کو کچھ نہیں۔ - فی شخص رپورٹس۔ لیبل کو پروجیکٹ یا ایجنٹ کے نام تک رکھیں۔ لوگوں کے بارے میں رپورٹ غلط نتائج کی دعوت دیتی ہے۔


