KostenoptimierungAnleitung
API-Ausgaben pro Projekt verfolgen und Budget-Warnungen in Python erhalten
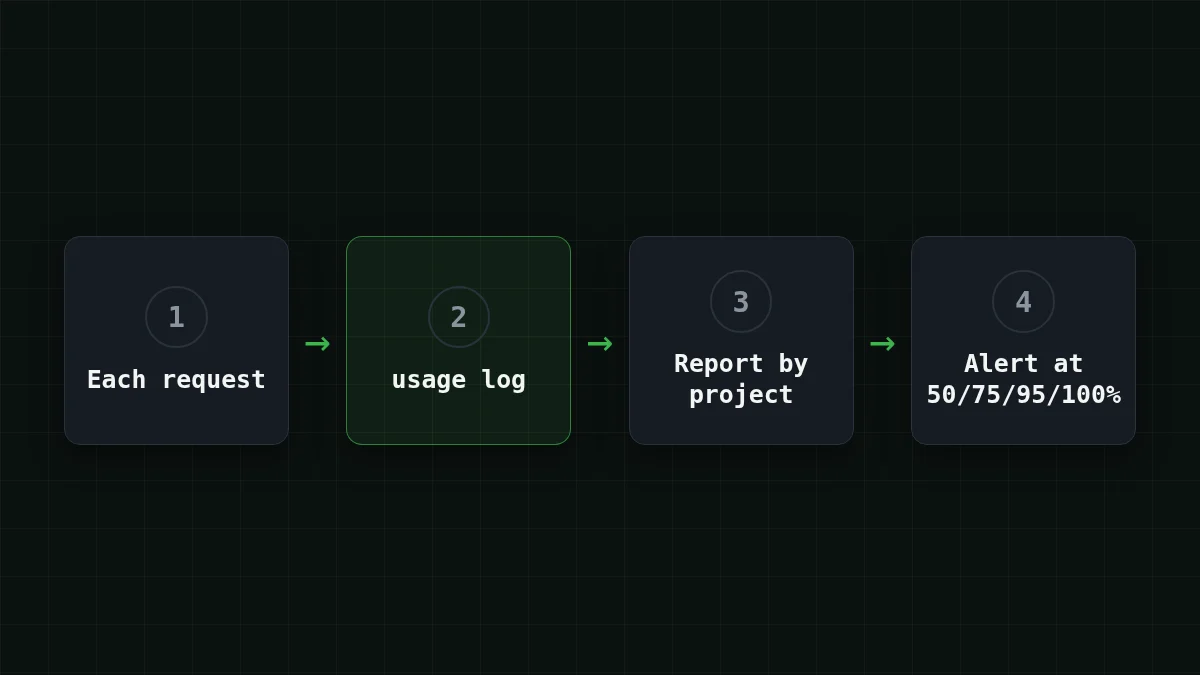
Ein kurzes Python-Skript verwandelt dein Usage-Log in einen Kosten-pro-Projekt-Bericht und warnt bei 50, 75, 95 und 100 % eines Monatsbudgets.
Auf dieser Seite
Füge nach jedem API-Aufruf eine JSON-Zeile an eine Datei an, versehe sie mit einem Projektnamen und lass ein 30-zeiliges Python-Skript diese Datei in einen Kosten-pro-Projekt-Bericht und eine Warnung bei 50, 75, 95 und 100 % deines Monatsbudgets verwandeln. Es ist dieselbe Ansicht, die Anthropic gerade Claude-Enterprise-Teams gegeben hat, gebaut aus deinem eigenen Log.
Sagen wir, ein Guthaben versorgt einen Agenten, ein Blog-Entwurfsskript und einen kleinen Support-Bot. Das Monatsende kommt, das Guthaben ist niedriger als erhofft, und nichts sagt dir, welcher der drei es verursacht hat. Genau diese Lücke schließt das hier.
Was Anthropic ausgeliefert hat und was du nachbauen kannst#
Anthropics Ankündigung (28. Oktober 2026) umfasst smarte Berichte, In-App-Umfragen und gepoolte Gruppenbudgets, allgemein verfügbar nur in Claude-Enterprise-Plänen (source). Zwei Teile sind hier relevant. Ein Bericht gruppiert die Arbeit eines Teams in Workstreams und zeigt die Ausgaben jedes einzelnen. Ein gepooltes Budget ist eine gemeinsame Monatszahl, und Billing-Admins bekommen eine E-Mail bei 50 %, 75 %, 95 % und 100 % davon. Anthropic ergänzt, dass die Berichte für die Investitionsplanung gedacht sind, nicht für die Beurteilung einzelner Personen.
Für dieselbe Form brauchst du keinen Enterprise-Plan. Ein Workstream ist nur ein Label, das du wählst, und die vier Schwellen sind eine Liste im Code. Gruppiere nach Projekt, nicht nach Person, aus dem Grund, den Anthropic nennt.
Kurzer Check
Dein Prepaid-Guthaben stoppt Anfragen bereits bei null. Warum Warnungen bei 50 % und 75 % hinzufügen?
Antwort anzeigen
Antwort: Weil null zu spät ist: Du willst eine durchgehende Schleife bemerken, solange noch Geld da ist, um ihr nachzugehen
Das Guthaben ist ein harter Stopp, kein Alarm. Frühe Schwellen machen aus einer Überraschung bei 100 % eine Frage am neunten Tag.
Das Log: eine Zeile pro Anfrage#
Jede Chat-Completion-Antwort trägt ein usage-Objekt mit prompt_tokens und completion_. Mehr braucht der Bericht nicht, plus ein Projektlabel, das du selbst hinzufügst. Dieser Wrapper sendet die Anfrage und hängt eine Zeile an eine Monatsdatei an (der Dateiname ändert sich jeden Monat, sodass ein neuer Monat bei null beginnt):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Verwende die vollständige Modell-ID aus der CheapTokens-Dokumentation (deepseek-, zai-); die Kurznamen aus Preistabellen werden von der API nicht akzeptiert. Der Schlüssel kommt aus einer Umgebungsvariable, niemals aus der Datei.
Das Skript: Kosten pro Projekt und Schwellenwert-Warnungen#
Speichere dies als report.py. Die Preise sind Platzhalter: Kopiere die aktuellen aus der Preistabelle (beide Modelle teilen hier nur einen Beispielpreis, damit die Arithmetik lesbar bleibt).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
Die letzten vier Zeilen sind der Teil, den Leute vergessen. Ohne die kleine State-Datei würde das Skript für den Rest des Monats bei jedem Lauf „50 % überschritten“ schreien. Mit ihr feuert jede Stufe einmal.
Ausführen und das Ergebnis lesen#
Nimm ein Spielzeug-Log mit vier Zeilen (ein echtes hat eine Zeile pro Anfrage, also Tausende):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
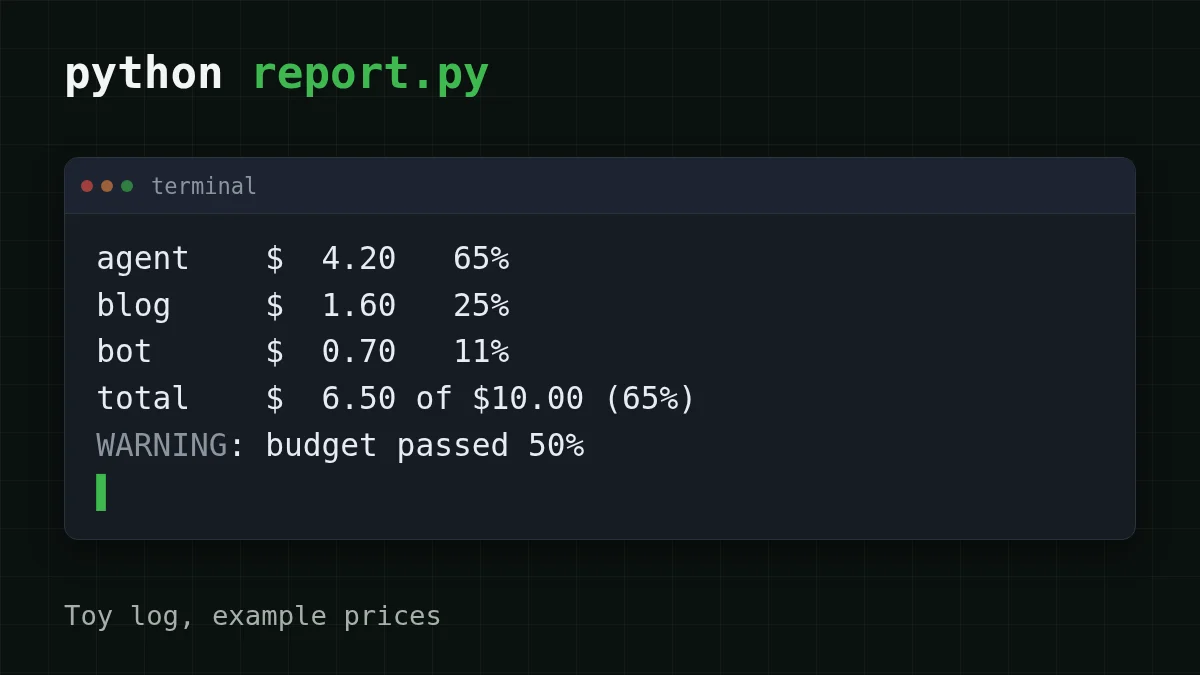
Mit den Beispielpreisen und einem Budget von 10 gibt python report.py aus:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
Der Agent macht fast zwei Drittel der Rechnung aus, und die Warnung kam bei 50 %, nicht am Ende. Führe es erneut aus, und die Warnung bleibt still, bis die Summe 75 % erreicht.
Damit das jeden Monat funktioniert, brauchst du drei Schritte:
Schritt für Schritt
In drei Schritten einrichten
Jeden Aufruf loggen
Leite alle deine Aufrufe durch ask(project, model, messages) und wähle ein kurzes, stabiles Projektlabel. Das Umbenennen von Labels mitten im Monat spaltet ein Projekt in zwei Zeilen.
Preise und Budget setzen
Trage die aktuellen Preise aus der Preistabelle in PRICES ein und exportiere dein Limit: export BUDGET_.
Nach Zeitplan ausführen
Eine stündliche Cron-Zeile reicht: 0 * * * * cd ~/. Leite die Ausgabe an einen Mail- oder Chat-Befehl, wenn du die Warnung zugeschickt bekommen willst.
Wie ein Monat mit günstigen Modellen aussieht#
Zahlen werden nützlich, sobald es deine Zahlen sind. Nimm an, der Agent aus dem Spielzeug-Log verbraucht im Schnitt 30.000 Input- und 2.000 Output-Tokens pro Schritt, 20 Schritte pro Aufgabe, zwei Aufgaben pro Tag. Ein Schritt auf DeepSeek-V4-Flash kostet $0.00065; auf GLM-5.3-Flash $0.00068. Ein Tag sind 40 Schritte, ein Monat 1.200. Verschiebe die Regler passend zu deinem eigenen Agenten:
Kostenrechner
Ein Tag des Agenten: Schritte pro Aufgabe mal Aufgaben pro Tag
Eingabe-Tokens pro Anfrage: 30.000 · Ausgabe-Tokens pro Anfrage: 2.000 · Anfragen pro Tag: 40
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
Und der Monat bei 1.200 Schritten, mit Input und Output zusammengezählt:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.200 Anfragen | OpenRouter, 1.200 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30.000 Input- und 2.000 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt, mit Input und Output zusammengezählt, kommen beide Modelle günstiger heraus als OpenRouters Referenzpreise in dieser Tabelle, mit einem Preis zu jeder Stunde und ohne Peak-Zuschlag. DeepSeek-V4-Flash erlaubt außerdem bis zu 32.768 Output-Tokens pro Antwort und einen 380K-Kontext; GLM-5.3-Flash hat einen 390K-Kontext. Sobald der Bericht zeigt, welches Projekt das schwere ist, ist das Umschalten nur des model-Strings dieses Projekts eine Ein-Zeilen-Änderung, und ein Guthaben deckt jedes Modell ab. Wie viele Tokens eine einzelne Anfrage wirklich verbraucht, steht in how many tokens an API request uses; wie man einen Agentenlauf mittendrin stoppt, in tracking AI agent token cost. Preise und Modelle stehen auf der CheapTokens-Modellseite.
Wo das schiefgeht#
- Ein Modell fehlt in
PRICES. Das Skript stoppt mit einemKeyError, das das Modell nennt. Füge es hinzu; setze nicht standardmäßig null, sonst sieht das Projekt kostenlos aus. - Streaming-Aufrufe. Der letzte Chunk trägt Usage nur, wenn du danach fragst (
stream_im OpenAI SDK). Sonst hat dein Log Lücken.options={"include_ usage": True} - Fehlgeschlagene Anfragen. Logge nur Antworten, die ein
usage-Objekt haben; eine Anfrage, die mit Fehler abbrach, hat nichts zu zählen. - Berichte pro Person. Halte das Label bei einem Projekt- oder Agentennamen. Ein Bericht über Personen lädt zu falschen Schlüssen ein.


