लागत अनुकूलनगाइड
Python में प्रति प्रोजेक्ट API खर्च ट्रैक करें और बजट अलर्ट पाएँ
एक छोटी Python स्क्रिप्ट आपके उपयोग लॉग को प्रति-प्रोजेक्ट लागत रिपोर्ट में बदल देती है और मासिक बजट के 50, 75, 95 और 100% पर चेतावनी देती है।
इस पृष्ठ पर
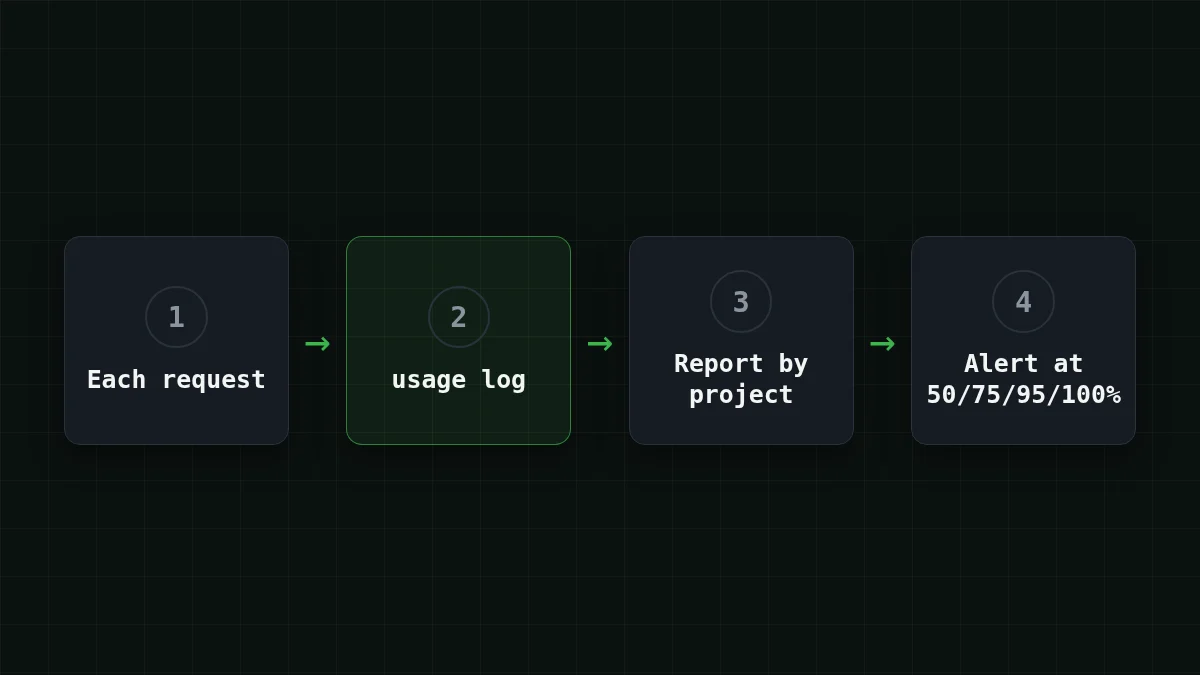
हर API कॉल के बाद फ़ाइल में एक JSON लाइन जोड़ें, उसे प्रोजेक्ट नाम से टैग करें, और एक 30-लाइन की Python स्क्रिप्ट उस फ़ाइल को प्रति-प्रोजेक्ट लागत रिपोर्ट और आपके मासिक बजट के 50, 75, 95 और 100% पर चेतावनी में बदल देगी। यह वही दृश्य है जो Anthropic ने अभी Claude Enterprise टीमों को दिया है, आपके अपने लॉग से बनाया गया।
मान लीजिए एक बैलेंस एक एजेंट, एक ब्लॉग-ड्राफ़्टिंग स्क्रिप्ट और एक छोटे सपोर्ट बॉट को फ़ीड करता है। महीने का अंत आता है, बैलेंस आपकी उम्मीद से कम है, और कुछ भी नहीं बताता कि तीनों में से किसने ऐसा किया। यही वह अंतराल है जिसे यह बंद करता है।
Anthropic ने क्या जारी किया, और आप क्या कॉपी कर सकते हैं#
Anthropic की घोषणा (28 अक्टूबर 2026) में स्मार्ट रिपोर्ट, इन-ऐप सर्वे और पूल्ड ग्रुप बजट शामिल हैं, जो सामान्यतः केवल Claude Enterprise प्लान पर उपलब्ध हैं (source)। यहाँ दो हिस्से मायने रखते हैं। एक रिपोर्ट किसी टीम के काम को वर्कस्ट्रीम में समूहित करती है और हर एक का खर्च दिखाती है। एक पूल्ड बजट एक साझा मासिक संख्या है, और बिलिंग एडमिन को इसके 50%, 75%, 95% और 100% पर ईमेल मिलता है। Anthropic जोड़ता है कि रिपोर्ट निवेश की योजना बनाने के लिए हैं, व्यक्तिगत लोगों को आंकने के लिए नहीं।
आपको उसी आकार के लिए एंटरप्राइज़ प्लान की ज़रूरत नहीं है। एक वर्कस्ट्रीम बस एक लेबल है जिसे आप चुनते हैं, और चार थ्रेशोल्ड कोड में एक सूची हैं। Anthropic द्वारा दिए गए कारण से, व्यक्ति के बजाय प्रोजेक्ट के अनुसार समूहित करें।
त्वरित जाँच
आपका प्रीपेड बैलेंस पहले से ही शून्य पर अनुरोध रोकता है। 50% और 75% पर चेतावनी क्यों जोड़ें?
उत्तर दिखाएँ
उत्तर: क्योंकि शून्य बहुत देर हो चुकी है: आप एक भागती हुई लूप को तब नोटिस करना चाहते हैं जब जाँच करने के लिए अभी पैसा बचा हो
बैलेंस एक हार्ड स्टॉप है, अलार्म नहीं। शुरुआती थ्रेशोल्ड 100% पर आने वाले आश्चर्य को नौवें दिन के एक सवाल में बदल देते हैं।
लॉग: प्रति अनुरोध एक लाइन#
हर चैट कम्प्लीशन प्रतिक्रिया में prompt_tokens और completion_ वाला एक usage ऑब्जेक्ट होता है। रिपोर्ट को बस इतना ही चाहिए, साथ में एक प्रोजेक्ट लेबल जो आप स्वयं जोड़ते हैं। यह रैपर अनुरोध भेजता है और मासिक फ़ाइल में एक लाइन जोड़ता है (फ़ाइल का नाम हर महीने बदलता है, इसलिए नया महीना शून्य से शुरू होता है):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
CheapTokens docs से पूरा मॉडल id इस्तेमाल करें (deepseek-, zai-); प्राइस टेबल के छोटे नाम API स्वीकार नहीं करता। कुंजी एनवायरनमेंट वेरिएबल से आती है, कभी फ़ाइल से नहीं।
स्क्रिप्ट: प्रति प्रोजेक्ट लागत और थ्रेशोल्ड अलर्ट#
इसे report.py के रूप में सहेजें। कीमतें प्लेसहोल्डर हैं: वर्तमान वाली pricing table से कॉपी करें (यहाँ दोनों मॉडल एक ही उदाहरण कीमत साझा करते हैं केवल अंकगणित को पठनीय रखने के लिए)।
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
अंतिम चार लाइनें वह हिस्सा हैं जिसे लोग भूल जाते हैं। छोटी स्टेट फ़ाइल के बिना, स्क्रिप्ट महीने के बाकी हिस्से में हर रन पर "50% पार हो गया" चिल्लाती रहेगी। इसके साथ, हर स्तर एक बार फ़ायर होता है।
इसे चलाएँ और परिणाम पढ़ें#
चार लाइनों का एक खिलौना लॉग लें (असली में प्रति अनुरोध एक लाइन होती है, यानी हज़ारों):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
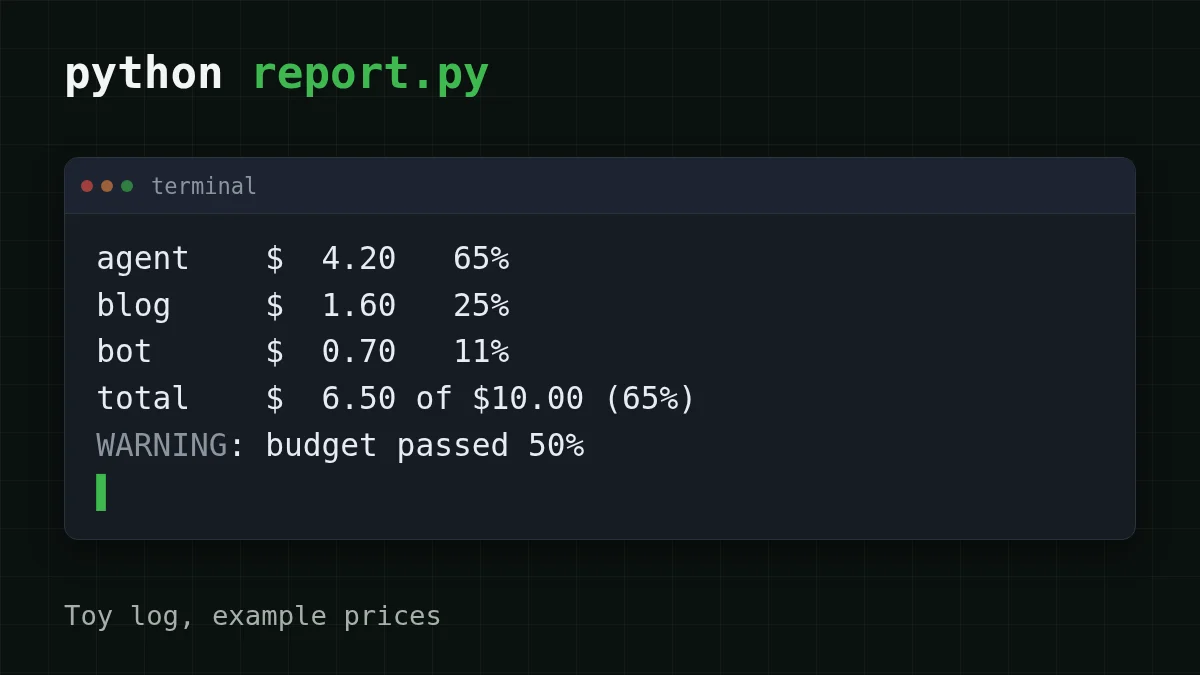
उदाहरण कीमतों और 10 के बजट के साथ, python report.py प्रिंट करता है:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
एजेंट बिल का लगभग दो-तिहाई है, और चेतावनी 50% पर आई, अंत में नहीं। इसे फिर से चलाएँ और चेतावनी तब तक शांत रहती है जब तक कुल 75% तक न पहुँच जाए।
इसे हर महीने काम कराने के लिए, आपको तीन चरण चाहिए:
चरण दर चरण
इसे तीन चरणों में जोड़ें
हर कॉल लॉग करें
अपने सभी कॉल ask(project, model, messages) के माध्यम से रूट करें और एक छोटा, स्थिर प्रोजेक्ट लेबल चुनें। महीने के बीच में लेबल का नाम बदलने से एक प्रोजेक्ट दो पंक्तियों में बँट जाता है।
कीमतें और बजट सेट करें
प्राइस टेबल से वर्तमान कीमतें PRICES में डालें, और अपनी सीमा एक्सपोर्ट करें: export BUDGET_।
इसे शेड्यूल पर चलाएँ
एक घंटेवार cron लाइन पर्याप्त है: 0 * * * * cd ~/। यदि आप चेतावनी अपने पास पुश करवाना चाहते हैं तो आउटपुट को मेल या चैट कमांड पर भेजें।
सस्ते मॉडल पर एक महीना कैसा दिखता है#
संख्याएँ तब उपयोगी होती हैं जब वे आपकी संख्याएँ हों। मान लें कि खिलौना लॉग का एजेंट प्रति चरण औसतन 30,000 इनपुट और 2,000 आउटपुट टोकन, प्रति कार्य 20 चरण, प्रति दिन दो कार्य लेता है। DeepSeek-V4-Flash पर एक चरण की लागत $0.00065 है; GLM-5.3-Flash पर, $0.00068। एक दिन 40 चरण है, एक महीना 1,200। अपने स्वयं के एजेंट से मेल खाने के लिए स्लाइडर घुमाएँ:
लागत कैलकुलेटर
एजेंट का एक दिन: प्रति कार्य चरण गुणा प्रति दिन कार्य
प्रति अनुरोध इनपुट टोकन: 30,000 · प्रति अनुरोध आउटपुट टोकन: 2,000 · प्रति दिन अनुरोध: 40
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
और 1,200 चरणों पर महीना, इनपुट और आउटपुट को एक साथ गिनते हुए:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,200 अनुरोध | OpenRouter, 1,200 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
प्रति अनुरोध 30,000 इनपुट और 2,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, दोनों मॉडल उस तालिका में OpenRouter की संदर्भ कीमतों से सस्ते निकलते हैं, किसी भी घंटे एक ही कीमत और कोई पीक सरचार्ज नहीं। DeepSeek-V4-Flash प्रति उत्तर 32,768 आउटपुट टोकन तक और 380K कॉन्टेक्स्ट की भी अनुमति देता है; GLM-5.3-Flash का कॉन्टेक्स्ट 390K है। एक बार रिपोर्ट दिखा दे कि कौन सा प्रोजेक्ट भारी है, केवल उस प्रोजेक्ट का model स्ट्रिंग बदलना एक-लाइन का बदलाव है, और एक बैलेंस हर मॉडल को कवर करता है। एक अनुरोध वास्तव में कितने टोकन उपयोग करता है, इसके लिए देखें how many tokens an API request uses; एक एजेंट रन को बीच में रोकने के लिए, देखें tracking AI agent token cost। कीमतें और मॉडल CheapTokens models page पर हैं।
यह कहाँ गलत होता है#
PRICESमें एक मॉडल गायब है। स्क्रिप्ट एकKeyErrorके साथ रुक जाती है जो मॉडल का नाम बताता है। इसे जोड़ें; शून्य पर डिफ़ॉल्ट न करें, वरना प्रोजेक्ट मुफ़्त दिखेगा।- स्ट्रीमिंग कॉल। अंतिम चंक उपयोग केवल तभी ले जाता है जब आप इसके लिए कहें (OpenAI SDK में
stream_)। अन्यथा आपके लॉग में अंतराल रहेंगे।options={"include_ usage": True} - विफल अनुरोध। केवल उन प्रतिक्रियाओं को लॉग करें जिनमें
usageऑब्जेक्ट हो; जो अनुरोध त्रुटि में समाप्त हुआ उसमें गिनने के लिए कुछ नहीं है। - प्रति-व्यक्ति रिपोर्ट। लेबल को प्रोजेक्ट या एजेंट नाम तक सीमित रखें। लोगों के बारे में रिपोर्ट गलत निष्कर्षों को आमंत्रित करती है।


