Traccia la spesa API per progetto e ricevi avvisi di budget in Python
Un breve script Python trasforma il tuo log di utilizzo in un report dei costi per progetto e avvisa al 50, 75, 95 e 100% di un budget mensile.
In questa pagina
Aggiungi una riga JSON a un file dopo ogni chiamata API, contrassegnala con il nome di un progetto e lascia che uno script Python di 30 righe trasformi quel file in un report dei costi per progetto e in un avviso al 50, 75, 95 e 100% del tuo budget mensile. È la stessa vista che Anthropic ha appena fornito ai team Claude Enterprise, costruita dal tuo log.
Supponiamo che un unico saldo alimenti un agente, uno script per redigere bozze di blog e un piccolo bot di supporto. Arriva la fine del mese, il saldo è più basso di quanto speravi e nulla ti dice quale dei tre l'ha consumato. È il vuoto che questo chiude.
Cosa ha rilasciato Anthropic e cosa puoi copiare#
L'annuncio di Anthropic (28 ottobre 2026) riguarda report intelligenti, sondaggi in-app e budget di gruppo condivisi, disponibili in generale solo sui piani Claude Enterprise (fonte). Due parti contano qui. Un report raggruppa il lavoro di un team in workstream e mostra la spesa di ciascuno. Un budget condiviso è un unico numero mensile condiviso, e gli amministratori di fatturazione ricevono un'email al 50%, 75%, 95% e 100% di esso. Anthropic aggiunge che i report servono a pianificare gli investimenti, non a giudicare le singole persone.
Non ti serve un piano enterprise per la stessa struttura. Un workstream è solo un'etichetta che scegli, e le quattro soglie sono una lista nel codice. Raggruppa per progetto, non per persona, per il motivo che indica Anthropic.
Verifica rapida
Il tuo saldo prepagato già blocca le richieste a zero. Perché aggiungere avvisi al 50% e al 75%?
Mostra risposta
Risposta: Perché zero è troppo tardi: vuoi accorgerti di un loop impazzito mentre ci sono ancora soldi per indagare
Il saldo è un blocco netto, non un allarme. Le soglie anticipate trasformano una sorpresa al 100% in una domanda al nono giorno.
Il log: una riga per richiesta#
Ogni risposta di chat completion porta un oggetto usage con prompt_tokens e completion_. È tutto ciò che serve al report, più un'etichetta di progetto che aggiungi tu. Questo wrapper invia la richiesta e aggiunge una riga a un file mensile (il nome del file cambia ogni mese, così un nuovo mese parte da zero):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Usa l'id completo del modello dalla documentazione CheapTokens (deepseek-, zai-); i nomi brevi delle tabelle dei prezzi non sono accettati dall'API. La chiave proviene da una variabile d'ambiente, mai dal file.
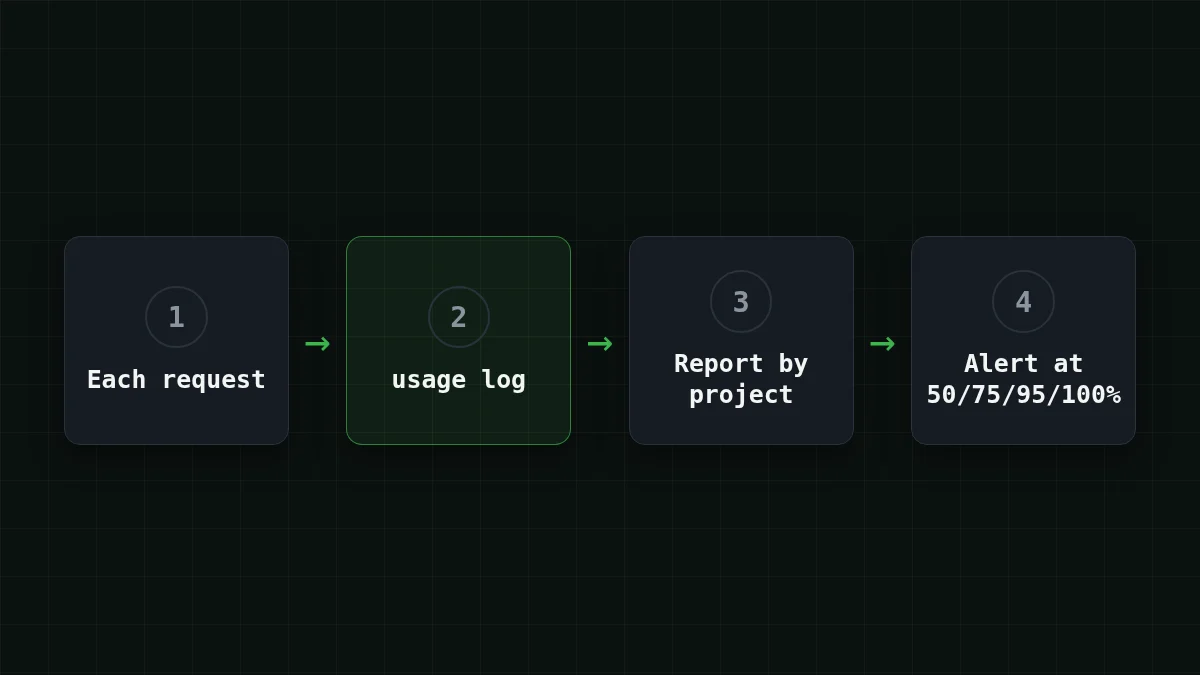
Lo script: costo per progetto e avvisi di soglia#
Salvalo come report.py. I prezzi sono segnaposto: copia quelli attuali dalla tabella dei prezzi (entrambi i modelli condividono qui un solo prezzo di esempio solo per mantenere leggibile l'aritmetica).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
Le ultime quattro righe sono la parte che si dimentica. Senza il piccolo file di stato, lo script griderebbe "superato il 50%" a ogni esecuzione per il resto del mese. Con esso, ogni livello scatta una sola volta.
Eseguilo e leggi il risultato#
Prendi un log di prova di quattro righe (uno reale ha una riga per richiesta, quindi migliaia):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
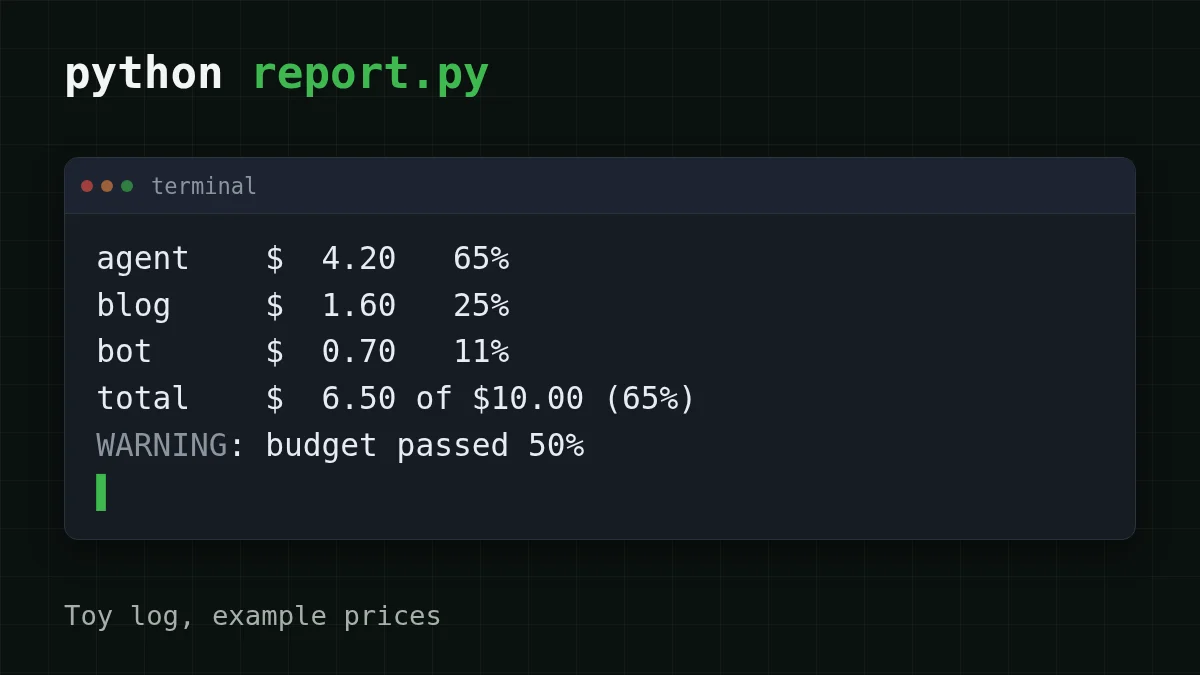
Con i prezzi di esempio e un budget di 10, python report.py stampa:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
L'agente è quasi due terzi della fattura, e l'avviso è arrivato al 50%, non alla fine. Eseguilo di nuovo e l'avviso resta silenzioso finché il totale non raggiunge il 75%.
Per farlo funzionare ogni mese, ti servono tre passaggi:
Passo dopo passo
Collegalo in tre passaggi
Registra ogni chiamata
Instrada tutte le tue chiamate attraverso ask(project, model, messages) e scegli un'etichetta di progetto breve e stabile. Rinominare le etichette a metà mese divide un progetto in due righe.
Imposta prezzi e budget
Metti i prezzi attuali dalla tabella dei prezzi in PRICES, ed esporta il tuo limite: export BUDGET_.
Eseguilo con una pianificazione
Una riga cron oraria è sufficiente: 0 * * * * cd ~/. Invia l'output a un comando di posta o chat se vuoi che l'avviso ti venga inviato.
Come appare un mese sui modelli economici#
I numeri diventano utili quando sono i tuoi numeri. Supponi che l'agente del log di prova faccia in media 30.000 token di input e 2.000 di output per passo, 20 passi per attività, due attività al giorno. Un passo su DeepSeek-V4-Flash costa $0.00065; su GLM-5.3-Flash, $0.00068. Un giorno sono 40 passi, un mese 1.200. Sposta i cursori per adattarli al tuo agente:
Calcolatore di costi
Un giorno dell'agente: passi per attività moltiplicati per attività al giorno
Token di input per richiesta: 30.000 · Token di output per richiesta: 2000 · Richieste al giorno: 40
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
E il mese a 1.200 passi, con input e output contati insieme:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1200 richieste | OpenRouter, 1200 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30.000 token di input e 2000 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In totale, con input e output contati insieme, entrambi i modelli risultano più economici dei prezzi di riferimento di OpenRouter in quella tabella, con un unico prezzo a qualsiasi ora e nessun sovrapprezzo di punta. DeepSeek-V4-Flash consente anche fino a 32.768 token di output per risposta e un contesto di 380K; GLM-5.3-Flash ha un contesto di 390K. Una volta che il report mostra quale progetto è quello pesante, cambiare solo la stringa model di quel progetto è una modifica di una riga, e un unico saldo copre ogni modello. Per sapere quanti token usa davvero una singola richiesta, vedi quanti token usa una richiesta API; per fermare un'esecuzione dell'agente a metà, vedi tracciare il costo in token di un agente AI. Prezzi e modelli sono nella pagina dei modelli CheapTokens.
Dove questo va storto#
- Manca un modello in
PRICES. Lo script si ferma con unKeyErrorche nomina il modello. Aggiungilo; non impostare zero come predefinito, o il progetto sembrerà gratuito. - Chiamate in streaming. L'ultimo chunk porta l'utilizzo solo se lo richiedi (
stream_nell'SDK OpenAI). Altrimenti il tuo log ha lacune.options={"include_ usage": True} - Richieste fallite. Registra solo le risposte che hanno un oggetto
usage; una richiesta che è andata in errore non ha nulla da contare. - Report per persona. Mantieni l'etichetta su un nome di progetto o agente. Un report sulle persone invita a conclusioni sbagliate.


